<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://about.gitlab.com/blog</id>
    <title>GitLab</title>
    <updated>2026-10-14T02:29:35.564Z</updated>
    <generator>https://github.com/jpmonette/feed</generator>
    <author>
        <name>The GitLab Team</name>
    </author>
    <link rel="alternate" href="https://about.gitlab.com/blog"/>
    <link rel="self" href="https://about.gitlab.com/pt-br/atom.xml"/>
    <subtitle>GitLab Blog RSS feed</subtitle>
    <icon>https://about.gitlab.com/favicon.ico</icon>
    <rights>All rights reserved 2026</rights>
    <entry>
        <title type="html"><![CDATA[Faça cada token de IA valer a pena com agentes]]></title>
        <id>https://about.gitlab.com/pt-br/blog/make-every-ai-credit-count/</id>
        <link href="https://about.gitlab.com/pt-br/blog/make-every-ai-credit-count/"/>
        <updated>2026-10-13T00:00:00.000Z</updated>
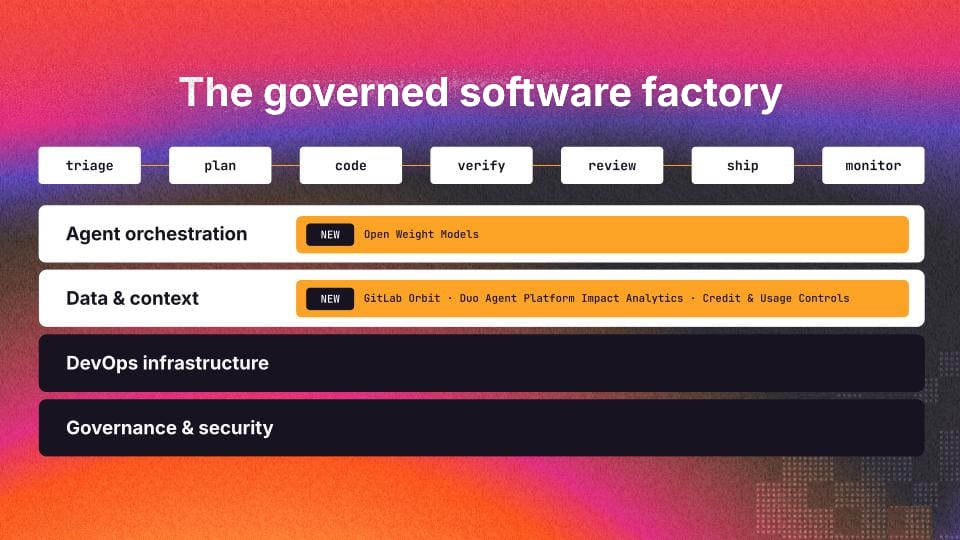
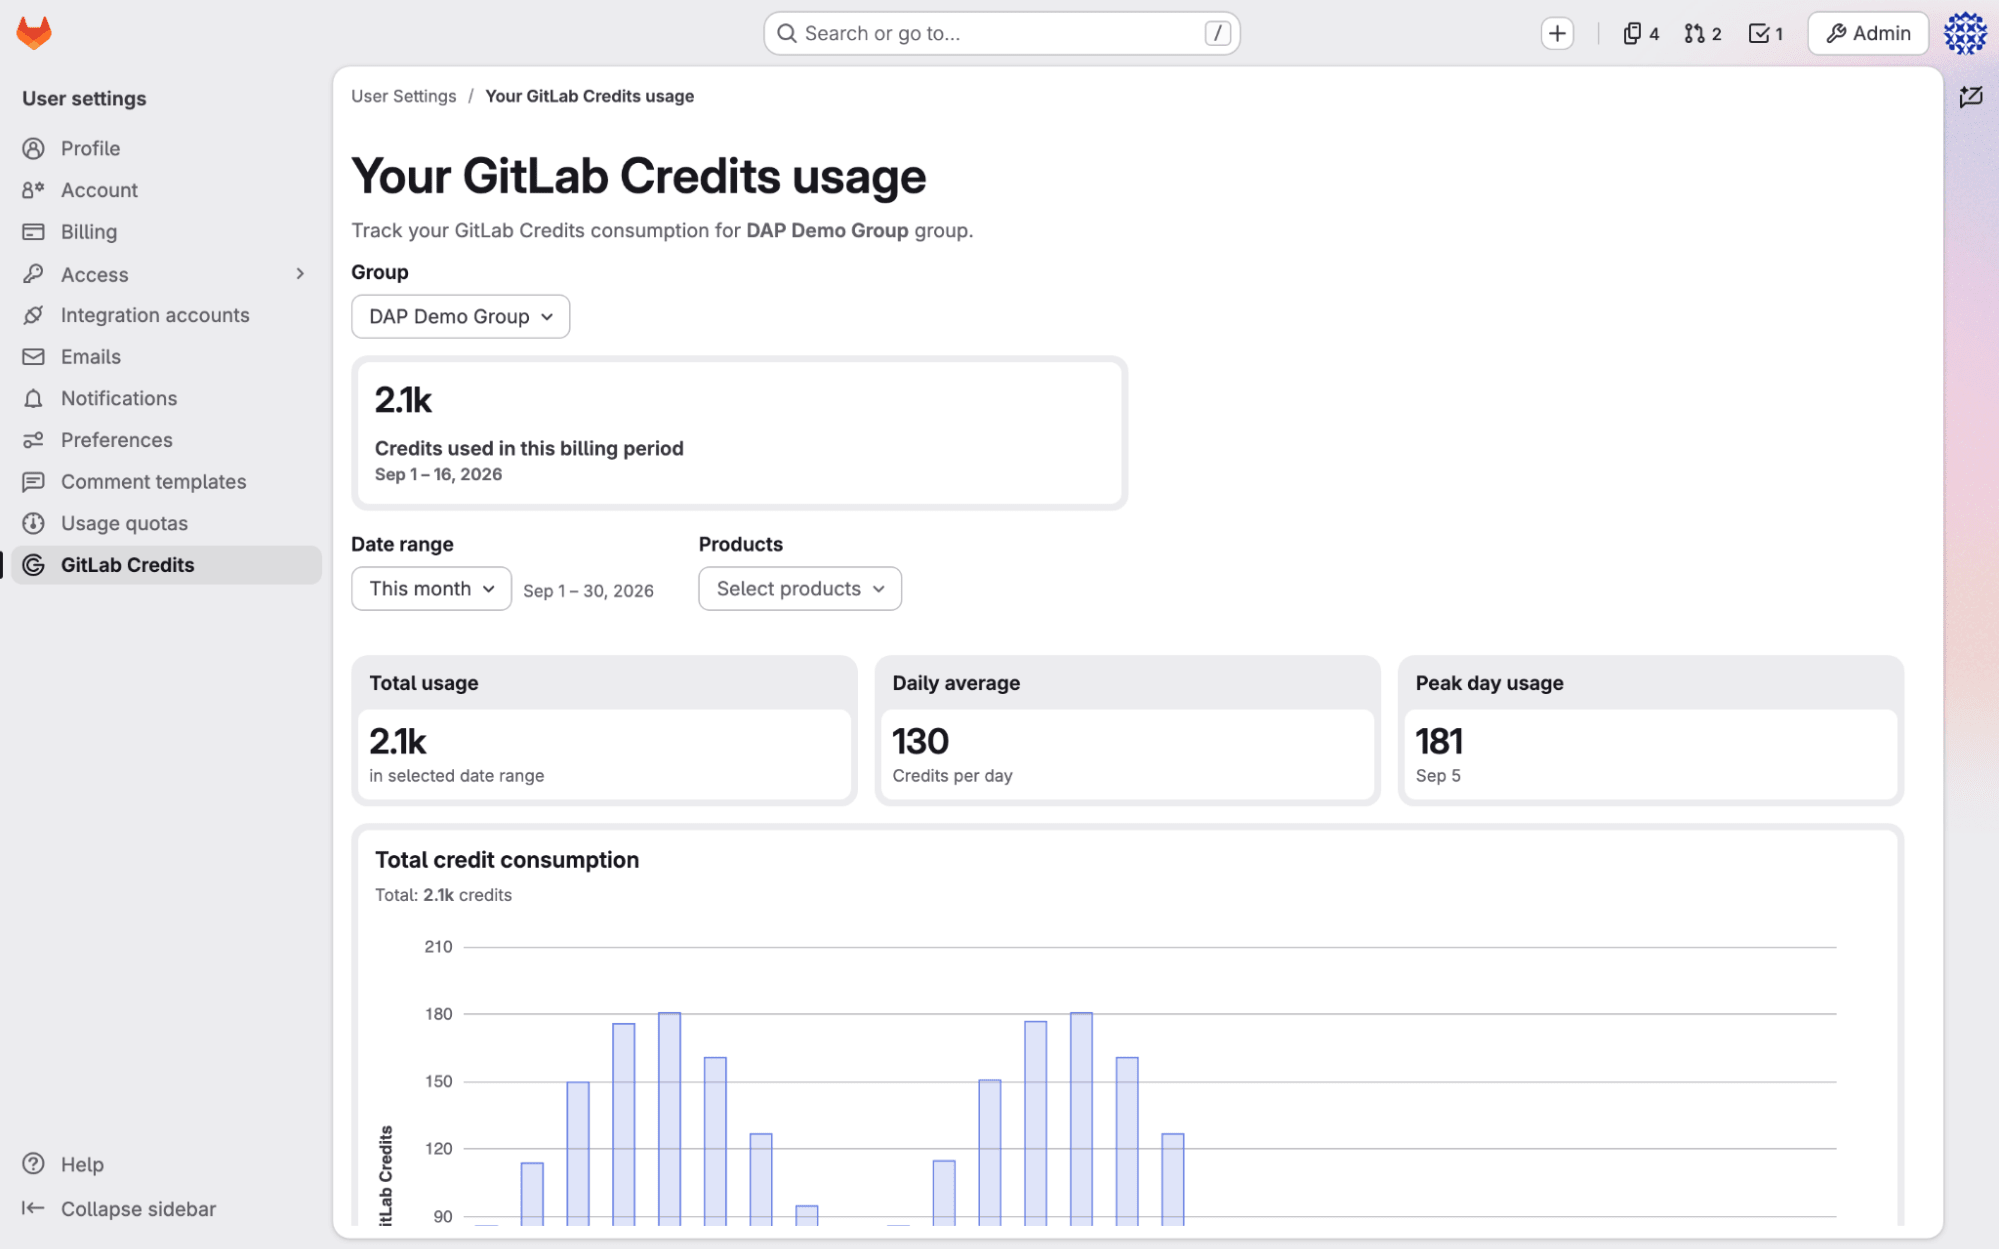
        <content type="html"><![CDATA[<p>Os custos se multiplicam a cada tarefa que você passa para um agente de IA. Cada tarefa consome tokens e créditos, e, à medida que os agentes se espalham pelos seus times e automações, o consumo pode crescer mais rápido do que o uso real. Se é você quem roda a plataforma, esse crescimento é de responsabilidade sua — incluindo quais times e fluxos de trabalho causam esse aumento, e se esse uso está realmente virando projetos entregues ou não.</p><p>No <a href="https://about.gitlab.com/pt-br/blog/transcend-india-announcements/" rel="">GitLab Transcend</a>, apresentamos a <a href="https://about.gitlab.com/press/releases/2026-10-06-gitlab-announces-the-foundation-for-the-governed-software-factory/" rel="">fábrica de software governada</a>, a nossa arquitetura para engenharia de software agêntica, e novas funções no GitLab Duo Agent Platform que trazem esse crescimento sob controle. Os <a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">modelos open-weight gerenciados pelo GitLab</a> alcançaram a mesma taxa de conclusão de tarefas dos modelos de ponta, por uma fração do custo, no benchmark do GitLab — então você pode alinhar o seu modelo à tarefa para melhorar a eficiência de custo do seu time. O <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> dá aos agentes o contexto do ciclo de vida do software, para que tentem menos vezes. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> e os <a href="https://about.gitlab.com/pt-br/blog/new-usage-caps-2026/" rel="">limites de créditos</a> mostram para onde os créditos estão indo e colocam um teto nesse gasto.</p><h2 id="controle-os-custos-na-fábrica-de-software-governada">Controle os custos na fábrica de software governada</h2><p>Um total de uso te diz o que você consumiu, mas deixa algumas perguntas difíceis em aberto: quanto do trabalho de rotina caiu em um modelo caro, quantas execuções de agente foram tentativas desperdiçadas, e quais usuários e times consumiram os créditos. Quando o dashboard só mostra tokens, os líderes de plataforma e engenharia acabam discutindo um número que nenhum dos dois lados consegue defender de verdade. Se você não consegue atribuir o uso, definir um limite e cortar o desperdício, não dá para otimizar nem justificar o seu gasto.</p><p>Quebrar esse padrão começa pela arquitetura. A fábrica de software governada é construída em camadas, e o custo cresce exatamente onde essas camadas não se conectam. Duas dessas camadas importam mais para o custo. A primeira é a orquestração de agentes, onde os modelos open weight colocam o trabalho de rotina em modelos de custo mais baixo. A outra é dados e contexto, onde o Orbit, o Duo Agent Platform Impact Analytics e os controles de crédito e uso dão a humanos e agentes o contexto necessário para produzir resultados de alta qualidade pelo menor custo possível.</p><p><img alt="A fábrica de software governada" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791898112/orfryk8astyh236ubwoi.png" title="A fábrica de software governada" /></p><p>Você consegue ver o problema em uma fábrica de software oculta, onde cada etapa tem a sua própria ferramenta, sem política ou contexto compartilhado entre elas. Os agentes gastam tokens procurando contexto em sistemas que nunca foram feitos para se integrar. Uma fábrica de software governada dá aos agentes contexto compartilhado, política compartilhada e um único lugar para medir quanto eles custam. Quando cada crédito de IA conta, você consegue:</p><ul><li><strong>Gastar menos créditos pelo mesmo trabalho:</strong> combine os modelos com a tarefa certa usando modelos open weight, e fundamente os agentes no contexto do ciclo de vida com o GitLab Orbit, para que tentem menos vezes.</li><li><strong>Rastrear o gasto até a origem:</strong> veja os créditos por usuário, time, tarefa e modelo no Duo Agent Platform Impact Analytics e no dashboard de GitLab Credits, para apontar o que gerou o crescimento.</li><li><strong>Definir um teto antes do próximo pico:</strong> limite o uso por usuário com os limites de crédito, com exceções quando necessário, para que os loops de agentes fiquem dentro dos limites que você define.</li></ul><h2 id="adeque-o-modelo-à-tarefa">Adeque o modelo à tarefa</h2><p>O custo dos agentes começa no preço de cada chamada de modelo. O <a href="https://docs.gitlab.com/user/duo_agent_platform/" rel="">GitLab Duo Agent Platform</a> permite fixar um modelo padrão por recurso e controlar o que os seus times podem usar: o seu próprio modelo, self-hosted ou do seu provedor, modelos de ponta gerenciados pelo GitLab, ou <a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">modelos open-weight gerenciados pelo GitLab</a>, novidade no GitLab 19.4.</p><p><a href="https://about.gitlab.com/blog/optimize-with-open-weight-models" rel="">Três modelos open-weight</a> agora estão hospedados no GitLab Duo Agent Platform: o GLM 5.3, o Kimi K3 e o MiniMax M3. No benchmark interno do GitLab com agentes Duo, o GLM 5.3 igualou a taxa de conclusão de tarefas do Claude Opus 5 a aproximadamente um quinto do custo, o Kimi K3 igualou o Claude Fable 5.1 a um terço do custo, e o MiniMax M3 igualou o GPT-5.5 a um oitavo do custo. A escolha do modelo é uma configuração de administrador. Nas configurações do GitLab Duo do seu grupo de nível superior, abra <strong>Model Selection</strong>, selecione <strong>Manage Models</strong> e fixe um modelo para cada recurso. Por exemplo, fixe o Kimi K3 no Agentic Chat e o MiniMax M3 nos agentes e flows, para que o trabalho de rotina não caia por padrão em um modelo de ponta. Os Group Owners também escolhem quais modelos os seus times podem usar.</p><h2 id="reduza-as-novas-tentativas-com-o-contexto-certo">Reduza as novas tentativas com o contexto certo</h2><p>A escolha do modelo define o preço de cada chamada, e as novas tentativas multiplicam o número de chamadas. O <a href="https://www.gartner.com/en/documents/8052533" rel="">Gartner</a> constatou que um time de 40 desenvolvedores gastou 23 vezes mais com IA porque os agentes ficavam tentando novamente sem as regras e o contexto certos. Os agentes tentam de novo quando não têm contexto. Em um monorepo ou em vários repositórios, um agente passa o primeiro trecho do trabalho vasculhando arquivos para entender o que se conecta com o quê, e cada nova tentativa reenvia toda a janela de contexto.</p><p>O <a href="https://docs.gitlab.com/orbit/remote/getting-started/" rel="">GitLab Orbit</a> mapeia o seu código, itens de trabalho, merge requests, pipelines, implantações e achados de segurança em um único grafo, que se mantém atualizado à medida que os seus times entregam software. Os agentes no GitLab Duo Agent Platform consultam esse grafo nativamente. Agentes externos, como o Claude Code e o Codex, se conectam por meio do Model Context Protocol (MCP), e ferramentas personalizadas se conectam pela API REST. Cada agente vê exatamente o que o seu usuário consegue ver no GitLab.</p><p>Com esse contexto, um agente consulta o grafo e recebe uma resposta precisa, mais rápido e com mais eficiência. Nos <a href="https://about.gitlab.com/blog/introducing-gitlab-orbit/" rel="">testes do GitLab</a>, a mesma tarefa no Claude Code precisou de até 45 vezes menos tentativas repetidas com o Orbit e, em um teste separado, usou 4,5x menos tokens para obter o contexto certo logo na primeira vez. O Orbit está em beta gratuito no GitLab.com hoje e chega à disponibilidade geral no próximo mês, em todas as opções de implantação.</p><h2 id="gerencie-o-que-você-consegue-medir">Gerencie o que você consegue medir</h2><p>Modelos e contexto reduzem o custo de cada tarefa. Os dados de impacto mostram se isso funcionou de verdade. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> responde às duas perguntas que os líderes de plataforma fazem: quanto estamos gastando, e onde esse gasto está concentrado? Ele detalha o gasto por <a href="https://gitlab.navattic.com/ai-impact?g=clylc6m40000009jp6k8ldgfd&amp;s=0" rel="">time, tarefa e modelo</a>, para os times e o período que você escolher, e mostra como um modelo open weight se compara com a sua combinação atual de modelos, para que você compare com dados em vez de chutar. O <a href="https://docs.gitlab.com/subscriptions/gitlab_credits_dashboard/" rel="">dashboard de GitLab Credits</a> adiciona mais detalhes abaixo do nível de time, rastreando o uso até o usuário e a sessão por trás dele.</p><p><img alt="Dashboard de GitLab Credits" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791897183/rqejadt1yd2jj3sx4jzz.png" title="Dashboard de GitLab Credits" /></p><p>Visibilidade anda lado a lado com limites. Sem um limite, a única alavanca que sobra é pedir para todo mundo usar menos. Os controles de crédito e uso definem limites no nível da assinatura, do grupo ou do usuário, com alertas em 50%, 80% e 100% do gasto, e uma pausa automática assim que o uso atinge o limite. Um limite fixo por usuário, como 1.000 créditos por usuário/mês, se aplica a todo integrante do time, e uma exceção individual, como 500 créditos adicionais, dá espaço para um engenheiro que está experimentando algo, sem precisar pedir mais créditos. Os limites por usuário entram em vigor assim que um usuário consome os créditos já incluídos no plano, e só o usuário que bateu no limite perde acesso aos recursos que consomem crédito, até o próximo ciclo de cobrança ou até que um administrador aumente o limite.</p><p>O Duo Agent Platform Impact Analytics mostra o consumo de crédito lado a lado com o trabalho que chega à produção, para que você veja se o uso está realmente virando trabalho entregue.</p><p>Veja o Duo Agent Platform Impact Analytics em ação nesta demonstração do nosso evento global Transcend:</p><iframe src="https://player.vimeo.com/video/1233524310?title=0&amp;byline=0&amp;portrait=0&amp;badge=0&amp;autopause=0&amp;player_id=0&amp;app_id=58479" frameBorder="0" allow="autoplay; fullscreen; picture-in-picture; clipboard-write; encrypted-media; web-share" referrerPolicy="strict-origin-when-cross-origin" style="position:absolute;top:0;left:0;width:100%;height:100%;" title="Transcend 3 Dasha Andushkina AI Impact and Cost_100626"></iframe><script src="https://player.vimeo.com/api/player.js"></script><h2 id="coloque-o-controle-de-custo-de-agentes-para-funcionar">Coloque o controle de custo de agentes para funcionar</h2><p>Comece a sua jornada de controle de custo de agentes pelo modelo. Os modelos open-weight gerenciados pelo GitLab já estão disponíveis para todos. No <a href="https://docs.gitlab.com/user/duo_agent_platform/model_selection/" rel="">Model Selection</a>, fixe o GLM 5.3, o Kimi K3 ou o MiniMax M3 para uma carga de trabalho de rotina, como um flow que roda em todo merge request.</p><p>Depois, reduza as tentativas repetidas. O <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> está em beta gratuito no GitLab.com hoje. Ative para o grupo que roda mais sessões de agente. O Orbit chega para todos no próximo mês, em todas as opções de implantação.</p><p>Em seguida, meça e defina limites. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> está em <a href="https://gitlab.com/gitlab-org/gitlab/-/work_items/632123" rel="">acesso antecipado</a>, para que você veja o gasto por time, tarefa e modelo. Os controles de crédito e uso já estão disponíveis de forma geral. Defina um <a href="https://docs.gitlab.com/subscriptions/gitlab_credits_dashboard/#set-flat-user-cap-and-per-user-overrides" rel="">limite por usuário para os GitLab Credits</a>, com exceções para os seus usuários mais intensivos. Depois de algumas semanas, compare o uso por time e por modelo com o período anterior.</p><p>Crie a base da sua fábrica de software com o <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a>. Se você é novo no GitLab, comece um <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">teste gratuito</a> do GitLab Duo Agent Platform. Se você já está no Premium ou no Ultimate, <a href="https://docs.gitlab.com/user/duo_agent_platform/turn_on_off/" rel="">ative o GitLab Duo Agent Platform</a> e use os GitLab Credits já incluídos na sua assinatura.</p>]]></content>
        <author>
            <name>Allie Holland</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/allie-holland/</uri>
        </author>
        <published>2026-10-13T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[GitLab Transcend: Velocidade em que você pode confiar, até a produção]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-india-announcements/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-india-announcements/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>No GitLab Transcend, fizemos mais de uma dezena de anúncios cobrindo as quatro camadas da nossa arquitetura para engenharia de software agêntica: orquestração de agentes, dados e contexto, fluxos de trabalho de DevOps, e governança e segurança. <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel=""><strong>Assista à gravação</strong></a><strong>, ou continue lendo para saber o que foi lançado e como ativar os novos recursos.</strong></p><h2 id="resumo-geral">Resumo geral</h2><table><thead><tr><th align="left">O que lançamos</th><th align="left">Status do lançamento</th><th align="left">O que faz</th></tr></thead><tbody><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/gitlab-duo-cli-drives-automation/" rel="">Fluxos orientados por objetivo</a> (<code>/goal</code>)</td><td align="left">GA neste mês</td><td align="left">Leve uma alteração para revisão, testes, verificações e aprovações, sem esperar entre as etapas do ciclo de vida do software.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/multi-step-software-delivery-with-agentic-flows/" rel="">Custom Flows</a></td><td align="left">GA</td><td align="left">Encadeie agentes para seguir o mesmo processo que os seus times já usam na entrega de software.</td></tr><tr><td align="left"><a href="https://docs.gitlab.com/user/project/integrations/gitlab_slack_application/#gitlab-duo" rel="">GitLab for Slack</a></td><td align="left">GA neste mês</td><td align="left">Inicie um fluxo agêntico a partir dos canais onde os seus times já trabalham.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/new-mcp-tools-for-automation/" rel="">Servidor MCP</a></td><td align="left">GA neste mês</td><td align="left">Conecte ferramentas e aplicações de IA com segurança aos fluxos de trabalho do GitLab, sob a mesma política.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">Modelos open weight</a></td><td align="left">GA</td><td align="left">Tenha desempenho comparável em cargas de trabalho mais econômicas com os modelos GLM 5.3, Kimi K3 e MiniMax 3, hospedados pelo GitLab.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a></td><td align="left">GA no próximo mês</td><td align="left">Dê aos seus agentes o conhecimento certo, o que exige cerca de 45x menos tentativas, com um grafo de contexto de todo o seu ciclo de vida de software.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">Duo Agent Platform Impact Analytics</a></td><td align="left">Acesso antecipado</td><td align="left">Meça o custo e o impacto do seu investimento em IA, por time, tarefa e modelo.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/new-usage-caps-2026/" rel="">Controles de crédito e uso</a></td><td align="left">GA</td><td align="left">Defina limites no nível da assinatura, do grupo e do usuário, e envie alertas sobre o gasto com IA.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a></td><td align="left">Beta</td><td align="left">Dê a cada pacote e container um único lugar governado, ao lado do código-fonte e do CI.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a></td><td align="left">Acesso antecipado</td><td align="left">Defina regras que bloqueiam, colocam em quarentena ou avisam sobre pacotes arriscados antes que cheguem ao seu build.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-secrets-manager/" rel="">GitLab Secrets Manager</a></td><td align="left">GA neste mês</td><td align="left">Restrinja segredos de build ao escopo do job e permite revogá-los com um clique.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">GitLab Security Standard</a></td><td align="left">Disponível hoje</td><td align="left">Fortaleça sua fábrica de software em cinco etapas e deixe seus agentes conquistarem autonomia.</td></tr><tr><td align="left">Novos flows com Claude Mythos 5 e 5.1</td><td align="left">GA no próximo mês</td><td align="left">Encontre e corrija vulnerabilidades no GitLab Duo Agent Platform com novos flows de segurança.</td></tr></tbody></table><h2 id="orquestração-de-agentes-em-todo-o-ciclo-de-vida-do-software">Orquestração de agentes em todo o ciclo de vida do software</h2><p>Hoje, cada etapa do seu fluxo de trabalho agêntico ainda espera a aprovação de uma pessoa antes que a próxima comece.</p><p>Os <a href="https://about.gitlab.com/blog/gitlab-duo-cli-drives-automation/" rel="">fluxos orientados por objetivo</a> pegam um objetivo declarado e o executam de ponta a ponta — passando por revisão, testes, verificações de segurança e aprovações — a partir da Duo CLI, do modo headless ou do Agentic Chat. Os <a href="https://about.gitlab.com/blog/flow-creator-agent/" rel="">fluxos personalizados</a> permitem encadear agentes para seguir o processo que o seu time já usa. O <a href="https://docs.gitlab.com/user/project/integrations/gitlab_slack_application/#gitlab-duo" rel="">GitLab for Slack</a> inicia um flow a partir do canal onde a conversa já está acontecendo. O <a href="https://about.gitlab.com/pt-br/blog/new-mcp-tools-for-automation/" rel="">Servidor MCP</a> permite que aplicações de IA externas e agentes de programação acessem a sua instância do GitLab com segurança, sob a mesma política que os seus próprios agentes seguem.</p><p>Os <a href="https://about.gitlab.com/blog/optimize-with-open-weight-models/" rel="">modelos open-weight hospedados pelo GitLab</a>, incluindo o GLM 5.3, o Kimi K3 e o MiniMax 3, oferecem uma opção de menor custo quando uma carga de trabalho não exige um modelo de ponta. Com taxas de conclusão de tarefa parecidas, algumas combinações de modelos open weight entregam até 8x mais chamadas de modelo por GitLab Credit, na comparação com seus equivalentes de ponta.</p><h2 id="dados-e-contexto-para-potencializar-o-raciocínio-humano-e-dos-agentes">Dados e contexto para potencializar o raciocínio humano e dos agentes</h2><p>Toda tarefa de agente começa recriando o mesmo contexto do zero, o que aumenta as tentativas repetidas e o uso de tokens. E sem uma visibilidade coerente sobre os custos e o ROI de IA, não dá para saber se o seu investimento está valendo a pena.</p><p>O <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a>, o grafo de contexto de todo o seu ciclo de vida de software, aumenta a precisão dos agentes com até 45 vezes menos tentativas repetidas, reduzindo na prática o custo dos fluxos de trabalho agênticos com até 4,5x menos uso de tokens. Durante o seu período de beta, o Orbit já foi usado por mais de 3.500 organizações, rodando mais de 280.000 consultas.</p><p>O <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">Duo Agent Platform Impact Analytics</a> mostra o custo e o impacto do seu investimento em IA por time, tarefa e modelo. Os controles de crédito e uso permitem definir limites no nível da assinatura, do grupo ou do usuário, com alertas em 50%, 80% e 100% do gasto, e uma pausa automática assim que o limite definido é atingido.</p><h2 id="infraestrutura-de-devops-na-escala-dos-agentes">Infraestrutura de DevOps na escala dos agentes</h2><p>A maior parte do que é entregue não é código escrito pelo seu time — é montada a partir de pacotes open source, imagens base e bibliotecas puxadas de todo lugar. Quando cada time mantém o próprio registry, não existe um lugar único para confirmar o que de fato foi publicado ou entregue.</p><p>No último mês de junho, durante o Transcend em Londres, apresentamos a nossa solução de <a href="https://about.gitlab.com/pt-br/early-access-preview/next-gen-source-control/" rel="">gerenciamento de código-fonte de próxima geração</a>, que ajuda você a alcançar uma escala automatizada com os seus agentes de programação. O próximo problema de das escalas automatizadas, porém, está na etapa seguinte ao código: o momento de criar um build.</p><p>O <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> substitui um registry separado por time por um único lugar para publicar e puxar pacotes, construído ao lado do seu código-fonte e dos seus pipelines de CI. Ele publica e puxa pacotes Maven, npm, Docker e OCI diretamente dos pipelines de CI, com PyPI e NuGet chegando na GA. O Artifact Central usa a mesma identidade e as mesmas permissões do seu código-fonte, com repositórios virtuais, autenticação nativa de CI/CD e procedência completa de build. Os primeiros resultados mostram um custo total de propriedade cerca de 50% menor, em comparação com ferramentas alternativas.</p><h2 id="governança-e-segurança-com-aplicação-centralizada">Governança e segurança com aplicação centralizada</h2><p>Os agentes puxam componentes de pacotes para o seu build na velocidade de máquina, o que torna impossível proteger manualmente tudo o que você entrega. Quando essa lacuna existe, você corre o risco de levar vulnerabilidades de segurança para a produção, em vez de pegá-las antes que afetem os clientes — e tem que responder por isso depois.</p><p>O <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a>, agora em acesso antecipado, define regras sobre idade do pacote, gravidade da vulnerabilidade, detecção de pacotes maliciosos e conformidade de licença, com ações para bloquear, colocar em quarentena ou avisar, aplicadas diretamente nos registries que você já usa. Ele funciona nativamente com o GitLab Artifact Central, e é compatível com o JFrog Artifactory e o Sonatype Nexus Repository.</p><p>Com um número maior de builds, surge outro risco: agentes herdando segredos de build a partir de ambientes de desenvolvimento locais que ninguém protegeu, e usando esses segredos em pipelines de CI. O <a href="https://about.gitlab.com/pt-br/gitlab-secrets-manager/" rel="">GitLab Secrets Manager</a> mantém cada segredo em um único lugar, restrito ao job que precisa dele, com revogação em um clique para uma credencial vazada e uma economia de até 50% em comparação com manter um repositório seguro separado.</p><p>Os mesmos modelos de IA que permitem aos agentes escrever e entregar código na sua própria velocidade também tornam mais rápido e mais barato descobrir, conectar e explorar falhas já existentes. O <a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">GitLab Security Standard</a> define cinco etapas para avaliar e reforçar a segurança do seu desenvolvimento de software agêntico: autorizar o acesso de cada agente, isolar workspaces e suas entradas, verificar os controles que avaliam o trabalho, liberar exatamente o que foi verificado e responder rapidamente quando existirem problemas — tudo isso construído sobre uma base de política, auditoria e responsabilidade. <a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">Leia o padrão completo</a> para o detalhamento completo.</p><p>Em breve, o Claude Mythos 5 e 5.1, da Anthropic, vão impulsionar os novos flows de segurança do GitLab Duo Agent Platform, ajudando organizações com ambientes aprovados a encontrar e corrigir vulnerabilidades mais rápido do que os atacantes conseguem descobri-las e explorá-las.</p><h2 id="como-comprar-com-o-gitlab-flex">Como comprar com o GitLab Flex</h2><p>A engenharia de software agêntica torna difícil prever, com seis meses de antecedência, o headcount, o consumo de créditos e as novas capacidades que você vai precisar. O <a href="https://about.gitlab.com/pt-br/gitlab-flex/" rel="">GitLab Flex</a> é um compromisso anual único que cobre as novas capacidades do GitLab assim que elas são lançadas, sem precisar de novos contratos de compra. Ele permite que os times reorganizem o gasto com estações e IA por meio de GitLab Credits, mês a mês, à medida que as necessidades mudam.</p><h2 id="por-onde-começar">Por onde começar</h2><ul><li>Ative o <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a>: clientes já existentes começam hoje mesmo, com créditos já incluídos na assinatura, e todo novo teste do GitLab inclui 30 dias de acesso. Para aumentar a eficiência dos seus agentes, ative o beta do <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a> para o GitLab.com.</li><li><a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">Adote o GitLab Security Standard</a>: o GitLab Ultimate está disponível em teste gratuito. Um <a href="https://docs.gitlab.com/ci/secrets/secrets_manager/credit_usage/#start-a-trial" rel="">teste do Secrets Manager</a> está disponível para clientes Ultimate e Premium. O <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> está aberto em beta, e você pode solicitar acesso antecipado ao <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">Dependency Firewall</a>.</li><li>Aproveite melhor cada real investido com o <a href="https://about.gitlab.com/pt-br/gitlab-flex" rel="">GitLab Flex</a>: um compromisso anual único para as novas inovações do GitLab, sem precisar de uma nova contratação — com a possibilidade de reorganizar o gasto com estações e GitLab Credits mês a mês.</li><li><a href="https://about.gitlab.com/pt-br/compare/gitlab-vs-github/" rel="">Se você está migrando do GitHub</a>, faça isso do seu jeito por meio de ferramentas de migração dedicadas, serviços de migração personalizados e uma oferta exclusiva: um ano de GitLab gratuito ao fechar um contrato de três anos.</li></ul><p>E se você já está pronto para começar a construir, participe do &quot;<a href="https://gitlab-transcend.devpost.com/" rel="">Life after code: the path to production at the speed of imagination</a>&quot;, o nosso hackathon de três semanas em parceria com a Anthropic e o Google Cloud.</p><p>Onde quer que você comece, o destino é o mesmo: a base de uma fábrica de software com governança, em que os agentes aceleram o trabalho e cada mudança permanece confiável.</p><p>Estamos ansiosos para ver o que você vai construir a seguir.</p>]]></content>
        <author>
            <name>Manav Khurana</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/manav-khurana/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Dependency Firewall: bloqueie pacotes arriscados antes do build]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
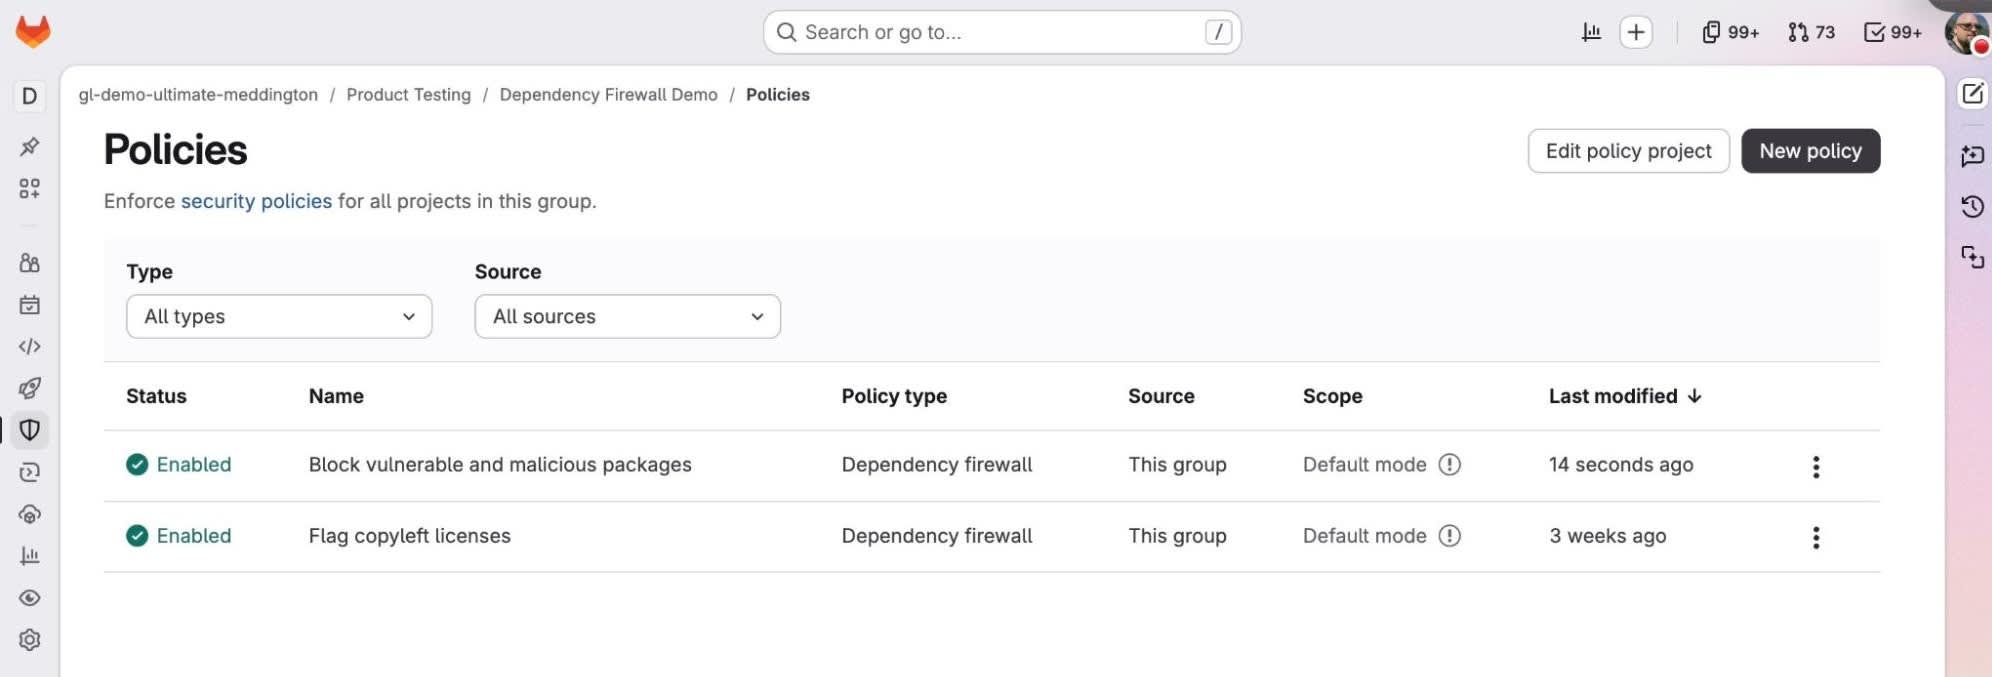
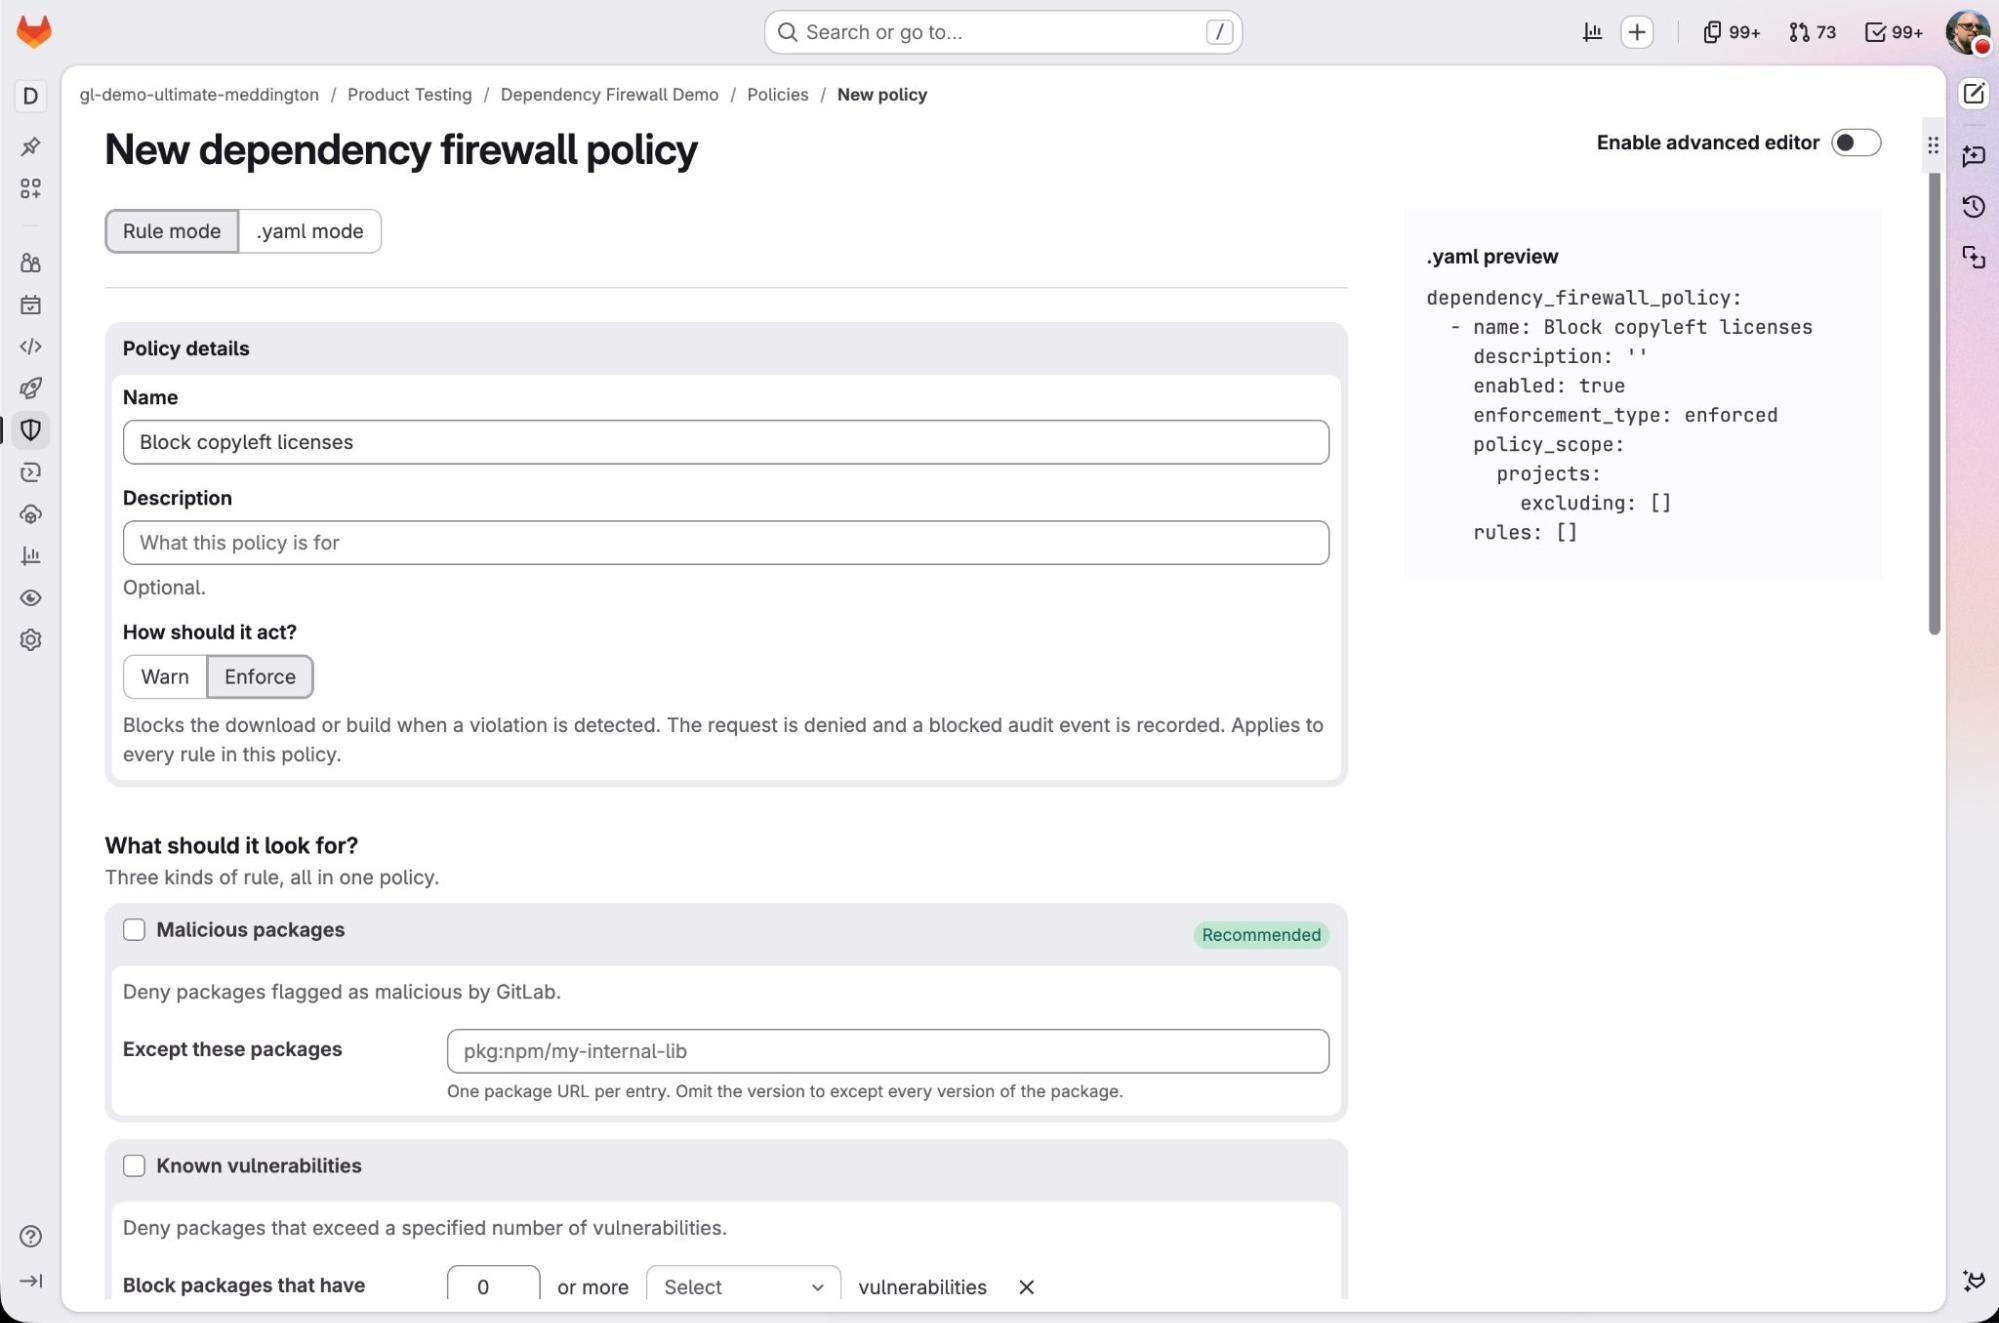
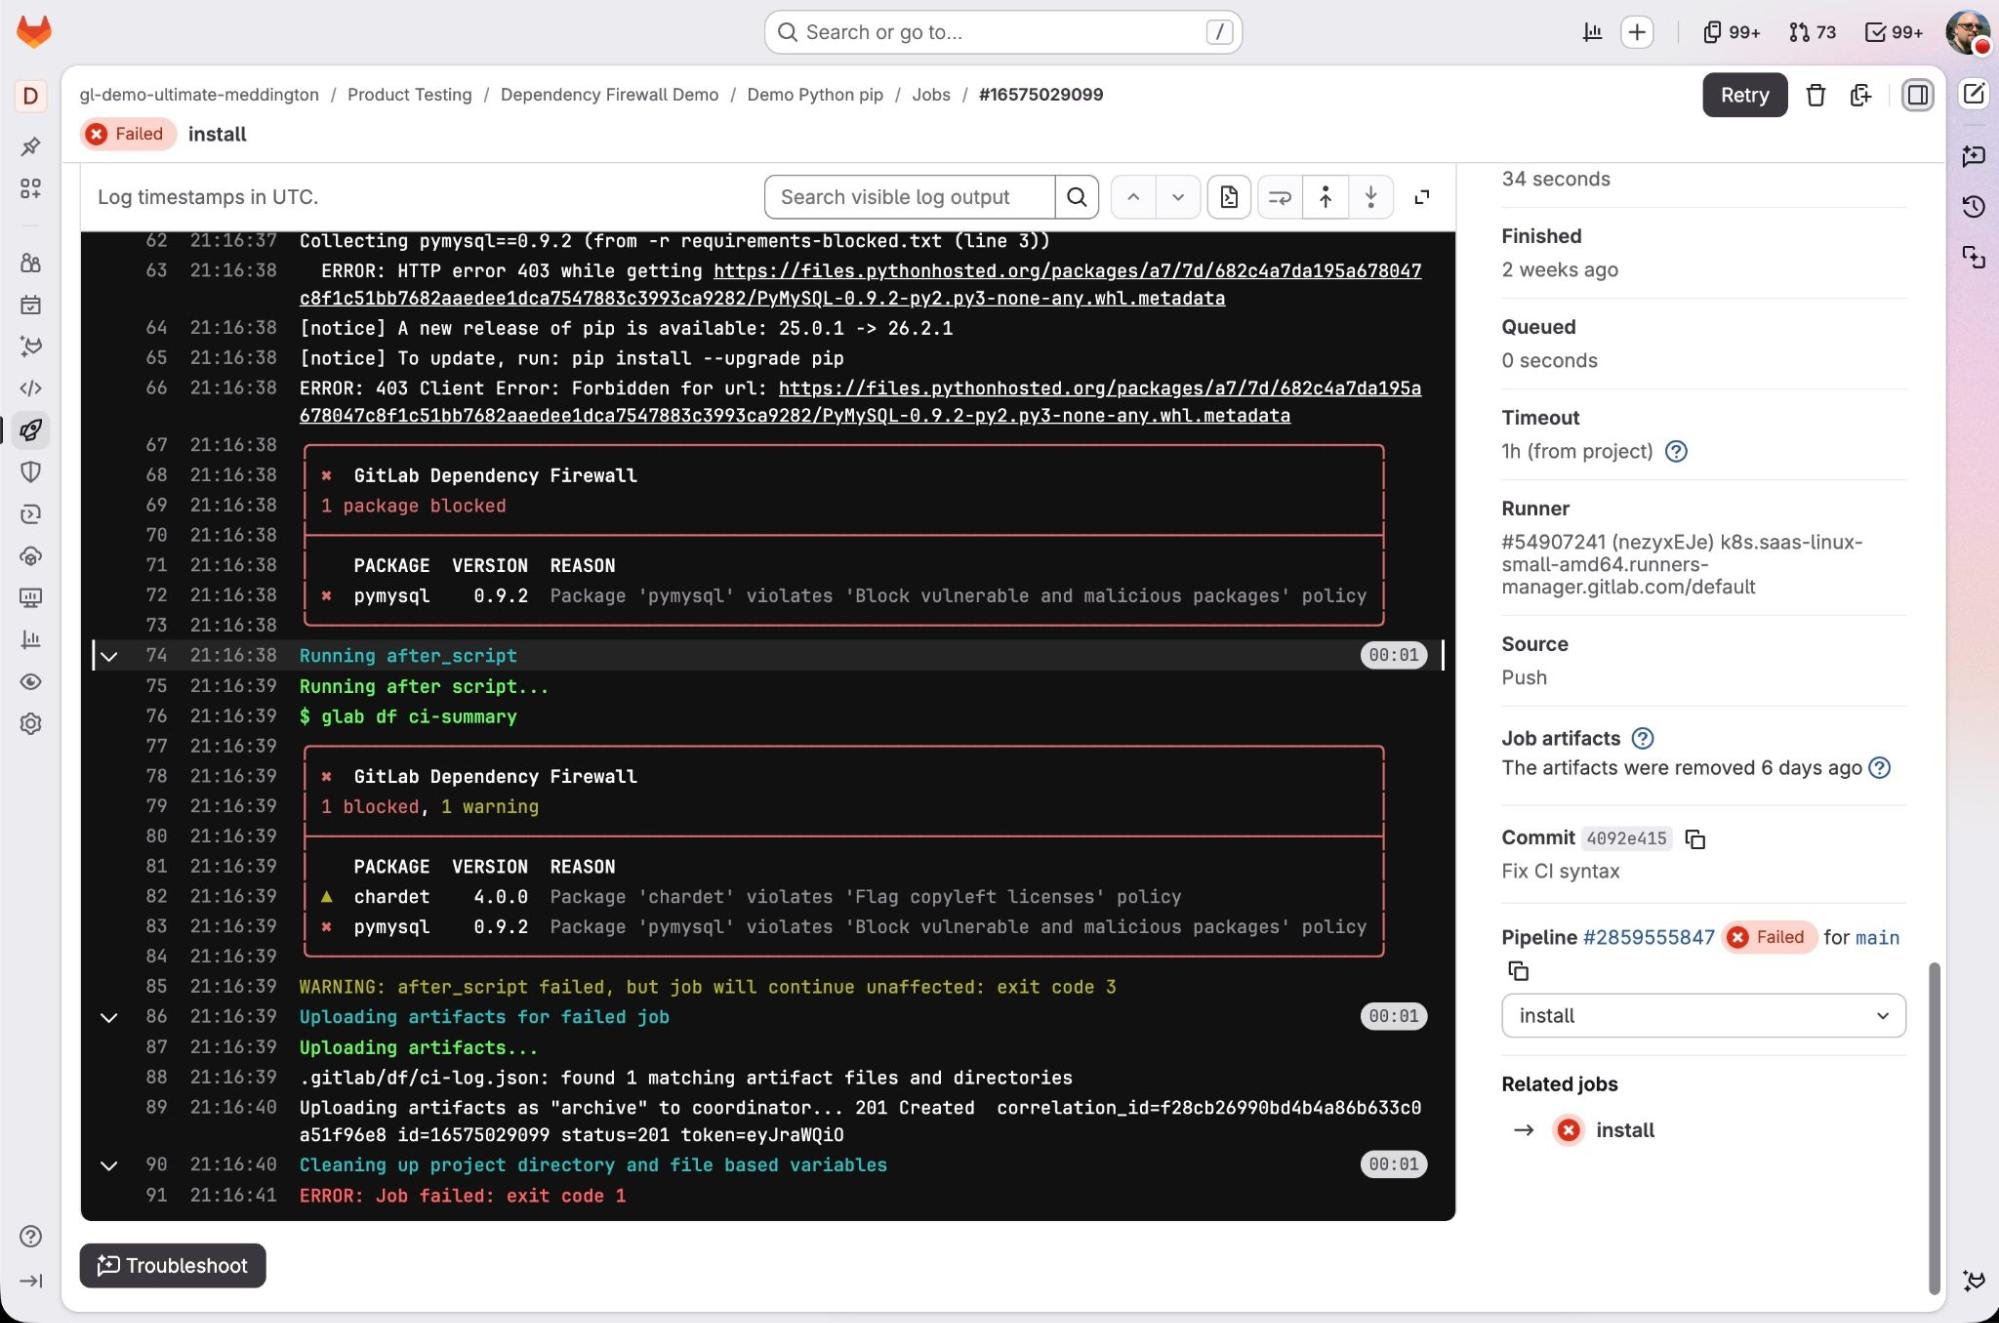
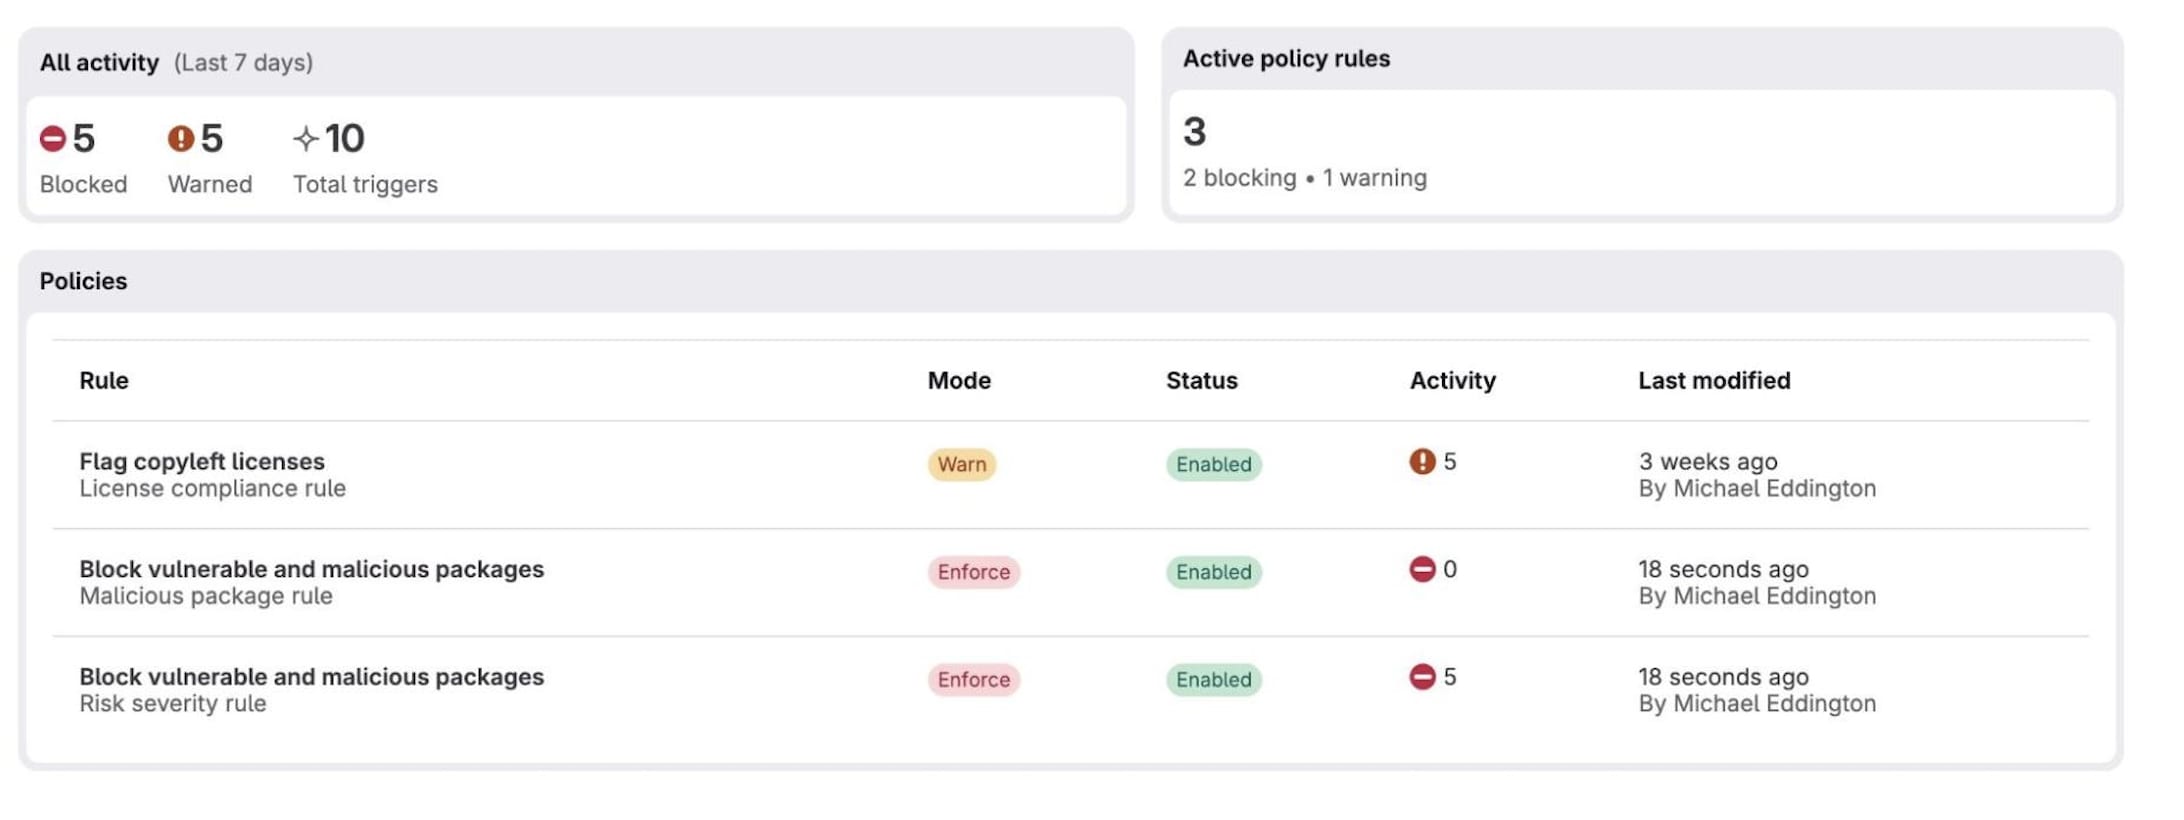
        <content type="html"><![CDATA[<p>Pacotes maliciosos podem aparecer disfarçados como pacotes confiáveis. Por exemplo, em junho de 2026, <a href="https://about.gitlab.com/pt-br/blog/gitlab-discovers-widespread-npm-supply-chain-attack/" rel="">pesquisadores do GitLab encontraram cinco pacotes maliciosos no PyPI</a>, quatro deles typosquats do Flask, Requests e NumPy, que são executados no momento da instalação e roubam credenciais de CI/CD. E isso importa, já que agentes de IA agora adicionam dependências de código aberto por conta própria, muitas vezes sem revisão, e os desenvolvedores perdem a visibilidade sobre quais pacotes podem contaminar o build.</p><p>Essa combinação abre uma brecha real: um pacote malicioso ou vulnerável pode entrar no seu build sem qualquer autorização. Uma vez lá dentro, o código desse pacote roda com o mesmo acesso que o seu pipeline tem, e a partir daí consegue alcançar qualquer sistema que os seus pipelines de desenvolvimento tocam.</p><p>O <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a>, apresentado hoje no Transcend em acesso antecipado, bloqueia pacotes que batem com a sua política — maliciosos, vulneráveis ou fora de conformidade — antes que eles cheguem ao seu build. Com a governança embutida, a ferramenta impede o risco antes mesmo da instalação, o que libera a sua equipe do processo de rastrear, remover ou refazer o que uma política bloqueia. Desenvolvedores e seus agentes continuam puxando as dependências de que precisam sem esperar por uma revisão manual de segurança, e os pacotes que atendem à sua política passam a fazer parte do seu build oficial.</p><blockquote><p>Assista à <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel="">gravação do nosso evento Transcend</a> para ver demonstrações dos novos recursos da plataforma e entender o que é preciso para levar a velocidade da IA agêntica a todo o ciclo de vida do software.</p></blockquote><h2 id="bloqueie-pacotes-maliciosos-sem-quebrar-o-seu-build">Bloqueie pacotes maliciosos sem quebrar o seu build</h2><p>Sem uma política no momento da instalação, um pacote problemático entra no build primeiro e só é pego depois. A análise de composição de software (Software composition analysis - SCA) verifica o que você já trouxe para o projeto — então, quando ela sinaliza um pacote malicioso, uma vulnerabilidade de alta gravidade ou uma licença que o seu time jurídico não aceita, a dependência já está instalada e pode até já ter sido entregue dentro de um artefato. Rastrear até onde ela foi, removê-la e reconstruir o build transforma uma execução de rotina do pipeline em um trabalho extra e não planejado para o seu time de engenharia.</p><p>Com o Dependency Firewall, você decide o que pode entrar nos seus builds antes mesmo da instalação, definindo políticas para:</p><ol><li><strong>Status malicioso</strong> — pacotes sinalizados no <a href="https://docs.gitlab.com/user/application_security/gitlab_advisory_database/#gitlab-malware-advisories" rel="">banco de dados de avisos de malware do GitLab</a></li><li><strong>Gravidade da vulnerabilidade</strong> — a gravidade que você define (crítica, alta, média ou baixa) e quantas ocorrências você permite nesse nível, incluindo zero</li><li><strong>Tipo de licença</strong> — quais licenças você permite ou recusa, listadas pelo nome completo, e como tratar pacotes cuja licença não pode ser identificada</li><li><strong>Idade do pacote</strong> — a idade mínima que um pacote precisa ter antes de entrar em um build, para que uma versão publicada minutos atrás não entre direto sem que ninguém a tenha analisado</li></ol><p>Colocar essa política em prática não precisa colocar a sua entrega em risco. Comece no modo de aviso: o firewall registra o que uma política capturaria, mas deixa o build seguir normalmente. Ele grava um evento de auditoria, uma entrada no dashboard e uma linha no resumo do CI, para que você possa avaliar se vale a pena bloquear o build ou não.</p><p>Depois que você confiar nas políticas, mude para o modo de bloqueio: o pipeline para assim que encontra uma correspondência e mostra o motivo. Quando alguém realmente precisa liberar um pacote já aprovado, um bypass registrado permite que um usuário ou token autorizado prossiga — tudo fica no histórico.</p><p><img alt="Aplicação de políticas de segurança" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/smilnde9xskkyon7rzyn.jpg" title="Aplicação de políticas de segurança" /></p><h2 id="defina-a-política-uma-vez-ou-personalize-por-time">Defina a política uma vez ou personalize por time</h2><p>Um firewall que só atua no nível do registro dá a mesma política para todo mundo, mas isso raramente combina com a forma como os times realmente trabalham. Um serviço de pagamentos e um protótipo interno carregam perfis de risco bem diferentes, e um único conjunto de regras para todo o registro não consegue exigir mais de um do que do outro.</p><p>Com o Dependency Firewall, você define uma política no grupo de nível superior, e todo projeto abaixo dele herda as mesmas regras. Quando um time precisa de algo diferente, você pode definir uma política específica para aquele grupo ou projeto.</p><p>Dá para aplicar a regra no nível do registro e governar toda a organização a partir de uma única plataforma, sem abrir mão da possibilidade de apertar as regras onde o risco é maior. As regras vivem como código em um projeto de política de segurança, então são revisadas e alteradas por meio de uma solicitação de merge, como o resto da sua configuração. Elas são herdadas do grupo de nível superior até serem passadas para cada projeto, e, quando as regras se sobrepõem, vale a mais restritiva. Um serviço crítico pode ficar acima da régua-base da organização, e nenhum projeto fica abaixo dela.</p><p><img alt="Nova política do dependency firewall" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/aykp66qb64pskauvzbmm.jpg" title="Nova política do dependency firewall" /></p><h2 id="verifique-um-pacote-antes-de-trazê-lo-para-o-projeto">Verifique um pacote antes de trazê-lo para o projeto</h2><p>Um desenvolvedor — ou um agente realizando o trabalho — geralmente só descobre que um pacote não é permitido quando o pipeline falha. Isso custa um ciclo inteiro de build e quebra a concentração bem na hora em que o trabalho está fluindo.</p><p>Com o GitLab Dependency Firewall, você já sabe a resposta antes de adicionar uma dependência, direto no lugar onde já está trabalhando — e consegue escolher um pacote que passa de primeira.</p><p>Usando a GitLab CLI no terminal ou em um script, uma verificação por linha de comando já diz se um pacote vai passar ou ser bloqueado pela sua política, sem que o desenvolvedor precise abrir um console separado. Ela cobre gerenciadores de pacotes comuns, como npm, pip, Poetry, Maven, Gradle e Bundler, com mais integrações a caminho.</p><p><img alt="Use a linha de comando para identificar se um pacote vai passar ou ser bloqueado pela sua política" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/itqcvrmp8gvw1phihd2l.jpg" title="Use a linha de comando para identificar se um pacote vai passar ou ser bloqueado pela sua política" /></p><h2 id="veja-e-comprove-cada-decisão">Veja e comprove cada decisão</h2><p>Um líder de segurança precisa conseguir provar o que um controle está fazendo durante uma auditoria. Um controle que bloqueia silenciosamente, sem deixar registro, não responde à pergunta do auditor e não constrói confiança com os times que ele governa.</p><p>Você tem uma visão única de tudo o que o firewall já permitiu, avisou e bloqueou, com um registro imutável de cada decisão que pode ser entregue a um auditor.</p><p>O dashboard do Dependency Firewall mostra a atividade e os resultados de todos os projetos dentro do escopo definido. Cada aviso, bloqueio ou bypass gera um evento de auditoria que registra a regra correspondente, a política por trás dela e o pacote envolvido.</p><p><img alt="Dashboard do Dependency Firewall" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198871/oiieystaargq3ctrqfs1.jpg" title="Dashboard do Dependency Firewall" /></p><h2 id="tenha-acesso-antecipado-ao-gitlab-dependency-firewall">Tenha acesso antecipado ao GitLab Dependency Firewall</h2><p>Agora você pode travar pacotes maliciosos, vulneráveis ou fora de conformidade antes que cheguem a um build. A solução é compatível com o <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> e com registros externos do Sonatype Nexus Repository e do JFrog Artifactory, e não exige manter uma ferramenta separada ao lado da sua implantação do GitLab. O Dependency Firewall já está em acesso antecipado para clientes GitLab.com e GitLab Self-Managed nos planos Premium ou Ultimate. <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">Solicite seu acesso antecipado agora mesmo!</a></p>]]></content>
        <author>
            <name>Alisa Ho</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/alisa-ho/</uri>
        </author>
        <author>
            <name>Amit Shalem</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/amit-shalem/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[GitLab Artifact Central: entregue certo na primeira vez]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-artifact-central/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
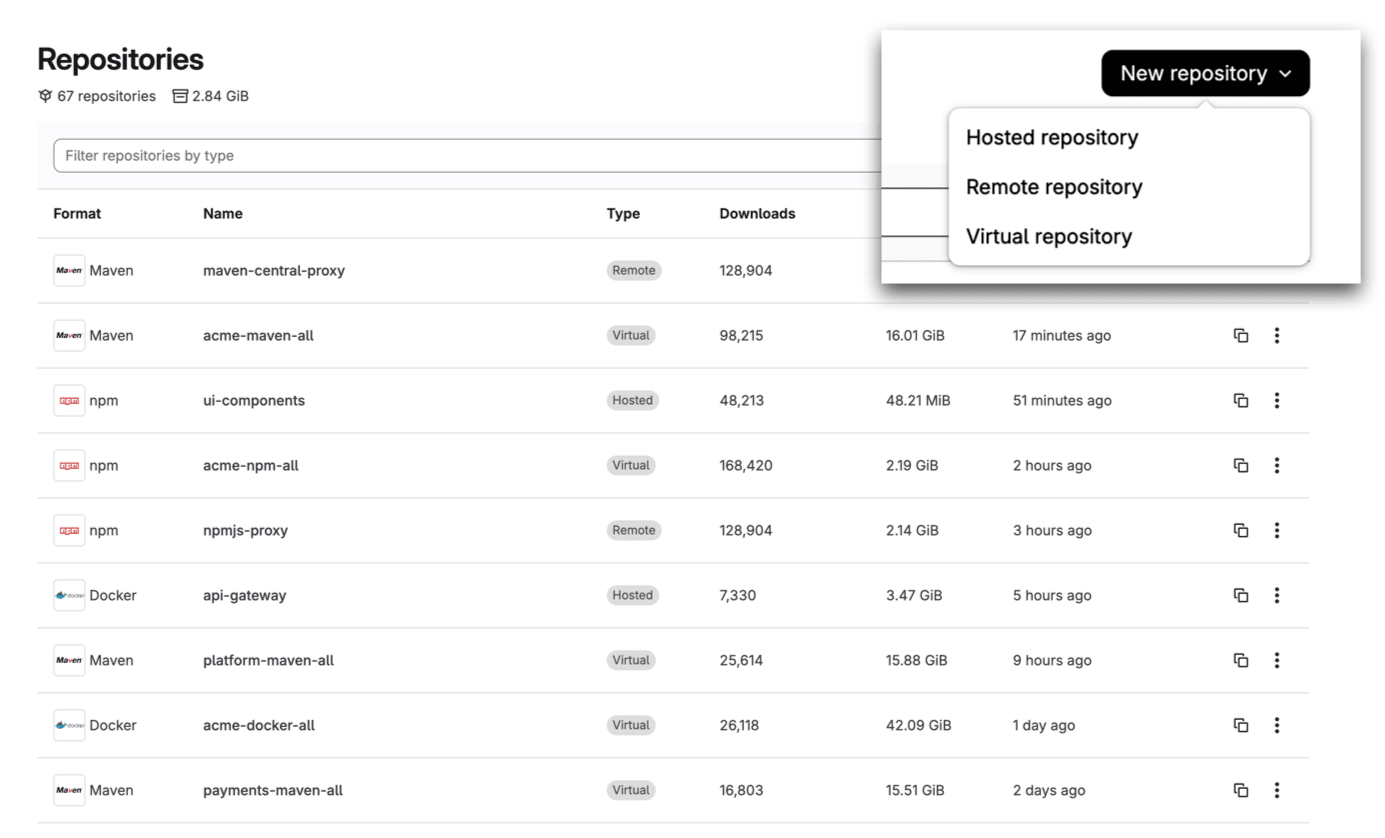
        <content type="html"><![CDATA[<p>Todo build de software é montado a partir de pacotes open source, imagens base e bibliotecas, com o seu código por cima. Quando um desses componentes falta ou tem um comportamento diferente do esperado, o build falha. Quando o desenvolvimentoa acontece na velocidade dos agentes, essas falhas se multiplicam, e nenhum time consegue mais resolvê-las como exceções manuais.</p><p>A proliferação dos registries de cada projeto só piora o quadro, porque as regras de retenção, os limites de armazenamento e o acesso de publicação vivem separados dentro de cada um deles. Esse design por projeto funciona quando uma pessoa configura cada registry manualmente, mas quebra quando agentes rodam continuamente em centenas de projetos.</p><p>Hoje, no GitLab Transcend, anunciamos o GitLab Artifact Central: um único registry no nível da organização que substitui centenas de registries no nível de projeto, de forma que todo pull ou publish feito por uma pessoa ou por um agente passe pela mesma porta de entrada controlada, permitindo que os times de plataforma desenvolvam o software certo desde a primeira vez.</p><p>Veja a seguir por que desenvolvemos o Artifact Central e como ele pode ajudar o seu time.</p><iframe src="https://player.vimeo.com/video/1230298162?title=0&amp;byline=0&amp;portrait=0&amp;badge=0&amp;autopause=0&amp;player_id=0&amp;app_id=58479" frameBorder="0" allow="autoplay; fullscreen; picture-in-picture; clipboard-write; encrypted-media; web-share" referrerPolicy="strict-origin-when-cross-origin" style="position:absolute;top:0;left:0;width:100%;height:100%;" title="GL_Artifact Central 1_092226_v4"></iframe><script src="https://player.vimeo.com/api/player.js"></script><h2 id="defina-a-política-uma-vez-aplique-em-todo-lugar">Defina a política uma vez, aplique em todo lugar</h2><p>No GitLab, as regras de retenção, os limites de armazenamento e quem pode publicar vivem dentro do registry de pacotes e containers gratuito de cada projeto, configurados de forma isolada. O GitLab Artifact Central leva essa tarefa um nível acima. Os times atribuem regras de retenção, configurações de cota e políticas de acesso uma única vez, no nível da organização, em vez de recriá-las em cada projeto abaixo dela.</p><p>Todo repositório vem fechado por padrão: ser membro da organização é o portão, não a chave. Isto é, fazer parte da organização sozinho não libera nenhum repositório até que uma permissão para esse acesso seja concedida. Criamos quatro papéis específicos para artefatos: Admin, Manager, Contributor e Viewer. Esses papéis ficam separados dos papéis de projeto que já existem no GitLab, então dar acesso a alguém em um repositório nunca afeta ou altera os privilégios dessa pessoa em nenhum outro lugar.</p><h2 id="uma-única-url-para-publicar-fazer-proxy-ou-os-dois">Uma única URL para publicar, fazer proxy ou os dois</h2><p>Em vez de navegar por uma página de wiki interna explicando onde está cada componente, os desenvolvedores apontam uma única URL para tudo. O GitLab Artifact Central faz isso por meio de três tipos de repositório:</p><ul><li><strong>Hosted —</strong> os pacotes e imagens privados que os seus times constroem e publicam.</li><li><strong>Remote —</strong> um proxy na frente de uma fonte externa, como o Docker Hub ou o Maven Central, com a conexão testada antes que qualquer coisa dependa dela.</li><li><strong>Virtual —</strong> um único endpoint que reúne repositórios hosted e remote. O GitLab verifica primeiro o repositório hosted, e só depois recorre à fonte remote. O primeiro pull externo fica em cache, então os pulls seguintes vêm direto do GitLab, sem precisar se conectar à internet.</li></ul><p>Os repositórios virtuais importam especialmente para os times que comparam o GitLab com outras soluções de gestão de artefatos. Eles dão aos desenvolvedores a experiência familiar de um único endpoint, sem que precisem pensar onde o artefato realmente está. Ou seja, tenha sido construído internamente ou puxado de um registry externo, o desenvolvedor solicita da mesma forma. Durante o período de beta, o Artifact Central é compatível com Maven, npm, Docker e OCI, com mais formatos a caminho.</p><p><img alt="Artifact Central" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791239267/zfd9zisjm0gqkj5relb9.png" title="Artifact Central" /></p><h2 id="rastreie-qualquer-coisa-de-volta-à-origem-automaticamente">Rastreie qualquer coisa de volta à origem, automaticamente</h2><p>Aqui está a parte difícil de replicar fora do GitLab: todo artefato publicado pelo GitLab Artifact Central carrega a sua procedência de build automaticamente, ou seja, qual pipeline o construiu, de qual branch e commit ele veio e quem disparou o job. Como é a mesma plataforma que rodou o build, o registry já sabe disso.</p><p>A autenticação funciona da mesma forma. Publicar e puxar pacotes usa o <code>CI_JOB_TOKEN</code>, a identidade que os seus pipelines já têm, tanto para pessoas quanto para agentes. Um agente que publica ou puxa pacotes por meio de pipelines de CI usa exatamente esse mesmo job token, e não uma conta de serviço integrada por fora, com permissões separadas. Com um registry independente, rastrear um artefato até a sua origem significa correlacionar IDs manualmente entre o seu sistema de CI e o seu registry, usando um script que alguém precisa manter. Com o Artifact Central, o pipeline, a branch, o commit e o job já vêm anexados ao próprio artefato.</p><h2 id="responda-o-que-publicamos-em-segundos">Responda &quot;o que publicamos?&quot; em segundos</h2><p>O Artifact Central vive na mesma plataforma que o seu código, suas solicitações de merge e seus pipelines, então os artefatos publicados a partir do CI carregam sua procedência de build: o pipeline que os construiu, o commit e quem os publicou.</p><p>Em breve, planejamos conectar isso em toda a sua organização por meio do <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a>, de forma que &quot;quais dos meus serviços em produção são afetados por essa vulnerabilidade?&quot; vire uma pergunta com uma resposta só ao invés de uma busca manual em quatro ou cinco ferramentas diferentes.</p><h2 id="combine-o-artifact-central-com-o-dependency-firewall">Combine o Artifact Central com o Dependency Firewall</h2><p>O <a href="https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/" rel="">GitLab Dependency Firewall</a>, um produto separado do GitLab, disponível em acesso antecipado para clientes Premium e Ultimate, já funciona de forma nativa com o Artifact Central. Com o Dependency Firewall, você consegue barrar pacotes arriscados antes mesmo de eles chegarem a um build. Você adiciona essa verificação a cada pipeline usando a CLI <code>glab</code>, então a cobertura acontece pipeline a pipeline, não importa qual gerenciador de pacotes os seus times usem. Em seguida, planejamos permitir uma integração ainda mais estreita entre as duas capacidades, de forma que uma única política para toda a sua organização bloqueie pacotes arriscados por vulnerabilidade, licença ou idade do pacote, no exato momento em que são puxados.</p><h3 id="dois-benefícios-do-mesmo-registry">Dois benefícios do mesmo registry</h3><p>Veja como isso funciona na prática para dois perfis: o desenvolvedor que entrega o código e o time de plataforma que garante que tudo se sustente.</p><p><strong>Um desenvolvedor publicando a partir do CI.</strong> O seu pipeline publica um artefato Maven usando o job token que ele já tem, sem nenhum segredo novo para gerenciar. Se esse mesmo desenvolvedor precisar de um pacote interno ao lado de algo vindo do Maven Central, basta apontar para uma única URL de repositório virtual e deixar que o GitLab Artifact Central descubra onde cada um realmente reside.</p><p><strong>Um time de plataforma definindo a política uma única vez.</strong> Em vez de configurar regras em centenas de projetos separados, um admin define cotas de armazenamento e regras de acesso a repositórios no nível da organização, uma única vez — e todo repositório abaixo dela herda essa configuração. Quando alguém pergunta quanto e onde a empresa está armazenando, existe um único dashboard com a resposta.</p><h3 id="migrando-os-seus-artefatos">Migrando os seus artefatos</h3><p>A maioria das empresas não está começando do zero, e trocar de registry de uma hora para outra não é factível. Com o GitLab Artifact Central, você pode adicionar os seus repositórios existentes como remote por trás de um repositório virtual, de forma que os desenvolvedores apontem para uma única URL e os artefatos só migrem quando um build realmente pedir por eles. Não é preciso fazer cópias em massa, reservar uma janela de migração no fim de semana, nem mover petabytes de dados pela sua rede.</p><p>O seu registry antigo continua sendo o sistema de registro oficial. E quando tudo estiver pronto, é possível converter esse remote em um repositório hosted no Artifact Central. A sua migração fica mais segura e gradual.</p><h2 id="experimente-o-artifact-central-de-graça-em-beta">Experimente o Artifact Central, de graça em beta</h2><p>O GitLab Artifact Central já está disponível hoje em beta para o GitLab.com, com disponibilidade no GitLab Self-Managed prevista para ainda este mês. Não há cobrança durante o período de beta e não há funções a serem adquiridas. Estamos acompanhando o uso para moldar os preços antes da disponibilidade geral, e vamos compartilhar os detalhes nessa hora.</p><h3 id="ajude-a-gente-a-continuar-construindo-o-gitlab-artifact-central">Ajude a gente a continuar construindo o GitLab Artifact Central</h3><p>Nada disso estaria onde está sem os nossos parceiros de design, que já estão rodando o Artifact Central com fluxos de trabalho reais há semanas. O feedback deles já moldou o que está sendo lançado hoje, e o seu feedback vai moldar o que vem a seguir.</p><p>Não é preciso convite para participar do beta do Artifact Central — <a href="https://about.gitlab.com/pt-br/artifact-central/" rel="">basta se inscrever no nosso site</a>, e alguém do nosso time entrará em contato para ativar o recurso na sua conta. Se você ainda não tem uma conta no GitLab, também pode <a href="https://about.gitlab.com/pt-br/artifact-central/" rel="">se inscrever</a> para o beta. Após isso, alguém do nosso time falará com você.</p><p>Mal podemos esperar para ver o que você vai construir.</p><blockquote><p>Assista à <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel="">gravação do nosso evento Transcend</a> para ver demonstrações dos novos recursos da plataforma e entender o que é preciso para levar a velocidade da IA agêntica a todo o ciclo de vida do software.</p></blockquote>]]></content>
        <author>
            <name>Corinne Dent</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/corinne-dent/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[A importância de implementar segurança como código no DevSecOps]]></title>
        <id>https://about.gitlab.com/pt-br/blog/how-to-security-as-code/</id>
        <link href="https://about.gitlab.com/pt-br/blog/how-to-security-as-code/"/>
        <updated>2026-09-18T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<h2 id="o-que-é-segurança-como-código">O que é segurança como código?</h2><p>A segurança como código é um dos motores do futuro da <a href="/pt-br/topics/devsecops/">segurança de aplicações</a> (application security). Segundo a O&#39;Reilly, <a href="https://www.oreilly.com/library/view/devopssec/9781491971413/ch04.html" rel="">segurança como código é a prática de incorporar segurança às ferramentas e aos fluxos de trabalho de DevOps</a>, mapeando como as alterações de código e infraestrutura acontecem e identificando pontos para adicionar verificações, testes e gates de segurança sem gerar custos ou atrasos desnecessários. Os desenvolvedores podem definir a infraestrutura usando uma linguagem de programação, com a infraestrutura como código. É preciso que o mesmo aconteça para levar a segurança ao ritmo do DevOps — daí a importância da segurança como código.</p><p>Basicamente, a segurança como código consiste em integrar políticas, testes e verificações de segurança diretamente ao pipeline e ao próprio código. Os testes devem ser executados automaticamente a cada commit, com os resultados disponibilizados imediatamente aos desenvolvedores para que possam corrigir os problemas. Ao trazer as verificações de segurança para o código desde o momento em que é escrito, os times economizam tempo e dinheiro, já que simplificam o processo de revisão nas etapas seguintes do ciclo de vida do desenvolvimento de software (SDLC).</p><h2 id="por-que-ela-é-importante">Por que ela é importante?</h2><p>A segurança como código é fundamental para o shift left e para alcançar o <a href="/pt-br/solutions/application-security-testing/">DevSecOps</a>: ela exige que a segurança seja definida desde o início do projeto e codificada para uso repetido e consistente. Dessa forma, os desenvolvedores passam a ter uma opção de autoatendimento para garantir que o próprio código seja seguro.</p><p>Políticas de segurança predefinidas aumentam a eficiência e, ao mesmo tempo, permitem verificações sobre os processos automatizados, prevenindo imprevistos no processo de deploy, como acabar derrubando acidentalmente toda a infraestrutura porque um problema não foi identificado em um ambiente de staging.</p><h2 id="seis-práticas-de-segurança-como-código-para-priorizar">Seis práticas de segurança como código para priorizar</h2><p>François Raynaud, fundador e diretor executivo da DevSecCon, afirmou que a segurança como código consiste em tornar a segurança mais transparente e fazer com que profissionais de segurança e desenvolvedores falem a mesma língua. Em outras palavras, os times de segurança precisam entender como os desenvolvedores trabalham e usar isso para ajudá-los a incorporar os controles de segurança necessários ao SDLC. Os desenvolvedores, por sua vez, podem retribuir mantendo-se receptivos à medida que adotam novas ferramentas e práticas para reforçar a segurança durante o desenvolvimento. Veja seis boas práticas para incorporar ao seu pipeline:</p><ol><li>Automatize verificações e testes de segurança (como <a href="https://docs.gitlab.com/user/application_security/sast/" rel="">análise estática</a>, <a href="https://docs.gitlab.com/user/application_security/dast/" rel="">análise dinâmica</a> e testes de penetração) dentro do seu pipeline, para que possam ser reutilizados em todos os projetos e ambientes.</li><li>Construa um ciclo de feedback contínuo apresentando os resultados aos desenvolvedores, permitindo que corrijam problemas enquanto programam e aprendam boas práticas durante o próprio processo.</li><li>Avalie e monitore as políticas de segurança automatizadas incorporando verificações ao processo. Confirme que dados sensíveis e segredos não estão sendo compartilhados ou publicados por engano.</li><li>Automatize testes manuais complexos ou demorados por meio de scripts personalizados, com aprovação humana dos resultados quando for necessário. Valide a precisão e a eficiência dos scripts de teste para que possam ser replicados em diferentes projetos.</li><li>Teste o código novo em um ambiente de staging, o que permite uma verificação de segurança completa e falhas com baixo impacto, e faça isso a cada commit.</li><li>O monitoramento agendado ou contínuo deve gerar automaticamente logs (ou alertas) em um dashboard de revisão, como o <a href="https://docs.gitlab.com/user/application_security/security_dashboard/" rel="">Security Dashboard do GitLab</a>.</li></ol><h2 id="segurança-como-código-é-uma-boa-prática-para-chegar-a-um-objetivo-maior">Segurança como código é uma boa prática para chegar a um objetivo maior</h2><p>A segurança como código dá um significado prático ao conceito de DevSecOps, mas não deve ser o seu objetivo final. No fundo, ela é um meio de engajar mais pessoas na tarefa de integrar segurança ao longo de todo o SDLC. A ideia vai parecer familiar para desenvolvedores que já praticam infraestrutura como código, pois ela também abre espaço para que a segurança entre em cena, tanto para entender melhor o desenvolvimento de software quanto para ajudar a desenhar as políticas que serão codificadas no processo.</p><p>À medida que o seu time avança para se tornar uma máquina de DevSecOps bem afinada, a segurança como código vai naturalmente se revelar uma solução inteligente dentro de um esforço complexo.</p><h2 id="avaliação-de-metodologia-devsecops-do-gitlab">Avaliação de metodologia DevSecOps do GitLab</h2><p>Implementar um processo de DevSecOps envolve muitos elementos. Por isso, para ajudar você a dominar os principais deles, criamos uma avaliação de metodologia DevSecOps. Avalie-se em 20 capacidades e use essa pontuação para entender o nível de maturidade do seu DevSecOps, além de identificar quais ações o seu time pode tomar para levar o DevSecOps ao próximo nível. <a href="https://about.gitlab.com/pt-br/platform/" rel="">Baixe a avaliação aqui.</a></p><p>Imagem de capa por <a href="https://unsplash.com/@tjevans" rel="">Tim Evans</a> no <a href="https://unsplash.com/photos/Uf-c4u1usFQ" rel="">Unsplash</a></p>]]></content>
        <author>
            <name>Vanessa Wegner</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/vanessa-wegner/</uri>
        </author>
        <published>2026-09-18T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Git pull vs. git fetch: qual é a diferença?]]></title>
        <id>https://about.gitlab.com/pt-br/blog/git-pull-vs-git-fetch-whats-the-difference/</id>
        <link href="https://about.gitlab.com/pt-br/blog/git-pull-vs-git-fetch-whats-the-difference/"/>
        <updated>2026-09-18T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O Git é um <a href="https://about.gitlab.com/pt-br/topics/version-control/benefits-distributed-version-control-system/" rel="">sistema de controle de versão distribuído</a> muito popular, sendo usado sempre que é preciso sincronizar o projeto com um repositório remoto. Para isso, cabe ao desenvolvedor escolher os comandos mais adequados para cada momento, e é justamente aí que surge a dúvida entre <code>git fetch</code> e <code>git pull</code>. Neste artigo, explicamos os fundamentos e as diferenças entre os dois comandos, além de detalhar em que situações a utilização de cada um deles faz mais sentido.</p><p>Sumário</p><ul><li><a href="#nocoes-basicas-de-git-fetch-e-git-pull">Noções básicas de git fetch e git pull</a></li><li><a href="#o-que-e-o-git-fetch">O que é o git fetch?</a></li><li><a href="#o-que-e-o-git-pull">O que é o git pull?</a></li><li><a href="#quando-usar-o-git-fetch">Quando usar o git fetch</a></li><li><a href="#quando-usar-o-git-pull">Quando usar o git pull</a></li><li><a href="#perguntas-frequentes-sobre-git-fetch-e-git-pull">Perguntas frequentes sobre git fetch e git pull</a></li></ul><h2 id="noções-básicas-de-git-fetch-e-git-pull">Noções básicas de git fetch e git pull</h2><p>O git fetch e o git pull são comandos Git usados para buscar informações atualizadas em um repositório remoto, porém, cada um faz isso à sua própria maneira. Por um lado, o git fetch baixa as alterações do repositório remoto para o repositório local, sem alterar nada no seu diretório de trabalho atual. Como essas alterações não são mescladas na branch local, você pode conferir o que mudou no repositório remoto sem interromper o que está fazendo. Já o git pull também busca as alterações mais recentes do repositório remoto, exatamente como o git fetch, mas vai um passo além e as mescla automaticamente na branch atual, ou seja, diferentemente do git fetch, ele aplica diretamente as mudanças do repositório remoto ao seu diretório de trabalho local.</p><h2 id="o-que-é-o-git-fetch">O que é o git fetch?</h2><p>O comando <code>git fetch</code> recupera o histórico de commits mais recente do repositório remoto, mas não altera o diretório de trabalho local. Mesmo após buscar as alterações remotas, elas não aparecem refletidas na sua branch local. Por isso, ele é usado principalmente quando você quer conferir o status mais recente do repositório remoto e revisar as mudanças antes de trazê-las para o repositório local. Para aplicar as alterações buscadas à sua branch local, é preciso executar manualmente o <code>git merge</code> ou o <a href="https://docs.gitlab.com/topics/git/git_rebase/" rel="">git rebase</a>.</p><h2 id="o-que-é-o-git-pull">O que é o git pull?</h2><p>O comando <code>git pull</code> combina o <code>git fetch</code> e o <code>git merge</code> (ou o <code>git rebase</code>) em um único comando, permitindo recuperar as alterações do repositório remoto e integrá-las automaticamente à branch local atual.</p><p>Explicando melhor: enquanto o git fetch apenas busca as alterações do repositório remoto sem aplicá-las à branch local, rodar o git pull já integra essas mudanças diretamente na branch local. Isso torna o git pull uma boa opção para refletir rapidamente as modificações remotas na sua branch, mas também traz um ponto de atenção: como tudo acontece de forma automática, é preciso cautela para evitar conflitos, principalmente ao trabalhar em equipe.</p><h2 id="quando-usar-o-git-fetch">Quando usar o git fetch</h2><p>O git fetch é o comando indicado quando você quer apenas buscar as informações mais recentes de um repositório remoto, sem que elas sejam refletidas diretamente na sua branch local. Este é um ponto importante porque usar o git pull traria automaticamente todas as branches remotas para a sua branch local, incluindo eventuais branches problemáticas ou incorretas.</p><p>Por isso, quando alterações estão sendo feitas simultaneamente nas branches remota e local, ou quando há novas pessoas entrando no time, é mais seguro usar o git fetch para trazer primeiro o conteúdo da branch remota e só depois realizar o merge ou o rebase,garantindo mais controle sobre o processo.</p><h2 id="quando-usar-o-git-pull">Quando usar o git pull</h2><p>O git pull realiza mais processos do que o git fetch, já que combina a busca das alterações (git fetch) com a execução do git merge ou do git rebase em uma única etapa. É por isso que ele é recomendado quando você quer refletir rapidamente as mudanças do repositório remoto na sua branch local, sem precisar rodar dois comandos separados.</p><h2 id="perguntas-frequentes-sobre-git-fetch-e-git-pull">Perguntas frequentes sobre git fetch e git pull</h2><h3 id="qual-é-a-diferença-entre-git-pull-e-git-fetch">Qual é a diferença entre git pull e git fetch?</h3><p>O git pull é um comando que executa o git fetch seguido do git merge ou do git rebase. Enquanto o git fetch não afeta o repositório local, o git pull sincroniza automaticamente as alterações do repositório remoto com o repositório local.</p><h3 id="quais-cuidados-devo-ter-ao-usar-o-git-pull">Quais cuidados devo ter ao usar o git pull?</h3><p>Ao executar o git pull, podem surgir conflitos entre as alterações remotas e locais — conflitos de merge são comuns nesse cenário e, quando acontecem, precisam ser resolvidos manualmente. Uma alternativa é usar o <code>git pull --rebase</code>, que permite incorporar as alterações mais recentes já realizando um rebase no processo.</p><h3 id="para-que-serve-o-git-fetch">Para que serve o git fetch?</h3><p>O git fetch é útil para checar e buscar o status mais recente do repositório remoto. Como as alterações buscadas não são refletidas automaticamente na branch local, o comando funciona como uma forma de sincronizar os repositórios local e remoto sem comprometer o trabalho em andamento.</p><h2 id="leia-mais">Leia mais</h2><ul><li><a href="https://about.gitlab.com/blog/whats-new-in-git-2-46-0/" rel="">Novidades do Git 2.46</a></li><li><a href="https://docs.gitlab.com/topics/git/" rel="">Aprenda Git</a></li><li><a href="https://docs.gitlab.com/administration/gitaly/" rel="">Conheça o GitLab Gitaly</a></li><li><a href="https://about.gitlab.com/blog/git-command-line-on-windows-with-git-bash/" rel="">Conheça a linha de comando do Git no Windows</a></li></ul>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-09-18T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Como se manter atualizado com as boas práticas de CI/CD?]]></title>
        <id>https://about.gitlab.com/pt-br/blog/how-to-keep-up-with-ci-cd-best-practices/</id>
        <link href="https://about.gitlab.com/pt-br/blog/how-to-keep-up-with-ci-cd-best-practices/"/>
        <updated>2026-09-17T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Integração contínua e entrega contínua (CI/CD) estão no centro de toda prática de DevSecOps bem-sucedida. Ou seja, times que desejam entregar um desenvolvimento de software moderno precisam se manter atualizados com as boas práticas de <a href="https://about.gitlab.com/pt-br/topics/ci-cd/" rel="">CI/CD</a>. Veja o que você precisa saber para garantir que o seu time está no caminho certo.</p><h2 id="o-que-é-cicd">O que é CI/CD?</h2><p>CI/CD é um processo tecnológico, é uma mentalidade, é uma sequência de etapas... o CI/CD é tudo isso. Em resumo, a integração contínua (CI - Continuous Integration) permite que os times de DevSecOps otimizem o desenvolvimento de código usando automação. Explicando melhor, a CI simplifica os builds dos softwares e a integração do código-fonte, viabiliza o controle de versão e promove maior colaboração por meio da automação. Onde a CI termina, a entrega contínua (CD - Continuous Delivery) entra em ação com testes e implantação automatizados. Além de reduzir o tempo manual que os profissionais de operações precisam dedicar à entrega e à implantação, a CD também permite que os times reduzam drasticamente o número de ferramentas necessárias para gerenciar o ciclo de vida. Ao integrar verificações de segurança e conformidade logo no início do pipeline, o CI/CD viabiliza uma abordagem de segurança shift left, que identifica e resolve problemas antes que cheguem aos ambientes de produção.</p><h2 id="quais-são-as-boas-práticas-para-o-cicd">Quais são as boas práticas para o CI/CD?</h2><p>Se você quer ter sucesso com o CI/CD, é preciso transformar a integração, a entrega e a implantação contínuas no seu mantra, já que elas são a base das práticas de desenvolvimento de software. O objetivo do DevSecOps é levar o software aos usuários mais rápido do que os métodos tradicionais, logo, essas práticas de desenvolvimento ajudam a tornar isso realidade.
Veja as práticas mais essenciais, em ordem de importância:</p><ol><li><strong>Use uma plataforma DevSecOps unificada:</strong> consolide suas ferramentas de CI/CD em uma única plataforma para reduzir a sobrecarga de manutenção, minimizar a mudança de contexto e aumentar a colaboração. Menos ferramentas significam menos complexidade para a integração e uma experiência melhor entre os times de desenvolvimento, segurança e operações.</li><li><strong>Automatize tudo:</strong> continue ajustando o pipeline de CI/CD para garantir que o estado de &quot;automação contínua&quot; seja alcançado. Isso inclui testes automatizados, verificações de segurança, implantação e provisionamento de infraestrutura.</li><li><strong>Falhe rápido:</strong> do lado da CI, os desenvolvedores que fazem o commit de código precisam saber o mais rápido possível se há problemas, para que possam reverter e corrigir enquanto ainda está fresco na memória. A ideia do &quot;falhar rápido&quot; também ajuda a reduzir a troca de contexto dos desenvolvedores, o que deixa os profissionais de DevSecOps mais satisfeitos.</li><li><strong>Faça commits com frequência:</strong> quanto mais regulares forem os commits de código, mais benefícios os times de DevSecOps vão perceber. Alterações pequenas e frequentes são mais fáceis de revisar, testar e implantar com segurança.</li><li><strong>Antecipe a segurança (shift left):</strong> o CI/CD oferece uma boa oportunidade para integrar verificações de segurança, avaliações de vulnerabilidade e checagens de conformidade mais cedo no processo.</li><li><strong>Aproveite a IA para solucionar problemas no pipeline:</strong> use ferramentas com IA para diagnosticar automaticamente falhas no pipeline, identificar causas raiz e sugerir correções, reduzindo o tempo de resolução de horas para minutos.</li><li><strong>Use feature flags:</strong> desacople o deploy (ou seja, a implantação) do release usando as feature flags. Isso permite subir o código em produção sem expor novas funcionalidades aos usuários, possibilitando lançamentos mais seguros e reversões instantâneas.</li><li><strong>Monitore tudo:</strong> implemente uma observabilidade abrangente, incluindo métricas da aplicação, logs e KPIs de negócio. Configure alertas para limites críticos, tanto técnicos quanto de negócio.</li><li><strong>Mantenha o pipeline como código:</strong> armazene a configuração do seu pipeline de CI/CD no controle de versão, junto com o código da sua aplicação. Isso garante que as alterações no pipeline sejam rastreadas, revisadas e possam ser revertidas.</li><li><strong>Habilite ciclos de feedback:</strong> garanta que todo o time receba, de forma facilitada, e também contribua com o feedback. Isso inclui monitoramento, alertas, validação pós-implantação e processos de melhoria contínua.</li></ol><h2 id="boas-práticas-de-entrega-contínua">Boas práticas de entrega contínua</h2><p>A entrega/implantação contínua merece um aprofundamento à parte em suas boas práticas, já que a CI costuma roubar a maior parte dos holofotes. Veja as boas práticas essenciais de CD:</p><ul><li><strong>Comece com a sua configuração atual:</strong> não espere por uma plataforma perfeita. Comece identificando os gargalos no seu processo de implantação atual e automatize inicialmente as etapas manuais mais dolorosas.</li><li><strong>Adote estratégias de implantação:</strong> implemente técnicas de entrega progressiva, como <a href="https://docs.gitlab.com/ci/environments/incremental_rollouts/#blue-green-deployment" rel=""><strong>deploy blue-green</strong></a>, <a href="https://docs.gitlab.com/user/project/canary_deployments/" rel=""><strong>canary deployment</strong></a> ou <a href="https://docs.gitlab.com/operations/feature_flags/" rel=""><strong>feature flags</strong></a>, para reduzir riscos e possibilitar rollbacks seguros.</li><li><strong>Mantenha a paridade entre ambientes:</strong> garanta que os ambientes de desenvolvimento, staging e produção sejam o mais parecidos possível. Use infraestrutura como código para eliminar desvios de configuração.</li><li><strong>Automatize a validação de implantação:</strong> crie testes de fumaça (smoke tests) e verificações de integridade automatizados que validem as implantações imediatamente após o release. Assim, as validações que falharem devem disparar rollbacks automáticos.</li><li><strong>Implemente monitoramento abrangente:</strong> monitore tanto métricas técnicas (como tempos de resposta e taxas de erro) quanto KPIs de negócio (como engajamento do usuário e taxas de conversão) para identificar problemas cedo.</li><li><strong>Pratique implantações sem downtime:</strong> projete suas aplicações e o processo de implantação para lidar com atualizações sem interrupção do serviço, usando técnicas como atualizações graduais (rolling updates) ou troca de balanceador de carga (load balancing).</li><li><strong>Mantenha as reversões simples:</strong> garanta que você consiga voltar rapidamente para a versão anterior. Teste seu processo de rollback regularmente e, quando possível, torne-o uma operação de apenas um clique.</li><li><strong>Separe a implantação do lançamento:</strong> use feature flags para implantar código sem expor imediatamente novas funcionalidades aos usuários, permitindo testes mais seguros em produção.</li></ul><h2 id="como-otimizar-o-pipeline-de-cicd">Como otimizar o pipeline de CI/CD</h2><p>Um pipeline de CI/CD é a sequência automatizada de etapas que leva o código do desenvolvimento até a produção. O pipeline típico inclui: <strong>build</strong>, <strong>test</strong>, <strong>security scan</strong>, <strong>deploy</strong> e <strong>monitor</strong>. Embora essas etapas possam ser feitas manualmente, a automação é o processo que realmente torna o CI/CD valioso. Então, se chegou a hora de otimizar o seu pipeline de CI/CD, considere aplicar estas melhorias de desempenho:</p><h3 id="otimize-o-desempenho-do-pipeline">Otimize o desempenho do pipeline</h3><ul><li>Implemente o <a href="https://docs.gitlab.com/ci/caching/" rel="">cache de build</a> para evitar recompilar componentes que não mudaram.</li><li>Use a execução de <a href="https://docs.gitlab.com/ci/jobs/job_rules/#rules-examples" rel="">jobs condicionais</a> para pular etapas desnecessárias quando o código não foi alterado.</li><li>Otimize as imagens Docker com builds multi-stage e imagens base menores.</li></ul><h3 id="melhore-a-visibilidade-do-pipeline">Melhore a visibilidade do pipeline</h3><ul><li>Adicione o monitoramento da duração do pipeline para identificar quais são os estágios lentos.</li><li>Implemente um registro de logs detalhado e uma coleta de artefatos para facilitar a solução de problemas.</li><li>Aproveite os <a href="https://docs.gitlab.com/user/operations_dashboard/" rel="">dashboards de pipeline</a> para mostrar taxas de sucesso e tendências de desempenho.</li></ul><h3 id="otimize-a-eficiência-de-recursos">Otimize a eficiência de recursos</h3><ul><li>Dimensione corretamente seus runners de CI com base no consumo real de recursos.</li><li>Use instâncias spot ou <a href="https://docs.gitlab.com/runner/runner_autoscale/" rel="">autoscaling</a> para recursos de computação mais econômicos.</li><li>Limpe recursos e artefatos temporários após a conclusão do pipeline.</li></ul><h3 id="escale-para-o-crescimento-do-time">Escale para o crescimento do time</h3><ul><li>Use <a href="https://docs.gitlab.com/ci/components/" rel="">componentes de pipeline</a> para manter a consistência entre projetos.</li><li>Use ambientes dinâmicos que sobem e são desativados automaticamente.</li><li>Configure fluxos de <a href="https://docs.gitlab.com/ci/environments/deployment_approvals/" rel="">aprovação de pipeline</a> para implantações em produção.</li></ul><h2 id="estratégia-de-implantação-de-cicd">Estratégia de implantação de CI/CD</h2><p>Lembre-se: o CI/CD tem como objetivo entregar uma aplicação de software ao cliente com mais qualidade e mais rapidez do que antes. Organizações que adotam o CI/CD veem uma melhora significativa na produtividade. O segredo é criar uma estratégia de implantação que funcione para aquela organização específica.
Veja algumas estratégias que ajudam a garantir o sucesso de uma implantação:</p><ul><li><strong>Faça commits de alterações pequenas:</strong> implante mudanças pequenas e incrementais com frequência, em vez de fazer grandes releases. Isto porque alterações pequenas são mais fáceis de testar, revisar e reverter caso surjam problemas, reduzindo o risco da implantação.</li><li><strong>Comece pequeno e depois cresça:</strong> comece com aplicações menos críticas para ganhar confiança e refinar processos antes de partir para sistemas essenciais para o negócio.</li><li><strong>Implemente rollbacks automatizados:</strong> defina critérios claros para reversões automáticas com base em taxas de erro, métricas de desempenho ou verificações de integridade.</li><li><strong>Pratique simulações de deploy:</strong> teste regularmente o seu processo de implantação em ambientes de staging que espelhem o ambiente de produção.</li><li><strong>Estabeleça janelas de implantação:</strong> agende implantações em períodos de baixo tráfego no início e, à medida que a confiança cresça, avance rumo à implantação contínua.</li><li><strong>Monitore o impacto da implantação:</strong> acompanhe tanto métricas técnicas (tempo de resposta, taxas de erro) quanto métricas de negócio (engajamento do usuário, taxas de conversão) após cada implantação.</li></ul><h2 id="como-medir-o-sucesso-do-cicd">Como medir o sucesso do CI/CD</h2><p>Os times de DevSecOps não conseguem saber o quão bem as suas práticas de CI/CD estão indo, a menos que elas sejam quantificadas. Neste sentido, as métricas desempenham um papel importante na melhoria do desempenho do sistema e ajudam a identificar onde é possível agregar valor. Veja as métricas essenciais a serem usadas:</p><h3 id="as-quatro-métricas-do-dora">As quatro métricas do DORA</h3><p>Os times modernos se apoiam no <a href="https://docs.gitlab.com/user/analytics/dora_metrics/" rel="">framework DORA</a>, que identifica quatro métricas-chave fortemente relacionadas ao desempenho organizacional:</p><h3 id="frequência-de-implantação">Frequência de implantação</h3><p>Com que frequência o seu time consegue publicar o código em produção com sucesso. Os times com desempenho de elite implantam várias vezes por dia, enquanto os times de alto desempenho implantam diariamente ou semanalmente. Essa métrica indica a capacidade do seu time de entregar valor e responder às demandas do mercado.</p><h3 id="prazo-de-entrega-das-alterações">Prazo de entrega das alterações</h3><p>Tempo entre o commit do código e a implantação em produção. Os times de elite alcançam prazos de entrega inferiores a um dia; os times de alto desempenho variam entre um dia e uma semana. Se os commits levam semanas para chegar à produção, o seu pipeline precisa de otimização.</p><h3 id="taxa-de-falha-em-alterações">Taxa de falha em alterações</h3><p>Percentual de deploys que causam falhas em produção e exigem hotfixes ou rollbacks. Os times de elite mantêm taxas de falha de até 15%; os times de alto desempenho ficam entre 16% e 30%. Taxas de falha altas indicam problemas de qualidade nas suas práticas de teste e implantação.</p><h3 id="tempo-médio-de-recuperação">Tempo médio de recuperação</h3><p>Com que rapidez o seu time restaura o serviço após falhas no deploy. Os times de elite se recuperam em menos de uma hora; já os times de alto desempenho, em menos de um dia. Uma recuperação rápida exige monitoramento robusto e capacidades de reversão automatizada.</p><h3 id="métricas-adicionais-de-cicd">Métricas adicionais de CI/CD</h3><p>Além das métricas principais do DORA, os times costumam acompanhar estes indicadores operacionais:</p><h3 id="custos-de-infraestrutura">Custos de infraestrutura</h3><p>O CI/CD nativo em nuvem pode gerar despesas significativas se não for bem gerenciado. Práticas eficientes que reduzem os tempos de build e otimizam o uso de recursos impactam diretamente os custos operacionais.</p><h3 id="retenção-de-talentos">Retenção de talentos</h3><p>Desenvolvedores satisfeitos permanecem na empresa. Quando os times colaboram de forma eficaz nas práticas de CI/CD, a retenção aumenta. Taxas de retenção em queda podem sinalizar problemas com ferramentas ou fluxos de implantação, problemas que os desenvolvedores podem hesitar em expressar diretamente.</p><h3 id="o-impacto-do-negócio-das-métricas-de-cicd">O impacto do negócio das métricas de CI/CD</h3><p>Essas métricas técnicas se traduzem diretamente em resultados para o negócio:</p><ul><li>Uma frequência de implantação mais rápida reduz o tempo de lançamento no mercado e melhora a capacidade de resposta ao cliente. Isso representa a <strong>velocidade de inovação e capacidade de resposta ao mercado</strong>.</li><li>Prazos de entrega mais curtos permitem entregar recursos e correções mais rápido, aumentando a satisfação do cliente. Isso mede o <strong>tempo entre a ideia e o valor entregue ao cliente</strong>.</li><li>Taxas de falha menores reduzem os custos de suporte e minimizam o impacto ao cliente causado por problemas em produção. Isso indica a <strong>qualidade e a confiabilidade da experiência do cliente</strong>.</li><li>Um tempo médio de recuperação menor protege a receita durante interrupções e mantém a confiabilidade do serviço. Isso reflete a <strong>continuidade do negócio e a capacidade de mitigação de riscos</strong>.</li></ul><h3 id="vantagem-competitiva">Vantagem competitiva</h3><p>O <a href="https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report" rel="">programa de pesquisa DORA</a> constatou que organizações de alta performance demonstram consistentemente melhores resultados de negócio em múltiplas áreas.</p><blockquote><p><strong>Times com métricas de CI/CD sólidas relatam maior produtividade, maior satisfação do cliente e maior capacidade de competir em mercados que estão em constante mudança</strong>.</p></blockquote><h2 id="quais-são-os-benefícios-de-seguir-as-boas-práticas-de-cicd">Quais são os benefícios de seguir as boas práticas de CI/CD?</h2><p>Quando as boas práticas são seguidas, os benefícios do CI/CD são sentidos primeiro pelos seus clientes e, depois, por toda a organização. Veja os principais benefícios:</p><ul><li><strong>Os clientes recebem recursos e correções mais rápido.</strong> O CI/CD permite a entrega rápida de novas funcionalidades e correções de bugs, melhorando diretamente a experiência do usuário e mantendo os clientes satisfeitos com melhorias contínuas.</li><li><strong>Software mais confiável e de maior qualidade.</strong> Testes automatizados e lançamentos graduais significam que menos bugs chegam à produção, resultando em aplicações mais estáveis nas quais os clientes podem confiar.</li><li><strong>Resposta mais rápida ao feedback dos clientes.</strong> Ciclos de desenvolvimento curtos permitem que os times implementem rapidamente solicitações dos clientes e resolvam problemas, mostrando que a opinião deles é valorizada e atendida com agilidade.</li><li><strong>Melhor uptime e desempenho.</strong> Monitoramento automatizado e capacidade de rollbacks rápidos significam que problemas visíveis aos clientes são resolvidos mais rápido, minimizando interrupções no serviço.</li><li><strong>Recursos mais inovadores.</strong> Quando os desenvolvedores gastam menos tempo em processos manuais e apagando incêndios, eles podem focar em construir recursos que realmente agregam valor para o cliente e trazem diferenciais para o produto.</li><li><strong>Suporte ao cliente aprimorado.</strong> Ciclos de implantação mais rápidos significam que problemas relatados pelos clientes podem ser corrigidos e implantados rapidamente, em vez de esperar pelo próximo grande ciclo de lançamento.</li></ul><p>Os benefícios internos vêm naturalmente na sequência: desenvolvedores mais satisfeitos, melhor colaboração entre times, menor sobrecarga operacional e maior retenção de talentos — tudo isso, no fim das contas, contribui para entregar experiências melhores aos clientes.</p><h2 id="como-posso-implementar-o-cicd-na-minha-organização">Como posso implementar o CI/CD na minha organização?</h2><p>Antes de implementar qualquer software, é fundamental determinar quais são os fatores de negócio, sendo que isto também vale para a adoção do CI/CD. Todas as partes interessadas no desenvolvimento devem ser envolvidas logo no início do processo de implementação. Os desenvolvedores devem contribuir com sua visão, já que serão os principais usuários do produto.</p><p>Faça uma pesquisa cuidadosa sobre softwares que viabilizam o CI/CD e pergunte sobre testes gratuitos.</p><p>Embora possa parecer contraintuitivo, já que o CI/CD tem como objetivo acelerar o ritmo da entrega de software usando automações, comece o processo de adoção com uma mentalidade de adaptação devagar e segura. O ganho de eficiência diminui se os bugs continuarem chegando de forma constante à aplicação em produção.</p><p>É importante manter consistência no processo de integração. Execute testes unitários, dispare releases manualmente e acompanhe as métricas. Depois, determine o que pode e deve ser automatizado.</p><blockquote><p>Comece hoje mesmo com o CI/CD assinando um <a href="https://about.gitlab.com/pt-br/free-trial/devsecops/" rel="">teste gratuito do GitLab Ultimate com o Duo Enterprise</a>.</p></blockquote>]]></content>
        <author>
            <name>Itzik Gan Baruch</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/itzik-gan-baruch/</uri>
        </author>
        <published>2026-09-17T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Primeiros passos com o GitLab: entenda o CI/CD]]></title>
        <id>https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/</id>
        <link href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/"/>
        <updated>2026-09-17T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p><em>Bem-vindo(a) à nossa série &quot;Primeiros passos com o GitLab&quot;, em que ajudamos quem está iniciando agora a se familiarizar com a plataforma DevSecOps do GitLab.</em></p><p>Imagine um fluxo de trabalho em que cada alteração de código é automaticamente compilada, testada e publicada para os seus usuários. É esse o poder da <a href="https://about.gitlab.com/pt-br/topics/ci-cd/" rel="">Integração Contínua/Entrega Contínua (CI/CD)</a>! O CI/CD ajuda você a identificar bugs mais cedo, garante a qualidade do código e entrega software mais rápido e com mais frequência.</p><h3 id="o-que-é-cicd">O que é CI/CD?</h3><ul><li>A <strong>Integração Contínua</strong> (CI) é uma prática de desenvolvimento de software em que os desenvolvedores integram com frequência as alterações de código a um repositório compartilhado, de preferência várias vezes ao dia. Cada integração é então verificada por um processo automatizado de build e teste, permitindo que os times detectem problemas logo no início.</li><li>A <strong>Entrega Contínua</strong> (CD) amplia a CI ao automatizar o pipeline, garantindo que o seu código esteja <em>sempre</em> pronto para o deploy. Assim, você pode implantar sua aplicação em diferentes ambientes (por exemplo, staging, produção) com um único clique ou de forma automática.</li><li>A <strong>Implantação Contínua</strong> (CD) vai um passo além ao implantar automaticamente <em>cada build bem-sucedido</em> em produção. Isso exige um alto grau de confiança nos seus testes automatizados e no processo de implantação.</li></ul><h3 id="por-que-usar-o-gitlab-cicd">Por que usar o GitLab CI/CD?</h3><p>O GitLab CI/CD é um sistema poderoso e integrado que já vem incluído na plataforma do GitLab. Ele oferece uma experiência integrada para automatizar todo o seu ciclo de vida de desenvolvimento de software (SDLC). Com o GitLab CI/CD, você pode:</p><ul><li><strong>Automatizar todo o processo:</strong> compile, teste e suba as suas aplicações com rapidez e facilidade.</li><li><strong>Detectar bugs mais rápido:</strong> encontre e corrija erros antes que cheguem aos ambientes de produção.</li><li><strong>Obter feedback mais rápido:</strong> receba feedback imediato sobre as alterações realizadas no seu código.</li><li><strong>Melhorar a colaboração:</strong> trabalhe em conjunto eficientemente com fluxos de trabalho automatizados.</li><li><strong>Acelerar a entrega:</strong> publique novas versões do software mais rapidamente e com mais frequência.</li><li><strong>Reduzir riscos:</strong> minimize consideravelmente erros no deploy e rollbacks.</li></ul><h3 id="os-elementos-do-gitlab-cicd">Os elementos do GitLab CI/CD</h3><ul><li><code>.gitlab-ci.yml</code><strong>:</strong> este <a href="https://docs.gitlab.com/ci/yaml/" rel="">arquivo YAML</a>, localizado no diretório raiz do seu projeto, define o pipeline de CI/CD, incluindo as etapas, jobs e runners.</li><li><a href="https://docs.gitlab.com/runner/" rel=""><strong>GitLab Runner</strong></a><strong>:</strong> esse agente executa os seus jobs de CI/CD na sua infraestrutura (por exemplo, máquinas físicas, máquinas virtuais, containers Docker ou clusters Kubernetes).</li><li><a href="https://docs.gitlab.com/ci/yaml/#stages" rel=""><strong>Etapas</strong></a><strong>:</strong> as etapas definem a ordem de execução dos seus jobs (por exemplo, build, test e deploy).</li><li><a href="https://docs.gitlab.com/ci/yaml/#job-keywords" rel=""><strong>Jobs</strong></a><strong>:</strong> os jobs são unidades individuais de trabalho dentro de um estágio (por exemplo, compilar código, executar testes e realizar o deploy para staging).</li></ul><h3 id="como-configurar-o-gitlab-ci">Como configurar o GitLab CI?</h3><p>Começar com o GitLab CI é simples. Veja um exemplo básico de um arquivo <code>.gitlab-ci.yml</code>:</p><pre className="language-yaml shiki shiki-themes github-light" code="stages:
  - build
  - test
  - deploy

build_job:
  stage: build
  script:
    - echo &quot;Building the application...&quot;

test_job:
  stage: test
  script:
    - echo &quot;Running tests...&quot;

deploy_job:
  stage: deploy
  script:
    - echo &quot;Deploying to production...&quot;
  environment:
    name: production

" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">stages</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="sYBdl">build
</span></span><span class="line" line="3"><span class="sgsFI">  - </span><span class="sYBdl">test
</span></span><span class="line" line="4"><span class="sgsFI">  - </span><span class="sYBdl">deploy
</span></span><span class="line" line="5"><span emptyLinePlaceholder>
</span></span><span class="line" line="6"><span class="shJU0">build_job</span><span class="sgsFI">:
</span></span><span class="line" line="7"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">build
</span></span><span class="line" line="8"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="9"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Building the application...&quot;
</span></span><span class="line" line="10"><span emptyLinePlaceholder>
</span></span><span class="line" line="11"><span class="shJU0">test_job</span><span class="sgsFI">:
</span></span><span class="line" line="12"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">test
</span></span><span class="line" line="13"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="14"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Running tests...&quot;
</span></span><span class="line" line="15"><span emptyLinePlaceholder>
</span></span><span class="line" line="16"><span class="shJU0">deploy_job</span><span class="sgsFI">:
</span></span><span class="line" line="17"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">deploy
</span></span><span class="line" line="18"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="19"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Deploying to production...&quot;
</span></span><span class="line" line="20"><span class="shJU0">  environment</span><span class="sgsFI">:
</span></span><span class="line" line="21"><span class="shJU0">    name</span><span class="sgsFI">: </span><span class="sYBdl">production
</span></span></code></pre><p>Essa configuração define três etapas: &quot;build&quot;, &quot;test&quot; e &quot;deploy&quot;. Cada etapa contém um job que executa um script simples.</p><h3 id="exemplos-de-configuração-de-cicd">Exemplos de configuração de CI/CD</h3><p>Vamos explorar alguns exemplos mais realistas.</p><p><strong>Compilando e implantando uma aplicação Node.js</strong></p><p>A definição de pipeline abaixo mostra o uso do npm para compilar e testar uma aplicação Node.js e do <a href="https://docs.gitlab.com/ci/examples/deployment/" rel="">dpl</a> para implantar a aplicação no Heroku. A etapa de deploy do pipeline utiliza as <a href="https://docs.gitlab.com/ci/variables/" rel="">variáveis de CI/CD do GitLab</a>, que permitem que os desenvolvedores armazenem informações sensíveis (como credenciais) e as utilizem com segurança nos processos de CI/CD. Neste exemplo, uma chave de API para publicar no Heroku é armazenada na variável <code>$HEROKU_API_KEY</code>, usada pela ferramenta dpl.</p><pre className="language-yaml shiki shiki-themes github-light" code="stages:
  - build
  - test
  - deploy

build:
  stage: build
  image: node:latest
  script:
    - npm install
    - npm run build

test:
  stage: test
  image: node:latest
  script:
    - npm run test

deploy:
  stage: deploy
  image: ruby:latest
  script:
    - gem install dpl
    - dpl --provider=heroku --app=$HEROKU_APP_NAME --api-key=$HEROKU_API_KEY

" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">stages</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="sYBdl">build
</span></span><span class="line" line="3"><span class="sgsFI">  - </span><span class="sYBdl">test
</span></span><span class="line" line="4"><span class="sgsFI">  - </span><span class="sYBdl">deploy
</span></span><span class="line" line="5"><span emptyLinePlaceholder>
</span></span><span class="line" line="6"><span class="shJU0">build</span><span class="sgsFI">:
</span></span><span class="line" line="7"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">build
</span></span><span class="line" line="8"><span class="shJU0">  image</span><span class="sgsFI">: </span><span class="sYBdl">node:latest
</span></span><span class="line" line="9"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="10"><span class="sgsFI">    - </span><span class="sYBdl">npm install
</span></span><span class="line" line="11"><span class="sgsFI">    - </span><span class="sYBdl">npm run build
</span></span><span class="line" line="12"><span emptyLinePlaceholder>
</span></span><span class="line" line="13"><span class="shJU0">test</span><span class="sgsFI">:
</span></span><span class="line" line="14"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">test
</span></span><span class="line" line="15"><span class="shJU0">  image</span><span class="sgsFI">: </span><span class="sYBdl">node:latest
</span></span><span class="line" line="16"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="17"><span class="sgsFI">    - </span><span class="sYBdl">npm run test
</span></span><span class="line" line="18"><span emptyLinePlaceholder>
</span></span><span class="line" line="19"><span class="shJU0">deploy</span><span class="sgsFI">:
</span></span><span class="line" line="20"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">deploy
</span></span><span class="line" line="21"><span class="shJU0">  image</span><span class="sgsFI">: </span><span class="sYBdl">ruby:latest
</span></span><span class="line" line="22"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="23"><span class="sgsFI">    - </span><span class="sYBdl">gem install dpl
</span></span><span class="line" line="24"><span class="sgsFI">    - </span><span class="sYBdl">dpl --provider=heroku --app=$HEROKU_APP_NAME --api-key=$HEROKU_API_KEY
</span></span></code></pre><p><strong>Publicando em diferentes ambientes (staging e produção)</strong></p><p>O GitLab também oferece o conceito de <a href="https://docs.gitlab.com/ci/environments/" rel="">Ambientes (Environments)</a> no CI/CD. Esse recurso permite que os usuários acompanhem as implantações do CI/CD até os seus destinos na infraestrutura. No exemplo abaixo, o pipeline adiciona etapas com uma propriedade de ambiente para staging e produção. Enquanto a etapa deploy_staging sempre executa seu script, a etapa deploy_production exige aprovação manual para evitar publicações acidentais em produção.</p><pre className="language-yaml shiki shiki-themes github-light" code="stages:
  - build
  - test
  - deploy_staging
  - deploy_production

build:
  # ...

test:
  # ...

deploy_staging:
  stage: deploy_staging
  script:
    - echo &quot;Deploying to staging...&quot;
  environment:
    name: staging

deploy_production:
  stage: deploy_production
  script:
    - echo &quot;Deploying to production...&quot;
  environment:
    name: production
  when: manual  # Requires manual approval

" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">stages</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="sYBdl">build
</span></span><span class="line" line="3"><span class="sgsFI">  - </span><span class="sYBdl">test
</span></span><span class="line" line="4"><span class="sgsFI">  - </span><span class="sYBdl">deploy_staging
</span></span><span class="line" line="5"><span class="sgsFI">  - </span><span class="sYBdl">deploy_production
</span></span><span class="line" line="6"><span emptyLinePlaceholder>
</span></span><span class="line" line="7"><span class="shJU0">build</span><span class="sgsFI">:
</span></span><span class="line" line="8"><span class="sAwPA">  # ...
</span></span><span class="line" line="9"><span emptyLinePlaceholder>
</span></span><span class="line" line="10"><span class="shJU0">test</span><span class="sgsFI">:
</span></span><span class="line" line="11"><span class="sAwPA">  # ...
</span></span><span class="line" line="12"><span emptyLinePlaceholder>
</span></span><span class="line" line="13"><span class="shJU0">deploy_staging</span><span class="sgsFI">:
</span></span><span class="line" line="14"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">deploy_staging
</span></span><span class="line" line="15"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="16"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Deploying to staging...&quot;
</span></span><span class="line" line="17"><span class="shJU0">  environment</span><span class="sgsFI">:
</span></span><span class="line" line="18"><span class="shJU0">    name</span><span class="sgsFI">: </span><span class="sYBdl">staging
</span></span><span class="line" line="19"><span emptyLinePlaceholder>
</span></span><span class="line" line="20"><span class="shJU0">deploy_production</span><span class="sgsFI">:
</span></span><span class="line" line="21"><span class="shJU0">  stage</span><span class="sgsFI">: </span><span class="sYBdl">deploy_production
</span></span><span class="line" line="22"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="23"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Deploying to production...&quot;
</span></span><span class="line" line="24"><span class="shJU0">  environment</span><span class="sgsFI">:
</span></span><span class="line" line="25"><span class="shJU0">    name</span><span class="sgsFI">: </span><span class="sYBdl">production
</span></span><span class="line" line="26"><span class="shJU0">  when</span><span class="sgsFI">: </span><span class="sYBdl">manual</span><span class="sAwPA">  # Requires manual approval
</span></span></code></pre><h3 id="gitlab-auto-devops">GitLab Auto DevOps</h3><p>O <a href="https://docs.gitlab.com/topics/autodevops/" rel="">GitLab Auto DevOps</a> simplifica o CI/CD ao oferecer uma configuração pré-definida que compila, testa e publica suas aplicações automaticamente. Para isso, ele utiliza as boas práticas e padrões do setor para otimizar o seu fluxo de trabalho.</p><p>Para ativar o Auto DevOps:</p><ol><li>Acesse <strong>Settings &gt; CI/CD &gt; General pipelines</strong> no seu projeto.</li><li>Ative a opção <strong>Auto DevOps</strong>.</li></ol><p>O Auto DevOps detecta automaticamente a linguagem e o framework do seu projeto e configura as etapas necessárias de build, test e deploy. Ou seja, você nem precisa criar um arquivo <code>.gitlab-ci.yml</code>.</p><h3 id="catálogo-de-cicd">Catálogo de CI/CD</h3><p>O <a href="https://about.gitlab.com/blog/faq-gitlab-ci-cd-catalog/" rel="">Catálogo de CI/CD</a> é uma lista de projetos com <a href="https://docs.gitlab.com/ci/components/" rel="">componentes de CI/CD</a> publicados para que você possa estender o seu fluxo de trabalho de CI/CD. Assim, qualquer pessoa pode criar um projeto de componente e adicioná-lo ao Catálogo de CI/CD, ou mesmo contribuir para um projeto existente para melhorar os componentes disponíveis. Você pode encontrar os componentes publicados no <a href="https://gitlab.com/explore/catalog" rel="">Catálogo de CI/CD</a> no GitLab.com.</p><blockquote><p><a href="https://about.gitlab.com/blog/tutorial-how-to-set-up-your-first-gitlab-ci-cd-component/" rel="">Tutorial: Saiba como configurar seu primeiro componente de CI/CD do GitLab</a></p></blockquote><h3 id="templates-de-ci">Templates de CI</h3><p>Você também pode criar seus próprios <a href="https://docs.gitlab.com/ci/examples/" rel="">templates de CI</a> para padronizar e reutilizar configurações de CI/CD em vários projetos, o que promove a consistência e reduz a duplicação.</p><p>Para criar um template de CI:</p><ol><li>Crie um arquivo <code>.gitlab-ci.yml</code> em um projeto ou repositório dedicado.</li><li>Defina sua configuração de CI/CD no template.</li><li>No arquivo <code>.gitlab-ci.yml</code> do seu projeto, use a palavra-chave <code>include</code> para incluir o template.</li></ol><h2 id="leve-o-seu-desenvolvimento-para-o-próximo-nível">Leve o seu desenvolvimento para o próximo nível</h2><p>O GitLab CI/CD é uma ferramenta poderosa que pode transformar o seu fluxo de trabalho de desenvolvimento. Ao entender os conceitos de CI/CD, configurar seus pipelines e aproveitar recursos como o Auto DevOps, o Catálogo de CI/CD e os templates de CI, você pode automatizar todo o seu ciclo de vida de desenvolvimento de software e entregar software de alta qualidade mais rápido e com mais eficiência.</p><blockquote><p>Quer saber mais sobre este e outros assuntos, e aprofundar o seu aprendizado? Inscreva-se nos <a href="https://university.gitlab.com/" rel="">cursos da GitLab University</a> ou comece agora mesmo com um <a href="https://about.gitlab.com/pt-br/free-trial/" rel="">teste gratuito do GitLab Ultimate</a>.</p></blockquote><h2 id="série-primeiros-passos-com-o-gitlab">Série &quot;Primeiros passos com o GitLab&quot;</h2><p>Confira mais artigos da nossa série &quot;Primeiros passos com o GitLab&quot;:</p><ul><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-how-to-manage-users/" rel="">Como gerenciar usuários</a></li><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-how-to-import-your-projects-to-gitlab/" rel="">Como importar seus projetos para o GitLab</a></li><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-mastering-project-management/" rel="">Dominando o gerenciamento de projetos</a></li><li><a href="https://about.gitlab.com/blog/automating-agile-workflows-with-the-gitlab-triage-gem/" rel="">Automatizando fluxos de trabalho ágeis com a gem gitlab-triage</a></li><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-working-with-ci-cd-variables/" rel="">Trabalhando com variáveis de CI/CD</a></li></ul><style>html pre.shiki code .shJU0, html code.shiki .shJU0{--shiki-default:#22863A}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html pre.shiki code .sAwPA, html code.shiki .sAwPA{--shiki-default:#6A737D}</style>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-09-17T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[4 princípios essenciais do DevOps que você precisa conhecer]]></title>
        <id>https://about.gitlab.com/pt-br/blog/4-must-know-devops-principles/</id>
        <link href="https://about.gitlab.com/pt-br/blog/4-must-know-devops-principles/"/>
        <updated>2026-09-15T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>A conhecida metodologia de desenvolvimento de software <a href="/pt-br/topics/devops/">DevOps</a> pode confundir um pouco quem está começando, principalmente quando o conceito se estende para outras áreas, como segurança (DevSecOps), negócios (BizDevOps), entre outras áreas.</p><h2 id="então-o-que-é-devops">Então, o que é DevOps?</h2><p>O DevOps une dois times que antes eram separados - o time de desenvolvimento de software e o time de operações (de TI) – e os transforma em uma frente unida, capaz de criar código seguro ao mesmo tempo em que acelera o ciclo de vida do desenvolvimento de software - SDLC. Os fundamentos do DevOps incluem uma cultura colaborativa e comunicativa, testes automatizados, releases e implantações, além de iterações frequentes. Outro termo bastante usado no universo DevOps é o <a href="https://about.gitlab.com/pt-br/topics/devsecops/" rel="">DevSecOps</a>, que se refere a uma prática de DevOps com ênfase específica em segurança.</p><p>O que realmente importa está no centro da metodologia DevOps: estes quatro princípios-chave, capazes de melhorar a prática de desenvolvimento de software da sua organização.</p><ol><li>Automação do ciclo de vida do desenvolvimento de software</li><li>Colaboração e comunicação</li><li>Melhoria contínua e minimização de desperdício</li><li>Foco intenso nas necessidades do usuário, com ciclos de feedback curtos</li></ol><h2 id="uma-análise-dos-principais-princípios-do-devops">Uma análise dos principais princípios do DevOps</h2><p>Há cerca de 15 anos, surgiu a ideia de unir desenvolvimento e operações de forma integrada. Em 2009, o termo &quot;DevOps&quot; foi cunhado por Patrick Debois, considerado um dos principais gurus da metodologia. O DevOps incorpora boa parte dos princípios do <a href="/pt-br/topics/agile-delivery/">desenvolvimento ágil de software</a>, mas com ênfase especial na quebra dos silos entre desenvolvimento e operações.</p><p>Desde então, o DevOps só cresceu em popularidade, alcançando desde pequenas empresas até grandes corporações com sistemas legados, passando por praticamente todos os portes de negócio. Assim como em outras situações, o DevOps se adapta às necessidades e ao ambiente exclusivo de cada organização, ajustando-se ao que é mais importante para o negócio.</p><p>Por isso, é possível encontrar diversas variações do DevOps, mas, no fundo, todas compartilham estes 4 princípios essenciais:</p><h3 id="automação-do-ciclo-de-vida-do-desenvolvimento-de-software">Automação do ciclo de vida do desenvolvimento de software</h3><p>A automação é o norte de todo time de DevOps. Antes do DevOps, o desenvolvimento de software era um trabalho extremamente manual, que exigia envolvimento humano (e repasses físicos e manuais) em cada etapa do processo. Todo esse envolvimento humano fazia com que as empresas tivessem sorte se conseguissem atualizar ou lançar um novo código uma vez por ano — muitas delas seguiam um ciclo de lançamento de 18 ou 24 meses.</p><p>Hoje, os chamados <a href="/blog/how-to-make-your-devops-team-elite-performers/">“times de DevOps de elite”</a> publicam código várias vezes ao dia — e conseguem fazer isso principalmente graças à automação.</p><p>Para entender o poder e a importância da automação no DevOps, basta pensar nos testes de software: uma etapa frequentemente esquecida e pouco valorizada, mas que costuma levar a culpa por atrasos no lançamento. Não há dúvida de que os testes de software são essenciais; sem eles, as empresas correm o risco de lançar código com falhas ou mesmo códigos inseguros.</p><p>Porém, os testes talvez sejam a etapa mais manual de todo o processo de DevOps, exigindo que as pessoas escrevam casos de teste, executem inúmeros testes, analisem os resultados e, depois, retornem aos desenvolvedores para as correções. De forma resumida, <a href="/blog/want-faster-releases-your-answer-lies-in-automated-software-testing/">não é à toa que os times apontam os testes</a> como o principal motivo pelo qual o código não é lançado no prazo.</p><p>É aí que entra a automação, com a ideia de que os testes de software mais básicos podem acontecer no momento em que o código é escrito. Assim, a automação de testes acelera drasticamente todo o processo e libera os analistas de teste de software para buscar problemas de qualidade de código potencialmente mais graves.</p><p>Embora os testes sejam uma das vitórias mais marcantes da automação no DevOps, eles estão longe de ser a única. A <a href="/pt-br/topics/ci-cd/">integração contínua</a> automatiza o processo de incorporar novo código ao código já existente, enquanto a <a href="/blog/how-to-keep-up-with-ci-cd-best-practices/">implantação contínua</a> ajuda a automatizar os releases. Já o <a href="/pt-br/topics/gitops/infrastructure-as-code/">Infrastructure as Code</a> facilita a automação do processo de provisionamento de ambientes de desenvolvimento.</p><h3 id="colaboração-e-comunicação">Colaboração e comunicação</h3><p>Um bom time de DevOps tem automação, mas um time de DevOps excelente conta também com colaboração e comunicação. A ideia central de unir dev e ops (além de sec, teste, stakeholders etc.) depende da capacidade dos times de colaborar. E isso só é possível quando existe uma comunicação clara e constante.</p><p>Esse pode parecer um princípio simples do DevOps, mas, como quase tudo, a dificuldade está presente nos detalhes. Quem é do time de dev quer escrever código e colocá-lo no ar; quem é de ops foca em ferramentas, compliance e nuvem; e o time de segurança quer garantir que o código seja seguro. Dev, ops e sec não têm as mesmas prioridades, podem não falar a mesma “língua” e tendem a abordar a resolução de problemas sob perspectivas bem diferentes. Um exemplo disso: <a href="/blog/developer-security-divide/">dev e sec ainda não se dão muito bem</a>, em parte porque a lacuna de comunicação e colaboração entre eles permanece grande.</p><p>É preciso esforço para aproximar os times e, muitas vezes, também é preciso <a href="/blog/want-secure-software-development-our-top-5-tips-to-bring-dev-and-sec-together/">pensar fora da caixa</a>. E, em mais uma daquelas situações de “o que veio primeiro: o ovo ou a galinha?”, os times precisam se comunicar para um DevOps bem-sucedido, mas o próprio DevOps também pode levar a uma comunicação melhor e a desenvolvedores mais satisfeitos, segundo os resultados da nossa <a href="/resources/developer-survey/">Pesquisa Global de DevSecOps de 2021</a>.</p><h3 id="melhoria-contínua-e-minimização-de-desperdício">Melhoria contínua e minimização de desperdício</h3><p>Apoiado fortemente em metodologias de desenvolvimento de software anteriores, incluindo <a href="https://searchsoftwarequality.techtarget.com/definition/lean-programming" rel="">Lean</a> e Agile, o DevOps também foca na redução de desperdício e na melhoria contínua. Seja automatizando tarefas repetitivas, como os testes, para não perder tempo, ou reduzindo o número de etapas necessárias para lançar um novo código, times de DevOps bem-estruturados seguem medindo métricas de desempenho para identificar pontos que precisam melhorar.</p><p>Espera-se que os times busquem <a href="/blog/why-improving-continuously-speeds-up-delivery/">melhorar continuamente os tempos de release</a>, reduzir o <a href="https://pipelinedriven.org/article/devops-metric-mean-time-to-recovery-mttr-definition-and-reasoning" rel="">tempo médio de recuperação</a> e o número de bugs encontrados, entre outras métricas.</p><h3 id="foco-intenso-nas-necessidades-do-usuário-com-ciclos-de-feedback-curtos">Foco intenso nas necessidades do usuário, com ciclos de feedback curtos</h3><p>O último princípio essencial do DevOps é a importância de trazer o usuário real para cada etapa do processo. Por meio da automação, da comunicação e colaboração aprimoradas e da melhoria contínua, os times de DevOps conseguem parar por um instante para focar no que os usuários realmente querem — e em como entregar isso a eles. Não há dúvida de que entender a mente do usuário é algo bastante complexo, e <a href="/blog/journey-to-the-outer-loop/">os times podem ter dificuldade em implementar processos</a> para alcançar esse objetivo.</p><p>O outro desafio é que o feedback do usuário, uma vez coletado, precisa ser entregue rapidamente, para que o tempo não seja desperdiçado. É por isso que ciclos de feedback curtos são essenciais, e por isso os times precisam <a href="/blog/journey-to-the-outer-loop/">se dedicar a torná-los ainda mais curtos</a> com o passar do tempo.</p><h2 id="benefícios-de-um-modelo-e-das-práticas-de-devops">Benefícios de um modelo e das práticas de DevOps</h2><p>O que acontece quando os times aplicam o DevOps corretamente? Em nossa pesquisa de 2021, 60% dos desenvolvedores nos disseram que estavam lançando código, pelo menos, duas vezes mais rápido graças ao DevOps. Outros benefícios de um modelo DevOps incluem melhor qualidade de código, tempo de lançamento mais rápido e planejamento mais eficiente.</p><p>E, de bônus, os participantes da pesquisa também nos contaram que ter uma prática de DevOps bem-sucedida deixa os desenvolvedores mais satisfeitos, e existem <a href="/blog/why-software-developer-job-satisfaction-matters-and-how-to-make-it-happen/">dados científicos</a> que mostram que desenvolvedores mais felizes são mais produtivos.</p><h2 id="quais-são-os-desafios-de-implementar-o-devops">Quais são os desafios de implementar o DevOps?</h2><p>O DevOps pode ser desafiador no início, principalmente se for a primeira vez que está sendo implementado em uma organização. Confira alguns dos desafios de implementar o DevOps.</p><ul><li><strong>Quebrar os silos.</strong> Pode ser difícil romper a mentalidade de que desenvolvimento e operações são entidades separadas. Busque entender bem os papéis e as responsabilidades de um time combinado de DevOps.</li><li><strong>Entender os jargões.</strong> O DevOps vem com muitas abreviações, jargões técnicos e uma quantidade enorme de siglas, como CI/CD. Reserve um tempo para estudar e lembre-se de que aprender aos poucos é completamente normal e aceitável.</li><li><strong>Migrar de sistemas legados.</strong> O DevOps pode ser especialmente complicado para times que estão migrando software legado. Muitas ferramentas criadas para DevOps não funcionam com mainframes (só para dar um exemplo), e as integrações podem ser desafiadoras até mesmo para profissionais experientes em DevOps. Também não ajuda o fato de haver escassez de programadores especializados em mainframe e outros sistemas legados.</li><li><strong>Excesso de ferramentas.</strong> Os times gastam tanto tempo integrando e mantendo ferramentas que isso acaba atrapalhando o trabalho real de desenvolver, publicar e monitorar o código. Esse fenômeno é conhecido como “toolchain tax”, o custo oculto da cadeia de ferramentas.</li><li><strong>Lidar com a frustração da curva de aprendizado.</strong> O DevOps é complexo, e aprender como ele funciona é uma maratona, não 100 metros rasos. Tenha paciência e seja compreensivo com o time à medida que a implementação avança, e conte com os recursos disponíveis, como a documentação e representantes da plataforma — e, às vezes, confie no bom e velho processo de tentativa e erro.</li></ul><h2 id="como-começar-a-implementar-o-devops-na-sua-organização">Como começar a implementar o DevOps na sua organização</h2><p>Ao se preparar para começar com o DevOps, é preciso seguir a seguinte preparação:</p><ol><li>Mapeie os objetivos por trás da implementação do DevOps.</li><li>Esclareça os papéis e as responsabilidades de cada participante.</li><li>Comece de forma simples e evolua com a experiência.</li><li>Planeje automatizar o máximo possível.</li><li>Planeje seu toolchain (e lembre-se: toolchains sempre podem ser ajustados).</li><li>Estabeleça checkpoints regulares de progresso.</li><li>Esteja preparado para iterar constantemente (mas só depois de dar tempo suficiente para provar que a iteração é realmente necessária).</li></ol><h2 id="qual-é-o-futuro-do-devops">Qual é o futuro do DevOps?</h2><p>A adoção e o sucesso do DevOps ganharam um enorme impulso graças à pandemia global. Os times superaram parte das questões culturais de “como trabalhar juntos?” e amadureceram para a mentalidade de “como adotar as tecnologias certas?”, segundo os resultados da nossa pesquisa. O uso de tecnologias avançadas, incluindo Kubernetes, <a href="/pt-br/topics/devops-platform/">plataformas de DevOps</a> e inteligência artificial (IA) / machine learning (ML), já dá pistas de como será o futuro do DevOps.</p><p>É seguro esperar mais automação, tomadas de decisão mais inteligentes com IA/ML (começando em áreas como <a href="/blog/the-road-to-smarter-code-reviewer-recommendations/">revisão de código</a>) e uma escolha mais criteriosa de ferramentas, como a adoção contínua de plataformas de DevOps para otimizar o processo.</p>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-09-15T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Claude Code e o GitLab: três fluxos de trabalho que realmente entregam]]></title>
        <id>https://about.gitlab.com/pt-br/blog/claude-code-and-gitlab/</id>
        <link href="https://about.gitlab.com/pt-br/blog/claude-code-and-gitlab/"/>
        <updated>2026-05-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Os desenvolvedores adoram o Claude Code porque utilizá-lo é como programar em dupla com um engenheiro sênior direto no terminal ou na IDE: ele ajuda você a entender código desconhecido, propor correções e estruturar novos recursos rapidamente.</p><p>Contudo, há um padrão que vale observar: quanto melhores ficam as ferramentas de programação com agentes de IA para escrever código, mais o restante do ciclo de vida do software luta para acompanhar o ritmo. O backlog de bugs cresce. As taxas de falha nos pipelines crescem e as vulnerabilidades de segurança se acumulam mais rápido do que os times conseguem classificá-las. Isso mostra que programar e entregar um software não são a mesma coisa, e essa diferença entre os dois é real.</p><p>É neste ponto que o GitLab entra para acelerar tudo o que vem depois do Claude Code no restante do ciclo de vida do software: CI/CD, verificação de segurança, revisão de código e aprovações, tudo em um só lugar, com um fluxo auditável.</p><p>Este tutorial apresenta três cenários nos quais o Claude Code avança rápido na base de código, enquanto o GitLab cuida de tudo o que transforma esse código em uma mudança certificada e entregue:</p><ul><li>Corrija um bug em C++ com o Claude Code e deixe que o GitLab CI/CD, a verificação de segurança e o Duo Code Review sigam a partir daí.</li><li>Adicione contexto do GitLab via MCP para que o Claude trabalhe a partir do tíquete real, e não apenas dos arquivos locais.</li><li>Use um agente externo do Claude no Duo Agent Platform para resolver o feedback de revisão de código diretamente na merge request - MR.</li></ul><h2 id="pré-requisitos">Pré-requisitos</h2><ol><li><a href="https://code.claude.com/docs/pt/overview" rel="">Claude Code</a> no terminal, configurado e em execução.</li><li>Um projeto GitLab com relatos de bugs e issues de proposta de recursos — por exemplo, o <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform" rel="">projeto Tanuki Iot Platform</a>.</li><li>Para casos de uso específicos: o <a href="https://docs.gitlab.com/user/gitlab_duo/model_context_protocol/mcp_server/" rel="">servidor MCP do GitLab</a> e o GitLab Duo Agent Platform com <a href="https://docs.gitlab.com/user/duo_agent_platform/agents/external/" rel="">agentes externos</a>.</li><li>Para compilar o código: CMake, Make, gcc/clang++ para C++, Maven para Java.</li></ol><h3 id="prepare-o-projeto-gitlab">Prepare o projeto GitLab</h3><p>Se quiser acompanhar o tutorial, você pode repetir todas as etapas aqui no seu próprio ambiente de desenvolvimento. Para isso:</p><ul><li>Importe o <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform" rel="">projeto Tanuki Iot Platform</a> para o seu ambiente GitLab, incluindo todos os issues abertos.</li><li>Clone o projeto no seu ambiente local e navegue até ele.</li><li>Abra um terminal e execute o Claude Code com <code>claude</code>.</li></ul><pre className="language-shell shiki shiki-themes github-light" code="git clone https://gitlab.example.com/examplegroup/tanuki-iot-platform.git
cd tanuki-iot-platform

claude
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">git</span><span class="sYBdl"> clone</span><span class="sYBdl"> https://gitlab.example.com/examplegroup/tanuki-iot-platform.git
</span></span><span class="line" line="2"><span class="sYu0t">cd</span><span class="sYBdl"> tanuki-iot-platform
</span></span><span class="line" line="3"><span emptyLinePlaceholder>
</span></span><span class="line" line="4"><span class="s7eDp">claude
</span></span></code></pre><p>Faça uma pergunta no prompt para saber mais sobre a finalidade do projeto.</p><pre className="language-markdown shiki shiki-themes github-light" code="Sobre o que é este projeto?
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">Sobre o que é este projeto?
</span></span></code></pre><h2 id="comece-a-usar-o-claude-code-com-o-gitlab">Comece a usar o Claude Code com o GitLab</h2><p>No nosso primeiro cenário, precisamos corrigir um sensor de hardware escrito em C++. O coletor Arduino lê métricas da placa Arduino Uno R4 conectada via USB e trava quando o dispositivo <code>/dev/ttyACM0</code> não está conectado.</p><p><img alt="Issue do GitLab mostrando o relato de bug do travamento do coletor IoT Arduino" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079018/itfnec4qrlldxfftwnig.png" title="Issue do GitLab mostrando o relato de bug do travamento do coletor IoT Arduino" /></p><p>Depois de ler o relato de bug no <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform/-/work_items/4" rel="">Issue 4</a>, inspecione o código no arquivo <code>main.cpp</code>, por exemplo, usando o vim:</p><pre className="language-shell shiki shiki-themes github-light" code="vim sensors/arduino-iot-collector/src/main.cpp
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">vim</span><span class="sYBdl"> sensors/arduino-iot-collector/src/main.cpp
</span></span></code></pre><p><img alt="Código-fonte do Arduino IoT Collector aberto no vim" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079018/mjof3rgdlxjy2trmgehq.png" title="Código-fonte do Arduino IoT Collector aberto no vim" /></p><p>Compile e execute o binário do coletor com o <a href="https://cmake.org/" rel="">CMake</a> para reproduzir o problema.</p><pre className="language-shell shiki shiki-themes github-light" code="cmake -S . -B build
cmake --build build

./build/arduino_iot_collector
Starting Arduino IoT Collector Application...
libc++abi: terminating due to uncaught exception of type std::runtime_error: Failed to initialize Arduino temperature sensor: Arduino port not found: /dev/ttyACM0
[1]    85289 abort      ./build/arduino_iot_collector
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">cmake</span><span class="sYu0t"> -S</span><span class="sYBdl"> .</span><span class="sYu0t"> -B</span><span class="sYBdl"> build
</span></span><span class="line" line="2"><span class="s7eDp">cmake</span><span class="sYu0t"> --build</span><span class="sYBdl"> build
</span></span><span class="line" line="3"><span emptyLinePlaceholder>
</span></span><span class="line" line="4"><span class="s7eDp">./build/arduino_iot_collector
</span></span><span class="line" line="5"><span class="s7eDp">Starting</span><span class="sYBdl"> Arduino</span><span class="sYBdl"> IoT</span><span class="sYBdl"> Collector</span><span class="sYBdl"> Application...
</span></span><span class="line" line="6"><span class="s7eDp">libc++abi:</span><span class="sYBdl"> terminating</span><span class="sYBdl"> due</span><span class="sYBdl"> to</span><span class="sYBdl"> uncaught</span><span class="sYBdl"> exception</span><span class="sYBdl"> of</span><span class="sYBdl"> type</span><span class="sYBdl"> std::runtime_error:</span><span class="sYBdl"> Failed</span><span class="sYBdl"> to</span><span class="sYBdl"> initialize</span><span class="sYBdl"> Arduino</span><span class="sYBdl"> temperature</span><span class="sYBdl"> sensor:</span><span class="sYBdl"> Arduino</span><span class="sYBdl"> port</span><span class="sYBdl"> not</span><span class="sYBdl"> found:</span><span class="sYBdl"> /dev/ttyACM0
</span></span><span class="line" line="7"><span class="sgsFI">[1]    85289 abort      ./build/arduino_iot_collector
</span></span></code></pre><p>Abra o Claude Code e insira o seguinte pedido:</p><pre className="language-markdown shiki shiki-themes github-light" code="Pode me ajudar a corrigir o sensor do Arduino IoT Collector? Ele está travando.
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">Pode me ajudar a corrigir o sensor do Arduino IoT Collector? Ele está travando.
</span></span></code></pre><p>O Claude Code pesquisa a base de código (codebase) e identifica o problema no arquivo <code>main.cpp</code>, que lança uma exceção <code>std::runtime_error()</code>, fazendo a aplicação travar imediatamente. O comportamento esperado é registrar um erro de configuração amigável ao usuário e continuar executando a aplicação normalmente.</p><p>Depois de corrigir e compilar o código com sucesso, precisamos criar uma branch do Git, um commit e uma merge request para disparar os pipelines de CI/CD, a verificação de segurança e os fluxos de revisão de código.</p><p>Você pode usar diferentes formas de trabalhar com o Git no Claude Code:</p><ul><li>Usar um prompt: <code>Pode me ajudar a criar uma branch do Git, fazer o commit e enviar as alterações?</code></li><li>Executar os comandos do shell: abra o prompt de comando com <code>!</code>, seguido dos comandos <code>git checkout -b fix-arduino-sensor</code>, <code>git commit -avm &quot;...&quot;</code> e <code>git push</code>. A saída do <code>git push</code> gera uma URL de criação da merge request. Clique nela para abrir o navegador e preencher o formulário.</li></ul><p>Os pipelines de CI/CD são disparados na criação da MR e verificam se o build e os testes estão funcionando. A verificação de segurança garante que nenhuma vulnerabilidade nova seja introduzida. A nova MR dispara automaticamente o <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/foundational_flows/code_review/" rel="">GitLab Duo Code Review Flow</a>, que avalia a precisão da correção, de acordo com os guias de estilo de desenvolvimento e as instruções de revisão personalizadas.</p><p><img alt="Instruções personalizadas do GitLab Duo Code Review para C++" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079019/wasta2rqivrvrsjtw1jv.png" title="Instruções personalizadas do GitLab Duo Code Review para C++" /></p><p><img alt="Comentário com feedback do GitLab Duo Code Review Flow" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079019/r2oalo1xwkpbmeispflo.png" title="Comentário com feedback do GitLab Duo Code Review Flow" /></p><p>Veja abaixo uma gravação do Claude Code, do GitLab CI/CD e do GitLab Duo Agent Platform em ação:</p><figure className="video_container">
  <iframe src="https://www.youtube.com/embed/JH4Sae3eDpw" frameBorder="0" allowFullScreen="true"> </iframe></figure><h2 id="corrigindo-um-bug-em-c-com-o-gitlab-mcp-no-claude-code">Corrigindo um bug em C++ com o GitLab MCP no Claude Code</h2><p>No cenário anterior, o Claude Code pesquisou o repositório de código local e fez suposições sobre uma possível correção com base no contexto disponível. No entanto, ele não tinha conhecimento do issue do GitLab que descrevia o bug, das discussões para a sua depuração e das soluções propostas para resolver o problema em definitivo. Além disso, ele também não levou em conta o histórico de alterações de código anteriores salvas em merge requests e issues com relatos parecidos, que são parte importante do contexto do ciclo de vida do desenvolvimento de software (SDLC).</p><p>Para permitir a utilização desse contexto rico do SDLC do GitLab, podemos integrar o <a href="https://docs.gitlab.com/user/gitlab_duo/model_context_protocol/mcp_server/" rel="">servidor MCP do GitLab</a> para o Claude Code.</p><h3 id="configure-o-servidor-mcp-do-gitlab">Configure o servidor MCP do GitLab</h3><p>Confirme que o servidor MCP do GitLab está <a href="https://docs.gitlab.com/user/gitlab_duo/model_context_protocol/mcp_server/#prerequisites" rel="">habilitado</a> na instância ou no grupo de nível superior.</p><p>Abra um novo terminal e adicione o <a href="https://docs.gitlab.com/user/gitlab_duo/model_context_protocol/mcp_server/" rel="">servidor MCP do GitLab</a> ao Claude Code usando o tipo de transporte <code>http</code>.</p><p>Substitua <code>gitlab.example.com</code> pela sua instância do GitLab ou use <code>GitLab.com</code>:</p><pre className="language-shell shiki shiki-themes github-light" code="claude mcp add --transport http GitLab https://gitlab.example.com/api/v4/mcp
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">claude</span><span class="sYBdl"> mcp</span><span class="sYBdl"> add</span><span class="sYu0t"> --transport</span><span class="sYBdl"> http</span><span class="sYBdl"> GitLab</span><span class="sYBdl"> https://gitlab.example.com/api/v4/mcp
</span></span></code></pre><p>Execute <code>claude</code> em uma nova sessão do terminal e digite <code>/mcp</code> para autenticar com o servidor MCP do GitLab, usando OAuth na página do navegador que será aberta.</p><pre className="language-shell shiki shiki-themes github-light" code="claude

/mcp
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">claude
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="s7eDp">/mcp
</span></span></code></pre><p>Para verificar a conexão, pergunte ao Claude:</p><pre className="language-markdown shiki shiki-themes github-light" code="Quais ferramentas MCP do GitLab estão disponíveis para você?

Mostre a versão do servidor MCP do GitLab
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">Quais ferramentas MCP do GitLab estão disponíveis para você?
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">Mostre a versão do servidor MCP do GitLab
</span></span></code></pre><p><img alt="Claude Code investigando a versão do servidor MCP do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079019/f2ygt6wuuvxxbpticcgt.png" title="Claude Code investigando a versão do servidor MCP do GitLab" /></p><p>Ao autenticar o Claude Code com o servidor MCP do GitLab, a conexão passa pelo <a href="https://datatracker.ietf.org/doc/html/rfc7591" rel="">OAuth</a> e atua com a sua identidade já existente no GitLab e não com permissões elevadas ou separadas. Na prática, isso significa que o Claude Code só consegue ver projetos, issues (tíquetes), merge requests e outros dados do GitLab que você já tem acesso, seja pela sua conta ou seja pela sua participação em projetos e grupos. Essa é uma importante barreira de proteção: o MCP amplia o contexto dentro da ferramenta de IA, mas não contorna os controles de visibilidade do GitLab nem cria um acesso mais amplo por conta própria.</p><p>Uma segunda barreira de proteção é a aprovação do usuário. Nesse fluxo, o Claude Code identifica a ferramenta MCP que quer chamar e pede aprovação antes de seguir adiante, para que os desenvolvedores continuem no controle sempre que um contexto externo é buscado. Em ambientes sensíveis à segurança, também vale reforçar que os times devem ficar atentos aos dados expostos nos prompts e usar o MCP principalmente com conteúdo confiável do GitLab.</p><h3 id="trabalhe-em-um-issue-de-relato-de-bug">Trabalhe em um issue de relato de bug</h3><p>Vamos buscar o contexto do issue no Claude Code referenciando o <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform/-/work_items/4" rel="">Issue 4</a> no prompt. Se você não tiver um issue no seu projeto, clone/copie o Issue 4 e ajuste o número no prompt.</p><pre className="language-markdown shiki shiki-themes github-light" code="Pode me ajudar a corrigir o issue 4?
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">Pode me ajudar a corrigir o issue 4?
</span></span></code></pre><p>O Claude Code identifica a necessidade de chamar a ferramenta MCP <code>get_issue</code> e pede a sua aprovação, sendo que também é possível aprovar o uso futuro automaticamente.</p><p><img alt="Claude Code buscando o contexto do issue com ferramentas MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079021/tj6dpxbemvvgqnbifzjy.png" title="Claude Code buscando o contexto do issue com ferramentas MCP" /></p><p>Depois que o Claude Code buscar o contexto necessário do issue, ele começa a analisar diretamente o código-fonte em C++ do sensor. Depois de criar e verificar uma correção, você pode pedir para criar uma nova branch do Git, um commit e uma MR, caso o Claude Code ainda não o faça automaticamente.</p><pre className="language-markdown shiki shiki-themes github-light" code="Pode criar uma nova branch do Git, fazer o commit das alterações e criar uma nova merge request?
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">Pode criar uma nova branch do Git, fazer o commit das alterações e criar uma nova merge request?
</span></span></code></pre><p>O Claude Code encontra a ferramenta MCP <code>create_merge_request</code> e cuida da criação da MR diretamente, sem precisar trocar de contexto para o navegador.</p><p><img alt="Claude Code criou uma MR usando ferramentas MCP, vinculada ao Issue 4" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079021/bo41ti93yonvsy9q2gbw.png" title="Claude Code criou uma MR usando ferramentas MCP, vinculada ao Issue 4" /></p><p>No GitLab, o evento de criação da MR dispara automaticamente vários fluxos de trabalho em paralelo:</p><ul><li>pipeline de CI/CD para builds e testes automatizados</li><li>verificação de segurança com o <a href="https://docs.gitlab.com/user/application_security/sast/advanced_sast_cpp/" rel="">Advanced SAST para C++</a></li><li>um <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/foundational_flows/code_review/" rel="">Code Review Flow</a> pelo GitLab Duo Agent Platform</li></ul><p>Esses fluxos de trabalho automatizados e agênticos dentro do GitLab aceleram a entrega de software tanto quanto o Claude Code acelera o desenvolvimento com IA para a resolução de issues.</p><p><img alt="Status do pipeline de CI/CD na MR - testes e verificação de segurança" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079022/yd3kzf9yp4usdldovs1a.png" title="Status do pipeline de CI/CD na MR - testes e verificação de segurança" /></p><p>Você pode abrir a Merge Request no navegador ou continuar no terminal e enviar o seguinte prompt ao Claude Code:</p><pre className="language-markdown shiki shiki-themes github-light" code="A Merge Request está sendo executada corretamente?
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">A Merge Request está sendo executada corretamente?
</span></span></code></pre><p>Ele vai usar a ferramenta MCP <code>get_merge_request_pipelines</code> para buscar o status do pipeline da MR, confirmando que está verde e pronto para o merge.</p><p><img alt="Claude Code buscando o status do pipeline da MR usando ferramentas MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079019/s8cwcvc3r5moui2twjpd.png" title="Claude Code buscando o status do pipeline da MR usando ferramentas MCP" /></p><p>Veja a gravação para ver como o Claude Code resolve o problema com a ajuda do servidor MCP do GitLab:</p><figure className="video_container">
  <iframe src="https://www.youtube.com/embed/q8XWnmdIaI0" frameBorder="0" allowFullScreen="true"> </iframe></figure><h2 id="claude-code-como-agente-externo-revisor">Claude Code como agente externo revisor</h2><p>Neste último cenário, o Claude Code ajudou a implementar um novo recurso com base nos requisitos do <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform/-/work_items/24" rel="">Issue 24</a> — um servidor de API Spring Boot com backend REST/Websocket. Os pipelines de CI/CD e as verificações de segurança estão OK, mas há feedback de revisão de código esperando na MR.</p><p><img alt="Feedback do GitLab Duo Code Review na MR do servidor de API Spring Boot" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079022/to7zvyrarrvcnyuuzldi.png" title="Feedback do GitLab Duo Code Review na MR do servidor de API Spring Boot" /></p><p>Você pode adicionar o Claude Code como parceiro de colaboração em issues, epics e MRs e resolver tarefas em conjunto. Siga a <a href="https://docs.gitlab.com/user/duo_agent_platform/agents/external/" rel="">documentação de agentes externos</a> para conhecer os pré-requisitos.</p><p>Ative o <code>Claude Agent by GitLab</code> no menu do projeto, em <strong>AI &gt; Agents</strong>. Anote o nome da conta de serviço para saber como mencionar ou atribuir o agente depois — ele segue o padrão: <code>@ai-&lt;nome-do-agente&gt;-&lt;nome-do-grupo-de-nível-superior&gt;</code>.</p><p>Em seguida, abra a MR com o feedback de revisão de código e analise as alterações solicitadas. A captura de tela usa a <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform/-/merge_requests/78" rel="">MR 78</a>, e o GitLab Duo Code Review segue as <a href="https://docs.gitlab.com/user/duo_agent_platform/customize/review_instructions/?tab=Java" rel="">instruções de revisão personalizadas para Java</a>.</p><p><img alt="Feedback do GitLab Duo Code Review Flow sobre AllowedOriginPatterns inseguro nos endpoints de API introduzidos na MR" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079039/gvgqmcnijllptvnnyyjc.png" title="Feedback do GitLab Duo Code Review Flow sobre AllowedOriginPatterns inseguro nos endpoints de API introduzidos na MR" /></p><p>Crie um novo comentário mencionando o Claude Code Agent:</p><pre className="language-markdown shiki shiki-themes github-light" code="@ai-claude-agent-by-gitlab-&lt;nome-do-grupo-de-nível-superior&gt; Pode me ajudar a resolver o feedback da revisão?
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">@ai-claude-agent-by-gitlab-&lt;nome-do-grupo-de-nível-superior&gt; Pode me ajudar a resolver o feedback da revisão?
</span></span></code></pre><p>Essa menção inicia uma nova sessão de agente em segundo plano, configurando o Claude Code Agent, que passa a trabalhar no feedback da revisão. Quando termina, ele segue as instruções para criar um commit no Git e um comentário com um resumo na MR.</p><p><img alt="Feedback do GitLab Duo Code Review resolvido pelo Claude Agent" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079038/pqy8f4xo8n0i7yvkajso.png" title="Feedback do GitLab Duo Code Review resolvido pelo Claude Agent" /></p><p>Para garantir que o desenvolvimento de software permaneça dentro das diretrizes de proteção da sua organização, seus próximos passos incluem:</p><ul><li>Resolver o feedback de revisão restante.</li><li>Revisar o aviso nos jobs do pipeline de CI/CD.</li><li>Revisar as possíveis vulnerabilidades de segurança, usando, por exemplo, a <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/foundational_flows/agentic_sast_vulnerability_resolution/" rel="">Resolução de vulnerabilidades SAST</a>.</li><li>Obter a aprovação da merge request de um desenvolvedor elegível, configurado como <a href="https://docs.gitlab.com/user/project/codeowners/" rel="">Code Owner</a>.</li></ul><p><img alt="Widgets da merge request mostrando o pipeline de CI/CD, as aprovações exigidas, os achados de segurança e o status do merge" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1778079039/uzegwykldauzuxucrpjf.png" title="Widgets da merge request mostrando o pipeline de CI/CD, as aprovações exigidas, os achados de segurança e o status do merge" /></p><p>Assista a este vídeo para aprender como o Claude Code pode ajudar com revisões como agente externo no GitLab Duo Agent Platform:</p><figure className="video_container">
  <iframe src="https://www.youtube.com/embed/Tw0wNet1HCc" frameBorder="0" allowFullScreen="true"> </iframe></figure><h2 id="dicas-para-usar-o-claude-code-com-o-gitlab">Dicas para usar o Claude Code com o GitLab</h2><h3 id="instruções-personalizadas">Instruções personalizadas</h3><p>É possível instruir os agentes a compilar e testar o código antes dos commits, manter as alterações mínimas ou entender melhor a arquitetura do projeto usando uma entrada no <code>AGENTS.md</code>. O Tanuki IoT Platform usa o <a href="https://gitlab.com/gitlab-da/use-cases/ai/gitlab-duo-agent-platform/demo-environments/tanuki-iot-platform/-/blob/main/AGENTS.md?ref_type=heads&amp;plain=1" rel="">seguinte exemplo de produção</a>:</p><pre className="language-markdown shiki shiki-themes github-light" code="## Working with sensors

### Before editing
1. Identify the sensor directory you&#39;re working with
2. Check for an `AGENTS.md` file in that directory
3. Read sensor-specific instructions before making changes
4. Follow language-specific style guides

### Making changes
- Keep changes minimal and focused on the user request
- Do not refactor existing code unless specifically instructed
- Preserve original code formatting
- Only modify code necessary to solve the specific request

### Creating MRs
- Always run local builds and tests first
- Create a new branch for changes
- Automatically create a merge request after successful commits
- Reference relevant issues or tasks in the MR description
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="surfw">## Working with sensors
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="surfw">### Before editing
</span></span><span class="line" line="4"><span class="sqxcx">1.</span><span class="sgsFI"> Identify the sensor directory you&#39;re working with
</span></span><span class="line" line="5"><span class="sqxcx">2.</span><span class="sgsFI"> Check for an </span><span class="sYu0t">`AGENTS.md`</span><span class="sgsFI"> file in that directory
</span></span><span class="line" line="6"><span class="sqxcx">3.</span><span class="sgsFI"> Read sensor-specific instructions before making changes
</span></span><span class="line" line="7"><span class="sqxcx">4.</span><span class="sgsFI"> Follow language-specific style guides
</span></span><span class="line" line="8"><span emptyLinePlaceholder>
</span></span><span class="line" line="9"><span class="surfw">### Making changes
</span></span><span class="line" line="10"><span class="sqxcx">-</span><span class="sgsFI"> Keep changes minimal and focused on the user request
</span></span><span class="line" line="11"><span class="sqxcx">-</span><span class="sgsFI"> Do not refactor existing code unless specifically instructed
</span></span><span class="line" line="12"><span class="sqxcx">-</span><span class="sgsFI"> Preserve original code formatting
</span></span><span class="line" line="13"><span class="sqxcx">-</span><span class="sgsFI"> Only modify code necessary to solve the specific request
</span></span><span class="line" line="14"><span emptyLinePlaceholder>
</span></span><span class="line" line="15"><span class="surfw">### Creating MRs
</span></span><span class="line" line="16"><span class="sqxcx">-</span><span class="sgsFI"> Always run local builds and tests first
</span></span><span class="line" line="17"><span class="sqxcx">-</span><span class="sgsFI"> Create a new branch for changes
</span></span><span class="line" line="18"><span class="sqxcx">-</span><span class="sgsFI"> Automatically create a merge request after successful commits
</span></span><span class="line" line="19"><span class="sqxcx">-</span><span class="sgsFI"> Reference relevant issues or tasks in the MR description
</span></span></code></pre><p>Essas <a href="https://docs.gitlab.com/user/duo_agent_platform/customize/agents_md/" rel="">instruções personalizadas</a> também são processadas por agentes e flows no GitLab Duo Agent Platform.</p><p>O Claude Code prefere o <code>CLAUDE.md</code>, que também pode ser apontado para o <code>AGENTS.md</code>.</p><pre className="language-markdown shiki shiki-themes github-light" code="@AGENTS.md
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">@AGENTS.md
</span></span></code></pre><h2 id="resumo">Resumo</h2><p>As ferramentas de programação com IA tornam as equipes de desenvolvedores mais rápidas na hora de programar. Porém, escrever código e entregar software não são a mesma coisa, e essa diferença entre os dois cresce justamente porque as ferramentas são muito boas na primeira parte. Com elas, mais código é escrito, mas o backlog de bugs aumenta, as taxas de falha nos pipelines sobem e as vulnerabilidades de segurança se acumulam.</p><p>O Claude Code mantém a produtividade onde o código se localiza: entende bases de código desconhecidas, propõe correções e estrutura novos recursos rapidamente. O GitLab Duo Agent Platform é o que transforma essa velocidade — de muitos desenvolvedores em times de software de organizações empresariais — em software seguro que você realmente pode entregar e certificar em diversos marcos de release e projetos. Com o GitLab, o restante do ciclo de vida do software (como as correções no pipeline de CI/CD, a verificação de segurança, a remediação automatizada, revisão de código e muito mais, com fluxos de trabalho que mantêm humanos no controle) permite que cada ação dos agentes de IA seja rastreada e configurada para funcionar dentro das diretrizes de proteção e políticas de segurança da sua organização.</p><p>Neste tutorial, você viu três formas de unir o Claude Code e o GitLab Duo Agent Platform:</p><ul><li>Corrigir um bug com o Claude Code e deixar que o GitLab CI/CD, a verificação de segurança e o Duo Code Review façam o resto.</li><li>Adicionar contexto do GitLab via MCP para que o Claude trabalhe a partir do contexto real salvo no issue do GitLab, e não apenas dos arquivos locais.</li><li>Usar um agente externo com tecnologia Claude no GitLab Duo Agent Platform para resolver o feedback de revisão diretamente na MR.</li></ul><p>O princípio se mantém o mesmo nos três casos: o Claude avança rápido, o GitLab certifica o trabalho.</p><blockquote><p>Se você ainda não usa o GitLab Duo Agent Platform, pode começar com um <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">teste gratuito da ferramenta</a>.</p><p>Se você já usa o GitLab no plano gratuito, pode assinar o GitLab Duo Agent Platform <a href="https://docs.gitlab.com/subscriptions/gitlab_credits/#for-the-free-tier-on-gitlabcom" rel="">seguindo alguns passos simples</a>.</p><p>E se você já é assinante do GitLab Premium ou Ultimate, basta <a href="https://docs.gitlab.com/user/duo_agent_platform/turn_on_off/" rel="">ativar o Duo Agent Platform</a> e começar a usar os GitLab Credits <a href="https://docs.gitlab.com/subscriptions/gitlab_credits/#included-credits" rel="">incluídos</a> na sua assinatura.</p></blockquote><style>html pre.shiki code .s7eDp, html code.shiki .s7eDp{--shiki-default:#6F42C1}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}html pre.shiki code .sYu0t, html code.shiki .sYu0t{--shiki-default:#005CC5}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .surfw, html code.shiki .surfw{--shiki-default:#005CC5;--shiki-default-font-weight:bold}html pre.shiki code .sqxcx, html code.shiki .sqxcx{--shiki-default:#E36209}</style>]]></content>
        <author>
            <name>Michael Friedrich</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/michael-friedrich/</uri>
        </author>
        <published>2026-05-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Saiba como automatizar a detecção de ameaças cibernéticas com o GitLab CI/CD]]></title>
        <id>https://about.gitlab.com/pt-br/blog/automating-cybersecurity-threat-detections-with-gitlab-ci-cd/</id>
        <link href="https://about.gitlab.com/pt-br/blog/automating-cybersecurity-threat-detections-with-gitlab-ci-cd/"/>
        <updated>2025-01-29T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p><em>Este post é o segundo de uma série sobre o <a href="https://about.gitlab.com/pt-br/blog/unveiling-the-guard-framework-to-automate-security-detections-at-gitlab/" rel="">GitLab Universal Automated Response and Detection (GUARD)</a>.</em></p><p>Escrever e implantar detecções de ameaças de segurança na plataforma de gestão de eventos e informações de segurança (SIEM) de uma organização é um passo essencial de todo programa de cibersegurança bem-sucedido. Isto é, sair de uma engenharia de detecção manual e migrar para um processo totalmente automatizado, implementando Detecções como Código (DaC), garante consistência, qualidade, governança e a realização de testes automatizados nas detecções. No GitLab, incorporamos capacidades de DaC ao GUARD, o nosso framework totalmente automatizado de detecção e resposta.</p><h2 id="o-problema-controle-de-versão-e-testes-automatizados">O problema: controle de versão e testes automatizados</h2><p>Os times de Signals Engineering e <a href="https://handbook.gitlab.com/handbook/security/security-operations/sirt/" rel="">SIRT</a> do GitLab dividem a responsabilidade de criar, atualizar e desativar detecções de ameaças no nosso SIEM. Manter uma única fonte confiável para as detecções é fundamental para garantir consistência e atender aos padrões de qualidade. Por isso, nossos times optaram de forma consciente por abstrair o processo de criação de detecções do nosso SIEM, o que melhorou o rastreamento de issues, a consistência, o processo de rollback e as métricas. Além disso, realizar testes de detecção pré-commit fora do SIEM garantiu que as novas detecções não introduzissem alertas com excesso de falsos positivos, que exigiriam ajustes ou desativação enquanto o alerta fosse corrigido.</p><h2 id="a-solução-usar-o-gitlab-cicd-para-testar-e-validar-detecções">A solução: usar o GitLab CI/CD para testar e validar detecções</h2><p>Para enfrentar esses desafios, desenvolvemos um fluxo de trabalho eficiente usando o <a href="https://about.gitlab.com/pt-br/topics/ci-cd/" rel="">CI/CD</a> do GitLab, resultando em um processo de implantação de detecções no SIEM mais simples e seguro.</p><h3 id="principais-componentes-do-pipeline-de-dac-do-guard">Principais componentes do pipeline de DaC do GUARD</h3><p><strong>1. Detecções armazenadas em formato JSON em um projeto GitLab</strong></p><p>O GitLab usa o formato JSON para as nossas detecções de ameaças. O template inclui informações essenciais, como a lógica de consulta ao SIEM, o título e a descrição da detecção, além do link para a página do runbook, a tática e a técnica MITRE relacionadas à detecção e outros detalhes necessários.</p><p><strong>2. Iniciando merge requests</strong></p><p>Quando um membro do time do GitLab pretende criar uma nova detecção de ameaça, atualizar uma detecção já existente ou excluir uma detecção atual, o processo começa com o envio de uma merge request - MR no projeto de DaC, contendo o template JSON da detecção. A criação da MR dispara automaticamente um pipeline de CI/CD.</p><p><strong>3. Validação automatizada com jobs de CI/CD</strong></p><p>Cada MR passa por uma série de verificações automatizadas por meio do GitLab CI/CD:</p><ul><li>A validação do formato da consulta faz uma chamada à API do SIEM para garantir que a consulta de detecção seja válida.</li><li>A validação dos campos JSON da detecção confirma que todos os campos obrigatórios estão presentes e no formato correto.</li><li>Novas detecções e modificações em detecções disparam uma série de chamadas à API do SIEM para garantir que a detecção não tenha erros e que nenhum problema seja introduzido nas nossas regras de detecção em produção.</li><li>MRs de exclusão de detecção disparam o pipeline para fazer uma consulta à API do SIEM, garantindo que a detecção a ser excluída ainda esteja ativa e possa realmente ser removida.</li></ul><p><strong>4. Revisão por pares e aprovação</strong></p><p>Quando o job de uma MR de detecção é concluído com sucesso, uma revisão por pares é exigida para confirmar que a MR atende aos padrões de qualidade e conteúdo exigidos antes que ela possa ser mesclada. As <a href="https://docs.gitlab.com/user/project/merge_requests/approvals/rules/" rel="">regras de aprovação de merge request</a> são usadas para disparar o processo de revisão por pares.</p><p><strong>5. Merge e implantação final</strong></p><p>Depois que a MR é aprovada, ela é mesclada na branch principal. Como parte do <a href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/" rel="">pipeline de CI/CD</a>, um job automatizado executa um comando na API do SIEM para realizar duas tarefas:</p><ul><li>Criar a nova detecção ou atualizar/excluir a detecção existente, conforme necessário.</li><li>Extrair as informações de tática e técnica do MITRE ATT&amp;CK relacionadas ao alerta a partir dos arquivos JSON e enviá-las para uma tabela de referência dentro do SIEM. Essa tabela de referência tem um papel importante ao mapear nossos alertas às táticas e técnicas do MITRE, ajudando a melhorar a nossa análise de ameaças e a identificar lacunas nas nossas capacidades de detecção, em alinhamento com o framework MITRE.</li></ul><p><strong>Observação:</strong> as credenciais necessárias para essas ações ficam armazenadas com segurança em <a href="https://docs.gitlab.com/ci/variables/" rel="">variáveis de CI/CD</a>, o que garante que o processo permaneça confidencial e seguro.</p><p>Veja abaixo um arquivo de configuração <code>gitlab-ci.yml</code> de exemplo para um pipeline de DaC no GitLab CI/CD:</p><pre className="language-text" code="

#
---------------------------------------------------------------------------
#

# GitLab CI/CD Pipeline for SIEM Detection Management

#
---------------------------------------------------------------------------
#


image: python:3.12


#
---------------------------------------------------------------------------
#

# Global Configuration

#
---------------------------------------------------------------------------
#


before_script:
  - apt-get update &amp;&amp; apt-get install -y jq
  - pip install --upgrade pip
  - pip install -r requirements.txt

#
---------------------------------------------------------------------------
#


stages:
  - fetch
  - test
  - process
  - upload

#
---------------------------------------------------------------------------
#

# Fetch Stage

#
---------------------------------------------------------------------------
#


fetch_changed_files:
  stage: fetch
  Script:
    - echo &quot;Fetching changed files...&quot;
    - git branch
    - git fetch origin $CI_DEFAULT_BRANCH:$CI_DEFAULT_BRANCH --depth 2000
    - |
      if [[ &quot;$CI_COMMIT_BRANCH&quot; == &quot;$CI_DEFAULT_BRANCH&quot; ]]; then
        git diff --name-status HEAD^1...HEAD &gt; changed-files-temp.txt
      else
        git fetch origin $CI_COMMIT_BRANCH:$CI_COMMIT_BRANCH --depth 2000
        git diff --name-status ${CI_DEFAULT_BRANCH}...${CI_COMMIT_SHA} &gt; changed-files-temp.txt
      fi
    - grep -E &#39;\.json$&#39; changed-files-temp.txt &gt; changed-files.txt || true
    - flake8 .
    - pytest
  artifacts:
    paths:
      - changed-files.txt
    expose_as: &#39;changed_files&#39;

#
---------------------------------------------------------------------------
#

# Test Stage

#
---------------------------------------------------------------------------
#


flake8:
  stage: test
  script:
    - echo &quot;Running Flake8 for linting...&quot;
    - flake8 .

pytest:
  stage: test
  script:
    - echo &quot;Running Pytest for unit tests...&quot;
    - pytest
  artifacts:
    when: always
    reports:
      junit: report.xml

#
---------------------------------------------------------------------------
#

# Process Stage

#
---------------------------------------------------------------------------
#


process_files:
  stage: process
  script:
    - echo &quot;Processing changed files...&quot;
    - git clone --depth 2000 --branch $CI_DEFAULT_BRANCH $CI_REPOSITORY_URL
    - mkdir -p modified_rules delete_file new_file
    - python3 move-files.py -x changed-files.txt
    - python3 check-alerts-format.py
  artifacts:
    paths:
      - modified_rules
      - delete_file
      - new_file
#
---------------------------------------------------------------------------
#

# Upload Stage

#
---------------------------------------------------------------------------
#


update_rules:
  stage: upload
  script:
    - echo &quot;Uploading updated rules and lookup tables...&quot;
    - git fetch origin $CI_DEFAULT_BRANCH:$CI_DEFAULT_BRANCH --depth 2000
    - git clone --depth 2000 --branch $CI_DEFAULT_BRANCH $CI_REPOSITORY_URL 
    - python3 update-rules.py
    - python3 update-exceptions.py
    - python3 create_ttps_layers.py
  rules:
    - if: $CI_COMMIT_BRANCH == &quot;main&quot; &amp;&amp; $CI_PIPELINE_SOURCE != &quot;schedule&quot;
      changes:
        - detections/**/*
        - exceptions/**/*
" language="text" meta=""><code>

#
---------------------------------------------------------------------------
#

# GitLab CI/CD Pipeline for SIEM Detection Management

#
---------------------------------------------------------------------------
#


image: python:3.12


#
---------------------------------------------------------------------------
#

# Global Configuration

#
---------------------------------------------------------------------------
#


before_script:
  - apt-get update &amp;&amp; apt-get install -y jq
  - pip install --upgrade pip
  - pip install -r requirements.txt

#
---------------------------------------------------------------------------
#


stages:
  - fetch
  - test
  - process
  - upload

#
---------------------------------------------------------------------------
#

# Fetch Stage

#
---------------------------------------------------------------------------
#


fetch_changed_files:
  stage: fetch
  Script:
    - echo &quot;Fetching changed files...&quot;
    - git branch
    - git fetch origin $CI_DEFAULT_BRANCH:$CI_DEFAULT_BRANCH --depth 2000
    - |
      if [[ &quot;$CI_COMMIT_BRANCH&quot; == &quot;$CI_DEFAULT_BRANCH&quot; ]]; then
        git diff --name-status HEAD^1...HEAD &gt; changed-files-temp.txt
      else
        git fetch origin $CI_COMMIT_BRANCH:$CI_COMMIT_BRANCH --depth 2000
        git diff --name-status ${CI_DEFAULT_BRANCH}...${CI_COMMIT_SHA} &gt; changed-files-temp.txt
      fi
    - grep -E &#39;\.json$&#39; changed-files-temp.txt &gt; changed-files.txt || true
    - flake8 .
    - pytest
  artifacts:
    paths:
      - changed-files.txt
    expose_as: &#39;changed_files&#39;

#
---------------------------------------------------------------------------
#

# Test Stage

#
---------------------------------------------------------------------------
#


flake8:
  stage: test
  script:
    - echo &quot;Running Flake8 for linting...&quot;
    - flake8 .

pytest:
  stage: test
  script:
    - echo &quot;Running Pytest for unit tests...&quot;
    - pytest
  artifacts:
    when: always
    reports:
      junit: report.xml

#
---------------------------------------------------------------------------
#

# Process Stage

#
---------------------------------------------------------------------------
#


process_files:
  stage: process
  script:
    - echo &quot;Processing changed files...&quot;
    - git clone --depth 2000 --branch $CI_DEFAULT_BRANCH $CI_REPOSITORY_URL
    - mkdir -p modified_rules delete_file new_file
    - python3 move-files.py -x changed-files.txt
    - python3 check-alerts-format.py
  artifacts:
    paths:
      - modified_rules
      - delete_file
      - new_file
#
---------------------------------------------------------------------------
#

# Upload Stage

#
---------------------------------------------------------------------------
#


update_rules:
  stage: upload
  script:
    - echo &quot;Uploading updated rules and lookup tables...&quot;
    - git fetch origin $CI_DEFAULT_BRANCH:$CI_DEFAULT_BRANCH --depth 2000
    - git clone --depth 2000 --branch $CI_DEFAULT_BRANCH $CI_REPOSITORY_URL 
    - python3 update-rules.py
    - python3 update-exceptions.py
    - python3 create_ttps_layers.py
  rules:
    - if: $CI_COMMIT_BRANCH == &quot;main&quot; &amp;&amp; $CI_PIPELINE_SOURCE != &quot;schedule&quot;
      changes:
        - detections/**/*
        - exceptions/**/*
</code></pre><p>O diagrama abaixo ilustra o fluxo de trabalho do processo de CI/CD que foi descrito acima.</p><pre className="language-mermaid shiki shiki-themes github-light" code="
graph TD;
    fetch[Etapa de busca: identificar arquivos alterados] --&gt; test[Etapa de teste: executar linting e testes];
    test --&gt; process[Etapa de processamento: categorizar arquivos];
    process --&gt; upload[Etapa de upload: atualizar regras e tabelas de referência];
    fetch --&gt; fetch_details[Detalhes: filtrar arquivos JSON, gerar o arquivo &#39;changed-files.txt&#39;];
    test --&gt; test_details[Detalhes: executar Flake8 para linting, Pytest para testes];
    process --&gt; process_details[Detalhes: categorizar em &#39;modified&#39;, &#39;new&#39;, &#39;deleted&#39;, preparar para upload];
    upload --&gt; upload_details[Detalhes: atualizar o repositório, atualizar detecções no SIEM e na tabela de referência do SIEM];
" language="mermaid" meta="" style=""><code><span class="line" line="1"><span emptyLinePlaceholder>
</span></span><span class="line" line="2"><span class="sgsFI">graph TD;
</span></span><span class="line" line="3"><span class="sgsFI">    fetch[Etapa de busca: identificar arquivos alterados] --&gt; test[Etapa de teste: executar linting e testes];
</span></span><span class="line" line="4"><span class="sgsFI">    test --&gt; process[Etapa de processamento: categorizar arquivos];
</span></span><span class="line" line="5"><span class="sgsFI">    process --&gt; upload[Etapa de upload: atualizar regras e tabelas de referência];
</span></span><span class="line" line="6"><span class="sgsFI">    fetch --&gt; fetch_details[Detalhes: filtrar arquivos JSON, gerar o arquivo &#39;changed-files.txt&#39;];
</span></span><span class="line" line="7"><span class="sgsFI">    test --&gt; test_details[Detalhes: executar Flake8 para linting, Pytest para testes];
</span></span><span class="line" line="8"><span class="sgsFI">    process --&gt; process_details[Detalhes: categorizar em &#39;modified&#39;, &#39;new&#39;, &#39;deleted&#39;, preparar para upload];
</span></span><span class="line" line="9"><span class="sgsFI">    upload --&gt; upload_details[Detalhes: atualizar o repositório, atualizar detecções no SIEM e na tabela de referência do SIEM];
</span></span></code></pre><h2 id="benefícios-e-resultados">Benefícios e resultados</h2><p>A automatização do ciclo de vida de detecções de ameaças, por meio de um fluxo de trabalho de DaC baseado em CI/CD, traz uma série de benefícios ao nosso processo de implantação:</p><ul><li>Automação: automatizar a criação e a validação das detecções no SIEM reduz a ocorrência de erros manuais e economiza tempo.</li><li>Segurança reforçada: o fluxo de trabalho orientado por CI aplica uma política de &quot;privilégio mínimo&quot;, garantindo consistência, revisões por pares e padrões de qualidade na criação, atualização ou exclusão de detecções de ameaças.</li><li>Eficiência: o formato JSON padronizado para detecções e a criação automatizada agilizam o processo de implantação.</li><li>Colaboração: o processo de MR e revisão fomenta a colaboração e o compartilhamento de conhecimento entre os membros do time do GitLab.</li><li>Controle de versão: tratar a detecção de ameaças como código abstrai as detecções da plataforma SIEM em que estão armazenadas. Essa abstração fornece um histórico de alterações, facilita a colaboração e permite fazer rollback para configurações anteriores caso surjam problemas.</li></ul><h2 id="comece-a-usar-o-dac">Comece a usar o DaC</h2><p>Usar o GitLab CI/CD ao mesmo tempo em que existe uma política de &quot;privilégio mínimo&quot; tornou o gerenciamento de detecções e alertas do nosso SIEM mais simples e seguro. A automação melhorou a eficiência e reduziu riscos, servindo como um exemplo útil para quem também quer aprimorar sua segurança e conformidade. Faça este tutorial usando um <a href="https://about.gitlab.com/pt-br/free-trial/" rel="">teste gratuito do GitLab Ultimate</a>.</p><style>html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}</style>]]></content>
        <author>
            <name>Mitra Jozenazemian</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/mitra-jozenazemian/</uri>
        </author>
        <published>2025-01-29T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Apresentando o framework GUARD para automatizar detecções de segurança no GitLab]]></title>
        <id>https://about.gitlab.com/pt-br/blog/unveiling-the-guard-framework-to-automate-security-detections-at-gitlab/</id>
        <link href="https://about.gitlab.com/pt-br/blog/unveiling-the-guard-framework-to-automate-security-detections-at-gitlab/"/>
        <updated>2024-11-26T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O time de <a href="https://handbook.gitlab.com/handbook/security/security-operations/" rel="">GitLab Security Operations</a> usa a automação como princípio norteador para garantir que os engenheiros de segurança tenham tempo para focar no que realmente importa, ao invés das tarefas manuais repetitivas que poderiam ser padronizadas e automatizadas. Aplicamos esse princípio para proteger a plataforma SaaS do GitLab.com, que gera terabytes de dados de log todos os dias e exige que o time de segurança do GitLab padronize, automatize e escale os fluxos de trabalho de segurança para garantir mais proteção e eficiência. O resultado foi um novo framework que chamamos de GitLab Universal Automated Detection and Response, ou GUARD — uma colaboração entre o <a href="https://handbook.gitlab.com/handbook/security/security-operations/sirt/" rel="">Security Incident Response Team (SIRT)</a> e o <a href="https://handbook.gitlab.com/handbook/security/security-operations/signals-engineering/" rel="">Signals Engineering Team</a> do GitLab. O GUARD é um dos vários frameworks de segurança que o GitLab disponibilizou em código aberto por meio do seu <a href="/blog/introducing-gitlabs-open-source-security-center/">Open Source Security Center</a>.</p><p>O GUARD cobre todos os aspectos da detecção de segurança, incluindo:</p><ul><li>criação</li><li>manutenção</li><li>roteamento e tratamento de alertas</li><li>coleta avançada de métricas</li><li>fluxo de trabalho de encerramento de alertas ou escalonamento de incidentes</li></ul><h2 id="os-objetivos-do-guard">Os objetivos do GUARD</h2><p>O GUARD foi criado e projetado com um conjunto de objetivos-chave:</p><ol><li><strong>Padronizar o pipeline de detecção e alertas do SIRT</strong> para produzir detecções de alta qualidade, com foco em revisão por pares e automação em primeiro lugar</li><li><strong>Reduzir a fadiga de alertas</strong> por meio de consolidação, deduplicação, pontuação de risco e feedback automatizado</li><li><strong>Métricas</strong> para medir a eficiência da resposta e identificar problemas cedo</li><li><strong>Colocar o GitLab no centro</strong>, usando o GitLab como fonte única confiável para as definições de detecção</li></ol><h2 id="os-princípios-de-design-do-guard">Os princípios de design do GUARD</h2><p>O GUARD nasceu de uma necessidade real, com uma visão clara do estado que se pretendia alcançar. Antes do GUARD, as detecções não seguiam um formato padrão, não havia métricas de alertas disponíveis, e a criação e a manutenção de detecções aconteciam de forma pontual e não estruturada. Por isso, construir um framework escalável, centrado no GitLab e capaz de automatizar tarefas manuais foi essencial para o sucesso do GUARD. Graças aos ganhos de eficiência proporcionados pelo GUARD, os engenheiros de SecOps passaram a ter mais tempo para resolver problemas difíceis e lidar com incidentes complexos.</p><h2 id="componentes-do-guard">Componentes do GUARD</h2><p>O framework GUARD é formado por vários módulos. No centro do GUARD está a própria plataforma GitLab, atuando como fonte única de verdade para as regras de detecção e dando ao SIRT a capacidade de implantar detecções como código automaticamente, usando o <a href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/" rel="">GitLab CI/CD</a>.</p><p>O GUARD inclui os seguintes componentes:</p><ul><li>Detection as Code (DaC) - implanta detecções por meio do pipeline de CI/CD do GitLab.</li><li><a href="/blog/self-service-security-alert-handling-with-gitlabs-uam/">User Attestation Module</a> - permite que membros do time do GitLab atestem atividades sinalizadas como potencialmente maliciosas.</li><li>Enriquecimentos - consulta informações históricas e contextuais para enriquecer os alertas, facilitando a triagem.</li><li>Triagem e resposta a alertas - oferece um formato padrão de triagem de alertas e ações de escalonamento baseadas em pré-definições.</li><li>Geração de métricas - reúne insights sobre o tratamento dos alertas.</li></ul><p>Cada módulo do GUARD trabalha em conjunto para padronizar, automatizar e melhorar continuamente as detecções de segurança e o pipeline de alertas do GitLab.</p><h2 id="o-gitlab-no-centro">O GitLab no centro</h2><p>O GitLab é essencial para os componentes críticos do GUARD: atua como fonte única para as detecções de ameaças, automatiza o pipeline de DaC do GUARD por meio do GitLab CI/CD e funciona como o &quot;front-end&quot; do GUARD, através do qual os engenheiros de segurança podem adicionar, editar e excluir detecções de ameaças.</p><p>Veja como os recursos do GitLab são usados pelo GUARD:</p><ul><li><a href="https://docs.gitlab.com/user/get_started/get_started_projects/" rel="">Projetos do GitLab</a>: o GUARD utiliza um repositório de projeto do GitLab como fonte única para as detecções de ameaças, armazenadas em formato JSON.</li><li><a href="https://docs.gitlab.com/user/project/merge_requests/" rel="">MRs do GitLab</a>: qualquer alteração nas detecções do GUARD, incluindo novas detecções, é feita por meio de Merge Requests no projeto principal do GUARD. Um template detalhado de MR é usado para validar e registrar os detalhes da detecção sendo adicionada, editada ou excluída. Regras de aprovação de MR, incluindo o uso de CodeOwners e branches protegidas, garantem que as revisões de detecção sejam concluídas corretamente antes do merge.</li><li><a href="https://docs.gitlab.com/user/project/issues/" rel="">Issues do GitLab</a>: envios de bugs ou outras iniciativas de engenharia relacionadas ao GUARD são registrados em issues (tíquetes) do GitLab.</li><li><a href="https://docs.gitlab.com/user/project/labels/" rel="">Labels do GitLab</a>: um conjunto de labels padronizadas garante que os engenheiros de segurança documentem as alterações do GUARD de uma forma fácil de rastrear.</li><li><a href="https://docs.gitlab.com/ci/" rel="">GitLab CI/CD</a>: o GUARD usa um pipeline de CI do GitLab para automatizar a implantação de detecções novas, alteradas ou excluídas na plataforma de gestão de eventos e incidentes de segurança (SIEM) do GitLab. O pipeline de CI do GUARD realiza uma série de validações, testes e verificações de qualidade antes de concluir com sucesso e efetivar as alterações na plataforma SIEM do GitLab.</li></ul><h2 id="geração-de-métricas">Geração de métricas</h2><p>As interações com a interface de tratamento de alertas são registradas para gerar métricas-chave de desempenho, como Tempo para Responder, Tempo para Resolver e insights sobre alertas, como as taxas de verdadeiros e falsos positivos. Também coletamos metadados adicionais, incluindo uma análise de sentimento baseada em emojis: os engenheiros que tratam os alertas fornecem &quot;feedback&quot; sobre eles em forma de emojis, o que nos permite levar essas percepções em conta ao iterar sobre as regras de detecção.</p><p>As métricas de tratamento de alertas ficam armazenadas em um banco de dados separado, usado para criar visualizações consultadas por engenheiros e pela liderança. Afinal, esses dados são fundamentais para entender o desempenho do time na resolução de alertas e na fidelidade das detecções, permitindo que estejamos sempre melhorando.</p><h2 id="itere-com-a-gente">Itere com a gente</h2><p>Usar o GitLab como referência central para o código de detecção de ameaças permitiu que o GUARD desacoplasse os processos de uma tecnologia de SIEM específica, ganhando mais flexibilidade, facilidade de uso, modularização e capacidade de auditoria.</p><p>A <a href="https://handbook.gitlab.com/handbook/values/#iteration" rel="">iteração</a> é um valor central do GitLab — começamos pela menor coisa de valor possível para obter feedback rápido e alcançar o objetivo desejado com eficiência. O GUARD não foge a essa regra, e esperamos que compartilhar essa experiência ajude outras pessoas a iterar rumo às suas próprias melhorias de automação.</p><p><em>Este artigo é o primeiro de uma série sobre o GitLab GUARD. No próximo, vamos compartilhar detalhes sobre os diversos aspectos da nossa jornada iterativa para <a href="/pt-br/blog/automating-cybersecurity-threat-detections-with-gitlab-ci-cd/">implementar o GUARD no GitLab</a>.</em></p>]]></content>
        <author>
            <name>Harjeet Sharma</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/harjeet-sharma/</uri>
        </author>
        <author>
            <name>Valentine Mairet</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/valentine-mairet/</uri>
        </author>
        <author>
            <name>Matt Coons</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/matt-coons/</uri>
        </author>
        <published>2024-11-26T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[O que é Git: Guia sobre funções e funcionamento do Git]]></title>
        <id>https://about.gitlab.com/pt-br/blog/what-is-git-the-ultimate-guide-to-gits-role-and-functionality/</id>
        <link href="https://about.gitlab.com/pt-br/blog/what-is-git-the-ultimate-guide-to-gits-role-and-functionality/"/>
        <updated>2024-11-14T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O Git é uma ferramenta indispensável no mundo do desenvolvimento de software moderno. Neste guia completo, explicamos em detalhes o que é o Git, qual é o seu papel no controle de versão de código-fonte e como ele funciona na prática. Seja você iniciante ou especialista, este guia vai trazer um entendimento profundo do Git e de todos os seus recursos.</p><h2 id="o-que-é-git">O que é Git?</h2><p>O Git é uma ferramenta de controle de versão que rapidamente se tornou indispensável no ecossistema de desenvolvimento de software. Isto porque ele rastreia cada alteração de um projeto com muita precisão, e é justamente por isso que se transformou em uma ferramenta essencial para desenvolvedores que querem gerenciar seus projetos com eficiência. Não à toa, dominar o Git virou uma habilidade fundamental para quem quer se destacar no desenvolvimento de software.</p><h3 id="o-que-é-controle-de-versão">O que é controle de versão?</h3><p>O <a href="https://about.gitlab.com/pt-br/topics/version-control/what-is-git-version-control/" rel="">controle de versão</a> permite rastrear as alterações no código-fonte de um software. Assim, a versão entregue de um software corresponde a um conjunto específico de versões de cada um dos seus componentes e arquivos de código-fonte. Um ícone, por exemplo, pode ter sido alterado apenas duas vezes, enquanto um arquivo de código pode ter passado por dezenas de alterações ao longo do tempo.</p><h2 id="quais-são-os-recursos-do-git">Quais são os recursos do Git?</h2><p>No desenvolvimento de software, manter uma gestão rigorosa das alterações no código-fonte é fundamental — sem isso, é praticamente impossível garantir a consistência e a confiabilidade do trabalho dos times de desenvolvimento. Um controle de mudanças bem ajustado também facilita identificar a origem de um problema e reduz o risco de conflitos e sobrescrita de arquivos. É exatamente para isso que o Git existe: ele simplifica e agiliza o versionamento de software.</p><p>Para entender melhor o Git e como ele funciona, listamos abaixo alguns dos principais recursos que tornam mais fácil otimizar o gerenciamento de código-fonte e a colaboração entre times.</p><h3 id="visualização-do-histórico-do-projeto">Visualização do histórico do projeto</h3><p>No ecossistema de desenvolvimento de software, o <a href="https://about.gitlab.com/blog/keeping-git-commit-history-clean/" rel="">histórico de commits</a> é um dos pilares centrais para acompanhar o progresso de um projeto no Git. Por isso, o Git oferece aos desenvolvedores um histórico detalhado de todas as alterações feitas no código-fonte.</p><p>A cada novo commit, o Git registra:</p><ul><li>as alterações específicas feitas nos arquivos do projeto</li><li>uma mensagem explicativa escrita pelo desenvolvedor que fez a mudança</li></ul><p>Esses elementos melhoram a comunicação e o alinhamento do time de desenvolvimento, o que permite que todos entendam mais rápido os detalhes de cada mudança feita no código.</p><p>Além de acompanhar a evolução do projeto, esse histórico permite voltar atrás quando necessário: é possível desfazer parte das alterações ou, ao contrário, trazer apenas parte das mudanças de uma branch para outra. Essa função tem um papel essencial para manter a transparência, a consistência e a qualidade do código-fonte de um projeto no Git, além de fortalecer a colaboração dentro do time e a eficiência operacional na hora de resolver problemas.</p><p>Confira o nosso tutorial sobre <a href="https://docs.gitlab.com/tutorials/make_first_git_commit/" rel="">como criar o seu primeiro commit no Git</a>.</p><h3 id="mais-autonomia-para-os-times">Mais autonomia para os times</h3><p>Outro recurso essencial do Git é o <a href="https://git-scm.com/about/distributed" rel="">desenvolvimento distribuído</a>. Graças à sua estrutura descentralizada, o Git permite que times de desenvolvimento trabalhem simultaneamente no mesmo projeto. Cada integrante do time tem sua própria cópia do projeto, na qual cada alteração pode ser versionada de forma independente. Isso permite que cada um trabalhe de forma autônoma em recursos específicos, reduzindo o risco de conflitos ou sobrescrita de código. Essa abordagem dá bastante flexibilidade aos desenvolvedores, que podem explorar diferentes ideias ou testar novos recursos sem interferir no trabalho dos colegas.</p><p>O desenvolvimento distribuído também aumenta a resiliência ao surgimento de falhas de servidor: mesmo diante de uma falha, cada pessoa mantém uma cópia própria e pode continuar trabalhando offline. As alterações são sincronizadas assim que o servidor volta a ficar disponível, o que reduz o risco de interrupções no trabalho dos times de desenvolvimento e as restrições de atualização para os times de operações.</p><h3 id="otimizando-os-fluxos-de-trabalho-de-desenvolvimento">Otimizando os fluxos de trabalho de desenvolvimento</h3><p>Um dos recursos mais poderosos do Git é a capacidade de <a href="https://git-scm.com/about/branching-and-merging" rel="">gerenciar branches e suas mesclagens (branching e merging)</a>. Isso permite que os times trabalhem em paralelo, de forma colaborativa e organizada. Dessa forma, cada novo recurso ou correção de bug pode ser desenvolvido e testado de forma independente, garantindo mais confiabilidade. Depois, os desenvolvedores simplesmente mesclam as alterações na branch principal do projeto por meio das Merge Requests.</p><p>Ao adotar essa abordagem, os times conseguem acompanhar a evolução do código, colaborar com facilidade e eficiência, reduzir conflitos entre versões diferentes e garantir a integração contínua dos recursos desenvolvidos.</p><p>Usando esses dois recursos juntos, os times conseguem desenvolver projetos de forma contínua e ágil, implantando novas versões de código regularmente. Essa prática facilita muito o gerenciamento de mudanças e reduz o risco de erros.</p><h2 id="quais-são-os-benefícios-do-git">Quais são os benefícios do Git?</h2><p>Para entender bem o Git, é importante reconhecer todos os benefícios que ele traz para os times de desenvolvimento:</p><ul><li><strong>Gerenciamento de versões descentralizado:</strong> com o Git, cada desenvolvedor tem uma cópia completa do histórico do projeto, o que permite trabalhar de forma independente.</li><li><strong>Uma ferramenta pensada para a segurança:</strong> diferente de outras ferramentas de controle de versão, o Git foi projetado desde o início para garantir a integridade de todos os elementos do repositório, usando um algoritmo criptográfico de hash seguro (SHA1 e, atualmente, <a href="https://about.gitlab.com/blog/gitlab-now-supports-sha256-repositories/" rel="">SHA-256</a>). Esse algoritmo protege o código e o histórico do projeto contra qualquer modificação, maliciosa ou não. Além disso, cada commit (ou seja, cada nova versão criada) pode ser assinado automaticamente (GPG), garantindo a rastreabilidade das mudanças. Isso faz do Git uma ferramenta particularmente segura, que garante a integridade e a autenticidade do seu código-fonte e do seu histórico.</li><li><strong>Uma ferramenta rápida e eficiente:</strong> o Git foi projetado para maximizar a eficiência durante o desenvolvimento. Sua velocidade permite que os desenvolvedores realizem operações complexas — como commits, criação de branches e merges — em tempo mínimo, mesmo em bases de código grandes. Ele também mantém um consumo mínimo de espaço em disco e de tráfego de rede, o que se traduz em respostas rápidas durante backups, consultas e alterações no histórico do projeto.</li><li><strong>Mais flexibilidade de trabalho:</strong> o Git é compatível com uma grande variedade de fluxos de trabalho de desenvolvimento. Seja você adepto de modelos de desenvolvimento centralizados ou de abordagens mais lineares, o Git se adapta facilmente. Essa capacidade de lidar com diferentes fluxos de trabalho dá aos times várias opções de como organizar o próprio trabalho.</li><li><strong>Facilidade de integração:</strong> o Git se destaca pela capacidade de integração com uma ampla variedade de ferramentas e plataformas de desenvolvimento já existentes. Essa compatibilidade ampla permite que os times gerenciem seus projetos com mais eficiência, aproveitando as melhores ferramentas e práticas de DevSecOps.</li><li><strong>Um projeto open source amplamente adotado:</strong> outro grande benefício do Git é ser um projeto open source, apoiado por uma comunidade dinâmica e dedicada, que garante sua melhoria constante. Essa participação ativa de pessoas e empresas na comunidade do Git garante a adição regular de novos recursos e melhorias por meio de atualizações contínuas.</li></ul><h2 id="quais-são-os-principais-comandos-do-git">Quais são os principais comandos do Git?</h2><p>O projeto open source do Git oferece uma grande variedade de comandos para facilitar o trabalho em equipe. Veja alguns dos comandos mais usados:</p><ul><li><strong>git init:</strong> inicializa um novo repositório Git.</li><li><strong>git clone [url]:</strong> clona um repositório já existente.</li><li><strong>git add [file]:</strong> adiciona um arquivo ao índice.</li><li><strong>git commit:</strong> valida as alterações feitas.</li><li><strong>git commit -m &quot;mensagem&quot;:</strong> valida as alterações com uma mensagem.</li><li><strong>git status:</strong> mostra o status dos arquivos no diretório de trabalho.</li><li><strong>git push:</strong> envia as alterações para o repositório remoto.</li><li><strong>git pull:</strong> busca as alterações do repositório remoto e as mescla com o repositório local.</li></ul><p>Esses comandos são essenciais para começar a usar o Git, mas vale lembrar que existem muitos outros. Confira a <a href="https://git-scm.com/docs" rel="">lista de comandos do Git</a>. No Windows, você pode <a href="/blog/git-command-line-on-windows-with-git-bash/">executar todos esses comandos usando o Git Bash</a>, um emulador de terminal que já vem junto com o Git para Windows.</p><h2 id="git-e-o-gitlab">Git e o GitLab</h2><p>O <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> é uma plataforma colaborativa de desenvolvimento open source que cobre todas as etapas do ciclo de vida do <a href="https://about.gitlab.com/pt-br/devsecops/" rel="">DevSecOps</a> e oferece um servidor Git para uma colaboração eficiente entre times.</p><p>Além do gerenciamento de código-fonte, o GitLab oferece um pacote completo para integração e distribuição contínuas, gerenciamento de entregáveis, segurança e gestão de incidentes, com toda a rastreabilidade associada, planejamento e acompanhamento de tarefas em tempo real, monitoramento de implantações, versionamento de software e o espaço de documentos correspondente.</p><h2 id="perguntas-frequentes-sobre-git">Perguntas frequentes sobre Git</h2><h3 id="por-que-usar-o-git">Por que usar o Git?</h3><p>O Git é sinônimo de eficiência. Seu sistema descentralizado, baseado em branches e merges, permite que os times de desenvolvimento trabalhem no mesmo projeto sem interferir no trabalho uns dos outros nem, principalmente, criar conflitos de versão.</p><h3 id="o-git-é-um-software">O Git é um software?</h3><p>O Git é um projeto open source. Por isso, é gratuito e está disponível para todos. Mesmo assim, é preciso <a href="https://docs.gitlab.com/topics/git/how_to_install_git/" rel="">instalar o Git</a> no seu dispositivo antes de começar a usá-lo.</p><h3 id="o-que-é-uma-branch-no-git">O que é uma branch no Git?</h3><p>No Git, uma branch é um ponteiro para um histórico de alterações: cada branch principal aponta para o último commit realizado nela. Por isso, é possível ter várias branches paralelas, cada uma com seu próprio histórico, mas todas partindo da mesma raiz.</p><h3 id="o-que-é-um-commit">O que é um commit?</h3><p>No Git, um commit registra as alterações feitas no código-fonte de um software. Cada commit vem acompanhado de uma mensagem explicativa que documenta o histórico de todas as mudanças. Isso facilita o acompanhamento do projeto e sempre deixa a opção de voltar para versões anteriores que funcionavam, caso surja algum problema.</p><h3 id="qual-é-o-benefício-das-branches-no-git">Qual é o benefício das branches no Git?</h3><p>Desenvolver recursos em branches permite que os desenvolvedores trabalhem simultaneamente em várias funcionalidades distintas, sem comprometer a branch principal com código instável. Além disso, implementar branches no Git é significativamente mais leve do que em outros sistemas de controle de versão.</p>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2024-11-14T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Aprenda Python com ajuda da IA]]></title>
        <id>https://about.gitlab.com/pt-br/blog/learning-python-with-a-little-help-from-ai-code-suggestions/</id>
        <link href="https://about.gitlab.com/pt-br/blog/learning-python-with-a-little-help-from-ai-code-suggestions/"/>
        <updated>2023-11-09T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Aprender uma nova linguagem de programação pode ampliar a sua experiência no desenvolvimento de softwares, abrir portas na carreira ou simplesmente ser um desafio divertido. Porém, o problema é que decidir por uma abordagem específica para aprender essa nova linguagem nem sempre é fácil, e é aí que a inteligência artificial (IA) pode ajudar. Neste tutorial, você vai aprender a usar o GitLab Duo Code Suggestions, com tecnologia de IA, para ter uma experiência guiada de aprendizado da linguagem Python, por meio de um exemplo prático e mão na massa.</p><ul><li><a href="#preparacoes">Preparações</a><ul><li><a href="#vs-code">VS Code</a></li><li><a href="#code-suggestions">Code Suggestions</a></li></ul></li><li><a href="#aprendendo-uma-nova-linguagem-de-programacao-python">Aprendendo uma nova linguagem de programação: Python</a><ul><li><a href="#ambiente-de-desenvolvimento-para-python">Ambiente de desenvolvimento para Python</a></li><li><a href="#hello-world">Hello, World</a></li></ul></li><li><a href="#comece-a-aprender-python-com-um-exemplo-pratico">Comece a aprender Python com um exemplo prático</a><ul><li><a href="#defina-e-imprima-variaveis">Defina e imprima variáveis</a></li><li><a href="#explore-os-tipos-de-variaveis">Explore os tipos de variáveis</a></li></ul></li><li><a href="#entrada-saida-de-arquivos-leia-e-imprima-um-arquivo-de-log">Entrada/saída de arquivos: leia e imprima um arquivo de log</a></li><li><a href="#controle-de-fluxo">Controle de fluxo</a><ul><li><a href="#loops-e-listas-para-coletar-arquivos">Loops e listas para coletar arquivos</a></li><li><a href="#colete-arquivos-condicionalmente">Colete arquivos condicionalmente</a></li></ul></li><li><a href="#funcoes">Funções</a><ul><li><a href="#comece-com-um-formato-de-log-simples">Comece com um formato de log simples</a></li><li><a href="#operacoes-com-strings-e-estruturas-de-dados">Operações com strings e estruturas de dados</a></li><li><a href="#faca-o-parsing-de-arquivos-de-log-usando-expressoes-regulares">Faça o parsing de arquivos de log usando expressões regulares</a></li><li><a href="#formato-de-log-avancado-authlog">Formato de log avançado: auth.log</a></li><li><a href="#fazendo-parsing-de-mais-tipos-logging-estruturado">Fazendo parsing de mais tipos: logging estruturado</a></li></ul></li><li><a href="#imprimindo-e-formatando-os-resultados">Imprimindo e formatando os resultados</a></li><li><a href="#gerenciamento-de-dependencias-e-verificacao-continua">Gerenciamento de dependências e verificação contínua</a><ul><li><a href="#pip-e-pyenv-trazendo-estrutura-para-o-python">Pip e pyenv: trazendo estrutura para o Python</a></li><li><a href="#automacao-configure-o-pipeline-de-cicd-para-python">Automação: configure o pipeline de CI/CD para Python</a></li></ul></li><li><a href="#proximos-passos">Próximos passos</a><ul><li><a href="#exercicios-assincronos-de-aprendizado">Exercícios assíncronos de aprendizado</a></li><li><a href="#compartilhe-seu-feedback">Compartilhe seu feedback</a></li></ul></li></ul><h2 id="preparações">Preparações</h2><p>Escolha a sua <a href="https://docs.gitlab.com/user/project/repository/code_suggestions/#enable-code-suggestions-in-other-ides-and-editors" rel="">IDE preferida entre as compatíveis</a> e siga a documentação para ativar o Code Suggestions no <a href="https://docs.gitlab.com/user/project/repository/code_suggestions/#enable-code-suggestions-on-gitlab-saas" rel="">GitLab.com SaaS</a> ou em <a href="https://docs.gitlab.com/user/project/repository/code_suggestions/#enable-code-suggestions-on-self-managed-gitlab" rel="">instâncias auto-gerenciadas do GitLab</a>.</p><p>Algumas linguagens de programação podem exigir a instalação de ferramentas de linha de comando do interpretador, ou de compiladores que geram binários a partir do código-fonte, para compilar e executar a aplicação.</p><p><strong>Dica:</strong> você também pode usar os <a href="/pt-br/blog/quick-start-guide-for-gitlab-workspaces/">workspaces de GitLab Remote Development</a> para criar seus próprios ambientes de desenvolvimento na nuvem, em vez de usar ambientes locais. Este post foca no uso do VS Code e da GitLab Web IDE.</p><h3 id="vs-code">VS Code</h3><p><a href="https://code.visualstudio.com/download" rel="">Instale o VS Code</a> na sua máquina e abra o programa. Acesse o menu <code>Extensions</code> e procure por <code>gitlab workflow</code>. Instale a <a href="https://marketplace.visualstudio.com/items?itemName=GitLab.gitlab-workflow" rel="">extensão GitLab Workflow para VS Code</a>. O VS Code também vai detectar as linguagens de programação instaladas e sugerir plugins adicionais para destaque de sintaxe e uma melhor experiência de desenvolvimento. Por exemplo, instale a <a href="https://marketplace.visualstudio.com/items?itemName=ms-python.python" rel="">extensão Python</a>.</p><h3 id="code-suggestions">Code Suggestions</h3><p>Acostume-se com as sugestões antes de começar a verificá-las de fato no fluxo de trabalho. O GitLab Duo Code Suggestions fornece sugestões enquanto você digita, então não é preciso usar atalhos de teclado específicos. Para aceitar uma sugestão de código, pressione a tecla <code>tab</code>. Além disso, é importante notar também que escrever código novo funciona de forma mais confiável do que refatorar código já existente. Outro ponto relevante é que, como a IA é não determinística, a mesma sugestão pode não se repetir depois que você apaga um trecho de código já aceito. Enquanto o Code Suggestions está em Beta, seguimos trabalhando para melhorar a precisão geral do conteúdo gerado. Vale revisar as <a href="https://docs.gitlab.com/user/project/repository/code_suggestions/#known-limitations" rel="">limitações conhecidas</a>, já que elas podem afetar a sua experiência de aprendizado.</p><p><strong>Dica:</strong> a versão mais recente do Code Suggestions já é compatível com instruções em várias linhas. Você pode refinar as especificações conforme a sua necessidade para obter sugestões melhores — vamos praticar esse método ao longo deste post.</p><h2 id="aprendendo-uma-nova-linguagem-de-programação-python">Aprendendo uma nova linguagem de programação: Python</h2><p>Agora vamos mergulhar no aprendizado do Python, uma das <a href="https://docs.gitlab.com/user/project/repository/code_suggestions/#supported-languages" rel="">linguagens compatíveis com o Code Suggestions</a>.</p><p>Antes de entrar no código-fonte propriamente dito, configure o seu ambiente de desenvolvimento.</p><h3 id="ambiente-de-desenvolvimento-para-python">Ambiente de desenvolvimento para Python</h3><ol><li>Crie um novo projeto <code>learn-python-ai</code> no GitLab e clone o projeto no seu ambiente de desenvolvimento. Todos os trechos de código estão disponíveis neste <a href="https://gitlab.com/gitlab-da/use-cases/ai/learn-with-ai/learn-python-ai" rel="">projeto &quot;Learn Python with AI&quot;</a>.</li></ol><pre className="language-shell shiki shiki-themes github-light" code="git clone https://gitlab.com/NAMESPACE/learn-python-ai.git

cd learn-python-ai

git status
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">git</span><span class="sYBdl"> clone</span><span class="sYBdl"> https://gitlab.com/NAMESPACE/learn-python-ai.git
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sYu0t">cd</span><span class="sYBdl"> learn-python-ai
</span></span><span class="line" line="4"><span emptyLinePlaceholder>
</span></span><span class="line" line="5"><span class="s7eDp">git</span><span class="sYBdl"> status
</span></span></code></pre><ol start="2"><li>Instale o Python e as ferramentas de build. Exemplo no macOS usando o Homebrew:</li></ol><pre className="language-shell shiki shiki-themes github-light" code="brew install python
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">brew</span><span class="sYBdl"> install</span><span class="sYBdl"> python
</span></span></code></pre><ol start="3"><li>Vale considerar adicionar um arquivo <code>.gitignore</code> para Python — por exemplo, este <a href="https://gitlab.com/gitlab-org/gitlab/-/blob/master/vendor/gitignore/Python.gitignore?ref_type=heads" rel="">template de .gitignore para Python</a>.</li></ol><p>Pronto, agora você já pode começar a aprender Python!</p><h3 id="hello-world">Hello, World</h3><p>Comece a sua jornada de aprendizado pela <a href="https://www.python.org/about/gettingstarted/" rel="">documentação oficial</a> e dê uma olhada nos recursos linkados, como o <a href="https://docs.python.org/3/tutorial/index.html" rel="">tutorial de Python</a>. A documentação da <a href="https://docs.python.org/3/library/index.html" rel="">biblioteca padrão</a> e da <a href="https://docs.python.org/3/reference/index.html" rel="">referência da linguagem</a> também pode ajudar bastante.</p><p><strong>Dica:</strong> quando entrei em contato com o Python pela primeira vez, em 2005, eu não tinha muitos casos de uso além de um framework para testar drivers do Windows 2000. Anos depois, em 2016, retomei o conhecimento com o livro &quot;Head First Python, 2nd Edition&quot;, que traz ótimos exemplos práticos para uma experiência de aprendizado completa — duas semanas depois, eu já conseguia explicar as diferenças entre Python 2 e 3. Você não precisa se preocupar com o Python 2: ele foi descontinuado há alguns anos, e vamos focar apenas no Python 3 neste post. Em agosto de 2023, foi publicado o &quot;<a href="https://www.oreilly.com/library/view/head-first-python/9781492051282/" rel="">Head First Python, 3rd Edition</a>&quot;, que é um ótimo recurso de aprendizado, ao lado dos exercícios compartilhados neste post.</p><p>Crie um novo arquivo <code>hello.py</code> no diretório raiz do projeto e comece com um comentário dizendo <code># Hello world</code>. Revise e aceite a sugestão pressionando a tecla <code>tab</code>, e salve o arquivo (atalho de teclado: cmd s).</p><pre className="language-markdown shiki shiki-themes github-light" code="# Hello world
" language="markdown" meta="" style=""><code><span class="line" line="1"><span class="surfw"># Hello world
</span></span></code></pre><p><img alt="Hello World; Olá, GitLab Duo Code Suggestions" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398608/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_python_code_sugestions_hello_world.png" title="Hello World; Olá, GitLab Duo Code Suggestions" /></p><p><strong>Dica:</strong> adicionar comentários no código Python começando com o caractere <code>#</code> antes de escrever uma função ou algoritmo ajuda o Code Suggestions a ter mais contexto para oferecer sugestões melhores. No exemplo acima, fizemos isso com <code># Hello world</code>, e vamos continuar fazendo o mesmo nos próximos exercícios.</p><p>Adicione o <code>hello.py</code> ao Git, faça o commit de todas as alterações e envie (push) para o seu projeto no GitLab.</p><pre className="language-shell shiki shiki-themes github-light" code="git add hello.py

git commit -avm &quot;Initialize Python&quot;

git push
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">git</span><span class="sYBdl"> add</span><span class="sYBdl"> hello.py
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="s7eDp">git</span><span class="sYBdl"> commit</span><span class="sYu0t"> -avm</span><span class="sYBdl"> &quot;Initialize Python&quot;
</span></span><span class="line" line="4"><span emptyLinePlaceholder>
</span></span><span class="line" line="5"><span class="s7eDp">git</span><span class="sYBdl"> push
</span></span></code></pre><p>O código-fonte de todos os exercícios deste post está disponível neste <a href="https://gitlab.com/gitlab-da/use-cases/ai/learn-with-ai/learn-python-ai" rel="">projeto &quot;Learn Python with AI&quot;</a>.</p><h2 id="comece-a-aprender-python-com-um-exemplo-prático">Comece a aprender Python com um exemplo prático</h2><p>O objetivo das próximas seções é explorar os tipos de dados da linguagem, variáveis, controle de fluxo e funções. Também vamos abordar operações com arquivos, parsing de strings e operações com estruturas de dados para imprimir os resultados. Os exercícios vão ajudar a construir uma aplicação de linha de comando que lê diferentes formatos de log, trabalha com os dados e gera um resumo. Essa aplicação vai servir de base para projetos futuros que buscam logs em APIs REST, além de inspirar outras ideias, como renderizar imagens, criar um servidor web ou adicionar métricas de observabilidade.</p><p><img alt="Parsing de arquivos de log em objetos estruturados, exemplo de resultado após seguir os exercícios" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398608/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_terminal_parsing_logs_and_pretty_print_results.png" title="Parsing de arquivos de log em objetos estruturados, exemplo de resultado após seguir os exercícios" /></p><p>Se você já é um administrador experiente, pode colocar o script em produção e usar exemplos reais de formato de log. Fazer parsing e analisar logs durante incidentes estressantes em produção pode tomar bastante tempo, e uma ferramenta de linha de comando local às vezes é mais rápida do que uma ferramenta de gestão de logs.</p><p>Vamos começar: crie um novo arquivo chamado <code>log_reader.py</code> no diretório raiz, adicione-o ao Git e crie um commit.</p><h3 id="defina-e-imprima-variáveis">Defina e imprima variáveis</h3><p>Como primeiro passo, precisamos definir a localização dos arquivos de log e o sufixo esperado do arquivo. Para isso, vamos criar duas variáveis e imprimi-las. Na prática, você pode pedir ao Code Suggestions para fazer isso, escrevendo apenas os comentários de código e aceitando as sugestões. Às vezes, é preciso experimentar diferentes sugestões e apagar blocos de código já aceitos, mas não se preocupe, a qualidade das sugestões melhora com o tempo, à medida que o modelo recebe mais contexto e gera sugestões melhores.</p><p><img alt="Defina as variáveis de caminho do log e sufixo do arquivo" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398604/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_log_reader_variables_01.png" title="Defina as variáveis de caminho do log e sufixo do arquivo" /></p><p><img alt="Imprima as variáveis para verificar" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398604/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_log_reader_variables_02.png" title="Imprima as variáveis para verificar" /></p><pre className="language-python shiki shiki-themes github-light" code="# Specify the path and file suffix in variables
path = &#39;/var/log/&#39;
file_suffix = &#39;.log&#39;

# Print the variables

print(path)
print(file_suffix)
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Specify the path and file suffix in variables
</span></span><span class="line" line="2"><span class="sgsFI">path </span><span class="sD7c4">=</span><span class="sYBdl"> &#39;/var/log/&#39;
</span></span><span class="line" line="3"><span class="sgsFI">file_suffix </span><span class="sD7c4">=</span><span class="sYBdl"> &#39;.log&#39;
</span></span><span class="line" line="4"><span emptyLinePlaceholder>
</span></span><span class="line" line="5"><span class="sAwPA"># Print the variables
</span></span><span class="line" line="6"><span emptyLinePlaceholder>
</span></span><span class="line" line="7"><span class="sYu0t">print</span><span class="sgsFI">(path)
</span></span><span class="line" line="8"><span class="sYu0t">print</span><span class="sgsFI">(file_suffix)
</span></span></code></pre><p>Acesse o terminal do VS Code e execute o script Python:</p><pre className="language-shell shiki shiki-themes github-light" code="python3 log_reader.py
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">python3</span><span class="sYBdl"> log_reader.py
</span></span></code></pre><p><img alt="Terminal do VS Code, imprimindo as variáveis" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398608/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_terminal_print_variables.png" title="Terminal do VS Code, imprimindo as variáveis" /></p><p>O Python é compatível com muitos tipos diferentes na sua <a href="https://docs.python.org/3/library/index.html" rel="">biblioteca padrão</a>. Os tipos mais comuns são: numéricos (int, float, complex), booleanos (True, False) e strings (str). As estruturas de dados incluem suporte a listas, tuplas e dicionários.</p><h3 id="explore-os-tipos-de-variáveis">Explore os tipos de variáveis</h3><p>Para praticar diferentes tipos de variáveis, vamos definir um limite de arquivos de log a serem lidos, como uma variável do tipo <code>integer</code>.</p><p><img alt="Variável de arquivo de log" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398605/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_log_reader_variables_03.png" title="Variável de arquivo de log" /></p><pre className="language-python shiki shiki-themes github-light" code="# Define log file limit variable
log_file_limit = 1024
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Define log file limit variable
</span></span><span class="line" line="2"><span class="sgsFI">log_file_limit </span><span class="sD7c4">=</span><span class="sYu0t"> 1024
</span></span></code></pre><p>Crie uma variável booleana que force a leitura de todos os arquivos no diretório, independentemente do sufixo do arquivo de log.</p><pre className="language-python shiki shiki-themes github-light" code="# Define boolean variable whether to read all files recursively
read_all_files_recursively = True
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Define boolean variable whether to read all files recursively
</span></span><span class="line" line="2"><span class="sgsFI">read_all_files_recursively </span><span class="sD7c4">=</span><span class="sYu0t"> True
</span></span></code></pre><h2 id="entradasaída-de-arquivos-leia-e-imprima-um-arquivo-de-log">Entrada/saída de arquivos: leia e imprima um arquivo de log</h2><p>Crie um diretório chamado <code>log-data</code> na árvore do seu projeto. Você pode copiar todos os arquivos de exemplo a partir do <a href="https://gitlab.com/gitlab-da/use-cases/ai/learn-with-ai/learn-python-ai/-/tree/main/log-data?ref_type=heads" rel="">diretório log-data no projeto de exemplo</a>.</p><p>Crie um novo arquivo <code>sample.log</code> com o seguinte conteúdo ou qualquer outra linha com uma mensagem diferente no final.</p><pre className="language-text" code="Oct 17 00:00:04 ebpf-chaos systemd[1]: dpkg-db-backup.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Daily dpkg database backup service.
" language="text" meta=""><code>Oct 17 00:00:04 ebpf-chaos systemd[1]: dpkg-db-backup.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Daily dpkg database backup service.
</code></pre><p>Instrua o Code Suggestions a ler o arquivo <code>log-data/sample.log</code> e imprimir o conteúdo.</p><p><img alt="Code Suggestions: leia o arquivo de log e o imprima" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398607/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_read_log_file_and_print.png" title="Code Suggestions: leia o arquivo de log e o imprima" /></p><pre className="language-python shiki shiki-themes github-light" code="# Read the file in log-data/sample.log and print its content
with open(&#39;log-data/sample.log&#39;, &#39;r&#39;) as f:
    print(f.read())

" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Read the file in log-data/sample.log and print its content
</span></span><span class="line" line="2"><span class="sD7c4">with</span><span class="sYu0t"> open</span><span class="sgsFI">(</span><span class="sYBdl">&#39;log-data/sample.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;r&#39;</span><span class="sgsFI">) </span><span class="sD7c4">as</span><span class="sgsFI"> f:
</span></span><span class="line" line="3"><span class="sYu0t">    print</span><span class="sgsFI">(f.read())
</span></span></code></pre><p><strong>Dica:</strong> repare na indentação aqui. A instrução <code>with open() as f:</code> abre um novo escopo em que <code>f</code> fica disponível como stream. Esse fluxo exige indentar (<code>tab</code>) o bloco de código e realizar as ações dentro desse escopo, chamando <code>f.read()</code> para ler o conteúdo do arquivo e passando o valor imediato como parâmetro para a função <code>print()</code>.</p><p>Volte ao terminal e execute o script novamente com <code>python3 log_reader.py</code>. Você vai ver o conteúdo do arquivo, já exibido no editor do VS Code, também impresso no terminal.</p><p><img alt="Terminal do VS Code: leia o arquivo de log e o imprima" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398608/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_terminal_print_logfile_show_file_sample.png" title="Terminal do VS Code: leia o arquivo de log e o imprima" /></p><h2 id="controle-de-fluxo">Controle de fluxo</h2><p>Ler um único arquivo de log não é suficiente, afinal, queremos analisar todos os arquivos de um diretório de forma recursiva. Para o próximo exercício, vamos instruir o Code Suggestions a criar um índice de todos os arquivos.</p><p>Prepare o diretório <code>log-data</code> com mais arquivos de exemplo, a partir do <a href="https://gitlab.com/gitlab-da/use-cases/ai/learn-with-ai/learn-python-ai/-/tree/main/log-data?ref_type=heads" rel="">diretório log-data no projeto de exemplo</a>. A árvore do diretório deve ficar assim:</p><pre className="language-shell shiki shiki-themes github-light" code="tree log-data                                                             ─╯
log-data
├── sample.log
└── var
    └── log
        ├── auth.log
        ├── syslog.log
        └── syslog_structured.log

3 directories, 4 files
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">tree</span><span class="sYBdl"> log-data</span><span class="sYBdl">                                                             ─╯
</span></span><span class="line" line="2"><span class="s7eDp">log-data
</span></span><span class="line" line="3"><span class="s7eDp">├──</span><span class="sYBdl"> sample.log
</span></span><span class="line" line="4"><span class="s7eDp">└──</span><span class="sYBdl"> var
</span></span><span class="line" line="5"><span class="s7eDp">    └──</span><span class="sYBdl"> log
</span></span><span class="line" line="6"><span class="s7eDp">        ├──</span><span class="sYBdl"> auth.log
</span></span><span class="line" line="7"><span class="s7eDp">        ├──</span><span class="sYBdl"> syslog.log
</span></span><span class="line" line="8"><span class="s7eDp">        └──</span><span class="sYBdl"> syslog_structured.log
</span></span><span class="line" line="9"><span emptyLinePlaceholder>
</span></span><span class="line" line="10"><span class="s7eDp">3</span><span class="sYBdl"> directories,</span><span class="sYu0t"> 4</span><span class="sYBdl"> files
</span></span></code></pre><h3 id="loops-e-listas-para-coletar-arquivos">Loops e listas para coletar arquivos</h3><p>Altere a variável <code>path</code> para usar o valor <code>log-data/</code>.</p><pre className="language-python shiki shiki-themes github-light" code="# Specify the path and file suffix in variables
path = &#39;log-data/&#39;
file_suffix = &#39;.log&#39;
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Specify the path and file suffix in variables
</span></span><span class="line" line="2"><span class="sgsFI">path </span><span class="sD7c4">=</span><span class="sYBdl"> &#39;log-data/&#39;
</span></span><span class="line" line="3"><span class="sgsFI">file_suffix </span><span class="sD7c4">=</span><span class="sYBdl"> &#39;.log&#39;
</span></span></code></pre><p>Peça ao Code Suggestions para ler todos os caminhos de arquivo do diretório em uma lista. Depois do loop de coleta, imprima a lista de caminhos dos arquivos de log.</p><pre className="language-python shiki shiki-themes github-light" code="# Read all file paths in the directory into a list

# Print the list of log file paths
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Read all file paths in the directory into a list
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sAwPA"># Print the list of log file paths
</span></span></code></pre><p><img alt="Code Suggestion, coletar caminhos de arquivo" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398601/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_collect_files.png" title="Code Suggestion, coletar caminhos de arquivo" /></p><p>Uma sugestão possível seria algo assim:</p><pre className="language-python shiki shiki-themes github-light" code="# Read all file paths in the directory into a list
import os

# Read all file paths in the directory into a list
log_files = []
for root, directories, files in os.walk(path):
    for file in files:
        if file.endswith(file_suffix):
            log_files.append(os.path.join(root, file))

# Print the list of log file paths

print(log_files)
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Read all file paths in the directory into a list
</span></span><span class="line" line="2"><span class="sD7c4">import</span><span class="sgsFI"> os
</span></span><span class="line" line="3"><span emptyLinePlaceholder>
</span></span><span class="line" line="4"><span class="sAwPA"># Read all file paths in the directory into a list
</span></span><span class="line" line="5"><span class="sgsFI">log_files </span><span class="sD7c4">=</span><span class="sgsFI"> []
</span></span><span class="line" line="6"><span class="sD7c4">for</span><span class="sgsFI"> root, directories, files </span><span class="sD7c4">in</span><span class="sgsFI"> os.walk(path):
</span></span><span class="line" line="7"><span class="sD7c4">    for</span><span class="sqxcx"> file</span><span class="sD7c4"> in</span><span class="sgsFI"> files:
</span></span><span class="line" line="8"><span class="sD7c4">        if</span><span class="sqxcx"> file</span><span class="sgsFI">.endswith(file_suffix):
</span></span><span class="line" line="9"><span class="sgsFI">            log_files.append(os.path.join(root, </span><span class="sqxcx">file</span><span class="sgsFI">))
</span></span><span class="line" line="10"><span emptyLinePlaceholder>
</span></span><span class="line" line="11"><span class="sAwPA"># Print the list of log file paths
</span></span><span class="line" line="12"><span emptyLinePlaceholder>
</span></span><span class="line" line="13"><span class="sYu0t">print</span><span class="sgsFI">(log_files)
</span></span></code></pre><p>Vamos entender o que acontece aqui: a instrução <code>import os</code> é necessária para trazer a biblioteca <code>os</code> para o escopo atual, permitindo chamar <code>os.walk()</code> mais adiante. A <a href="https://docs.python.org/3/library/stdtypes.html#sequence-types-list-tuple-range" rel="">lista</a> <code>log_files</code> é inicializada vazia, usando colchetes vazios. A função <code>os.walk()</code> espera receber um caminho como árvore de diretórios para começar a busca pelos arquivos, e retorna um objeto gerador, que percorre a árvore de diretórios recursivamente. As tuplas retornadas incluem os arquivos coletados, que acessamos em um loop usando a notação <code>for</code>. Quando um arquivo termina com o sufixo definido, seu caminho completo é adicionado à lista. Este é um exemplo já otimizado e um pouco mais complexo, então, não se preocupe em entender tudo agora, vamos retomar esse ponto mais adiante.</p><h3 id="colete-arquivos-condicionalmente">Colete arquivos condicionalmente</h3><p>Modifique as instruções e adicione a avaliação da flag booleana <code>read_all_files_recursively</code> como entrada da função glob().</p><pre className="language-python shiki shiki-themes github-light" code="# Read all file paths in the top level directory into a list
# If read_all_files_recursively is True, read all files recursively
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Read all file paths in the top level directory into a list
</span></span><span class="line" line="2"><span class="sAwPA"># If read_all_files_recursively is True, read all files recursively
</span></span></code></pre><p><img alt="Code Suggestions, leia arquivos recursivamente de forma condicional" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398607/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_read_files_recursively_conditionally.png" title="Code Suggestions, leia arquivos recursivamente de forma condicional" /></p><pre className="language-text" code="# Read all file paths in the top level directory
import os

# Read all file paths in the top level directory into a list
# If read_all_files_recursively is True, read all files recursively

log_files = []
for file in os.listdir(path):
    if file.endswith(file_suffix):
        log_files.append(os.path.join(path, file))

if read_all_files_recursively:
    for root, directories, files in os.walk(path):
        for file in files:
            if file.endswith(file_suffix):
                log_files.append(os.path.join(root, file))

# Print log_files
print(log_files)
" language="text" meta=""><code># Read all file paths in the top level directory
import os

# Read all file paths in the top level directory into a list
# If read_all_files_recursively is True, read all files recursively

log_files = []
for file in os.listdir(path):
    if file.endswith(file_suffix):
        log_files.append(os.path.join(path, file))

if read_all_files_recursively:
    for root, directories, files in os.walk(path):
        for file in files:
            if file.endswith(file_suffix):
                log_files.append(os.path.join(root, file))

# Print log_files
print(log_files)
</code></pre><p>O resultado ainda não é o ideal, porque o primeiro loop sempre é executado, e o segundo, opcionalmente também. Esse fluxo gera resultados duplicados quando o script é executado.</p><pre className="language-shell shiki shiki-themes github-light" code="python3 log_reader.py

[&#39;log-data/sample.log&#39;, &#39;log-data/sample.log&#39;, &#39;log-data/var/log/auth.log&#39;]
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">python3</span><span class="sYBdl"> log_reader.py
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">[</span><span class="sYBdl">&#39;log-data/sample.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;log-data/sample.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">]
</span></span></code></pre><p>Experimente diferentes instruções no Code Suggestions para chegar a uma solução para o problema. Existem algumas abordagens possíveis:</p><ol><li>Uma solução possível é envolver o código em um bloco if-then-else, movendo o loop <code>os.listdir()</code> para o bloco else.</li></ol><pre className="language-python shiki shiki-themes github-light" code="if read_all_files_recursively:
    for root, directories, files in os.walk(path):
        for file in files:
            if file.endswith(file_suffix):
                log_files.append(os.path.join(root, file))
else:
    for file in os.listdir(path):
        if file.endswith(file_suffix):
            log_files.append(os.path.join(path, file))

" language="python" meta="" style=""><code><span class="line" line="1"><span class="sD7c4">if</span><span class="sgsFI"> read_all_files_recursively:
</span></span><span class="line" line="2"><span class="sD7c4">    for</span><span class="sgsFI"> root, directories, files </span><span class="sD7c4">in</span><span class="sgsFI"> os.walk(path):
</span></span><span class="line" line="3"><span class="sD7c4">        for</span><span class="sqxcx"> file</span><span class="sD7c4"> in</span><span class="sgsFI"> files:
</span></span><span class="line" line="4"><span class="sD7c4">            if</span><span class="sqxcx"> file</span><span class="sgsFI">.endswith(file_suffix):
</span></span><span class="line" line="5"><span class="sgsFI">                log_files.append(os.path.join(root, </span><span class="sqxcx">file</span><span class="sgsFI">))
</span></span><span class="line" line="6"><span class="sD7c4">else</span><span class="sgsFI">:
</span></span><span class="line" line="7"><span class="sD7c4">    for</span><span class="sqxcx"> file</span><span class="sD7c4"> in</span><span class="sgsFI"> os.listdir(path):
</span></span><span class="line" line="8"><span class="sD7c4">        if</span><span class="sqxcx"> file</span><span class="sgsFI">.endswith(file_suffix):
</span></span><span class="line" line="9"><span class="sgsFI">            log_files.append(os.path.join(path, </span><span class="sqxcx">file</span><span class="sgsFI">))
</span></span></code></pre><ol start="2"><li>Outra opção é não usar <code>append()</code> para sempre adicionar uma nova entrada na lista, mas verificar antes se o item já existe na lista.</li></ol><pre className="language-python shiki shiki-themes github-light" code="for file in os.listdir(path):
    if file.endswith(file_suffix):
        # check if the entry exists in the list already
        if os.path.isfile(os.path.join(path, file)):
            log_files.append(os.path.join(path, file))

if read_all_files_recursively:
    for root, directories, files in os.walk(path):
        for file in files:
            if file.endswith(file_suffix):
                # check if the entry exists in the list already
                if file not in log_files:
                    log_files.append(os.path.join(root, file))

" language="python" meta="" style=""><code><span class="line" line="1"><span class="sD7c4">for</span><span class="sqxcx"> file</span><span class="sD7c4"> in</span><span class="sgsFI"> os.listdir(path):
</span></span><span class="line" line="2"><span class="sD7c4">    if</span><span class="sqxcx"> file</span><span class="sgsFI">.endswith(file_suffix):
</span></span><span class="line" line="3"><span class="sAwPA">        # check if the entry exists in the list already
</span></span><span class="line" line="4"><span class="sD7c4">        if</span><span class="sgsFI"> os.path.isfile(os.path.join(path, </span><span class="sqxcx">file</span><span class="sgsFI">)):
</span></span><span class="line" line="5"><span class="sgsFI">            log_files.append(os.path.join(path, </span><span class="sqxcx">file</span><span class="sgsFI">))
</span></span><span class="line" line="6"><span emptyLinePlaceholder>
</span></span><span class="line" line="7"><span class="sD7c4">if</span><span class="sgsFI"> read_all_files_recursively:
</span></span><span class="line" line="8"><span class="sD7c4">    for</span><span class="sgsFI"> root, directories, files </span><span class="sD7c4">in</span><span class="sgsFI"> os.walk(path):
</span></span><span class="line" line="9"><span class="sD7c4">        for</span><span class="sqxcx"> file</span><span class="sD7c4"> in</span><span class="sgsFI"> files:
</span></span><span class="line" line="10"><span class="sD7c4">            if</span><span class="sqxcx"> file</span><span class="sgsFI">.endswith(file_suffix):
</span></span><span class="line" line="11"><span class="sAwPA">                # check if the entry exists in the list already
</span></span><span class="line" line="12"><span class="sD7c4">                if</span><span class="sqxcx"> file</span><span class="sD7c4"> not</span><span class="sD7c4"> in</span><span class="sgsFI"> log_files:
</span></span><span class="line" line="13"><span class="sgsFI">                    log_files.append(os.path.join(root, </span><span class="sqxcx">file</span><span class="sgsFI">))
</span></span></code></pre><ol start="3"><li>Ou então, podemos eliminar as entradas duplicadas depois de coletar todos os itens. O Python permite converter listas em <a href="https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset" rel="">sets</a>, que armazenam apenas entradas únicas. Depois de aplicar <code>set()</code>, você pode converter o set de volta para uma lista. O Code Suggestions já conhece essa possibilidade e ajuda com o comentário <code># Ensure that only unique file paths are in the list</code>.</li></ol><p><img alt="Code Suggestions, convertendo uma lista em itens únicos" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398607/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_unique_list.png" title="Code Suggestions, convertendo uma lista em itens únicos" /></p><pre className="language-python shiki shiki-themes github-light" code="# Ensure that only unique file paths are in the list

log_files = list(set(log_files))
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Ensure that only unique file paths are in the list
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">log_files </span><span class="sD7c4">=</span><span class="sYu0t"> list</span><span class="sgsFI">(</span><span class="sYu0t">set</span><span class="sgsFI">(log_files))
</span></span></code></pre><ol start="4"><li>Dê um passo atrás e avalie se a variável <code>read_all_files_recursively</code> ainda faz sentido. É possível que o comportamento padrão devesse simplesmente ser ler todos os arquivos recursivamente?</li></ol><p><strong>Dica para testar diferentes caminhos no VS Code:</strong> selecione os blocos de código e pressione <a href="https://code.visualstudio.com/docs/getstarted/keybindings" rel=""><code>cmd /</code> no macOS</a> para comentá-los.</p><h2 id="funções">Funções</h2><p>Vamos criar uma função chamada <code>parse_log_file</code>, que faz o parsing de um arquivo de log e retorna os dados extraídos. Vamos definir o formato de log esperado e as colunas a serem extraídas, seguindo a <a href="https://en.wikipedia.org/wiki/Syslog" rel="">especificação do formato syslog</a>. Existem diferentes tipos de formato de log, além de formatos personalizados criados por desenvolvedores, que também precisam ser considerados. Isto fica como exercício para depois.</p><h3 id="comece-com-um-formato-de-log-simples">Comece com um formato de log simples</h3><p>Inspecione uma VM Linux em execução, ou use o exemplo de arquivo de log a seguir para a implementação.</p><pre className="language-text" code="less /var/log/syslog | grep -v docker

Oct 17 00:00:04 ebpf-chaos systemd[1]: Starting Daily dpkg database backup service...
Oct 17 00:00:04 ebpf-chaos systemd[1]: Starting Rotate log files...
Oct 17 00:00:04 ebpf-chaos systemd[1]: dpkg-db-backup.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Daily dpkg database backup service.
Oct 17 00:00:04 ebpf-chaos systemd[1]: logrotate.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.
Oct 17 00:17:01 ebpf-chaos CRON[727495]: (root) CMD (   cd / &amp;&amp; run-parts --report /etc/cron.hourly)
" language="text" meta=""><code>less /var/log/syslog | grep -v docker

Oct 17 00:00:04 ebpf-chaos systemd[1]: Starting Daily dpkg database backup service...
Oct 17 00:00:04 ebpf-chaos systemd[1]: Starting Rotate log files...
Oct 17 00:00:04 ebpf-chaos systemd[1]: dpkg-db-backup.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Daily dpkg database backup service.
Oct 17 00:00:04 ebpf-chaos systemd[1]: logrotate.service: Deactivated successfully.
Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.
Oct 17 00:17:01 ebpf-chaos CRON[727495]: (root) CMD (   cd / &amp;&amp; run-parts --report /etc/cron.hourly)
</code></pre><p>Podemos criar um algoritmo para dividir cada linha de log por espaços em branco e depois juntar os resultados novamente. Vamos pedir ajuda ao Code Suggestions.</p><pre className="language-python shiki shiki-themes github-light" code="# Split log line &quot;Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.&quot; by whitespaces and save in a list

log_line = &quot;Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.&quot;
log_line_split = log_line.split(&quot; &quot;)
print(log_line_split)
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Split log line &quot;Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.&quot; by whitespaces and save in a list
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">log_line </span><span class="sD7c4">=</span><span class="sYBdl"> &quot;Oct 17 00:00:04 ebpf-chaos systemd[1]: Finished Rotate log files.&quot;
</span></span><span class="line" line="4"><span class="sgsFI">log_line_split </span><span class="sD7c4">=</span><span class="sgsFI"> log_line.split(</span><span class="sYBdl">&quot; &quot;</span><span class="sgsFI">)
</span></span><span class="line" line="5"><span class="sYu0t">print</span><span class="sgsFI">(log_line_split)
</span></span></code></pre><p>Execute o script novamente para verificar o resultado.</p><pre className="language-shell shiki shiki-themes github-light" code="python3 log_reader.py

[&#39;Oct&#39;, &#39;17&#39;, &#39;00:00:04&#39;, &#39;ebpf-chaos&#39;, &#39;systemd[1]:&#39;, &#39;Finished&#39;, &#39;Rotate&#39;, &#39;log&#39;, &#39;files.&#39;]
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">python3</span><span class="sYBdl"> log_reader.py
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">[</span><span class="sYBdl">&#39;Oct&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;17&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;00:00:04&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;ebpf-chaos&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;systemd[1]:&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;Finished&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;Rotate&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;files.&#39;</span><span class="sgsFI">]
</span></span></code></pre><p>Os três primeiros itens fazem parte da string de data e hora, seguidos pelo host, o serviço e o restante dos itens da mensagem de log. Vamos praticar operações com strings em Python no próximo passo.</p><h3 id="operações-com-strings-e-estruturas-de-dados">Operações com strings e estruturas de dados</h3><p>Vamos pedir ajuda ao Code Suggestions para aprender a juntar strings e realizar operações com listas.</p><ol><li>Junte os três primeiros itens novamente, separados por espaço.</li><li>Mantenha o host e o serviço.</li><li>Junte a contagem de itens variável restante em uma string, novamente separada por espaços.</li><li>Armazene as chaves de coluna identificadas e seus respectivos valores em uma nova estrutura de dados: um <a href="https://docs.python.org/3/library/stdtypes.html#mapping-types-dict" rel="">dicionário</a>.</li></ol><p><img alt="Code suggestions para itens de lista com operações de string" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398602/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_list_items_string_join_extract.png" title="Code suggestions para itens de lista com operações de string" /></p><pre className="language-shell shiki shiki-themes github-light" code="python3 log_reader.py

# Array
[&#39;Oct&#39;, &#39;17&#39;, &#39;00:00:04&#39;, &#39;ebpf-chaos&#39;, &#39;systemd[1]:&#39;, &#39;Finished&#39;, &#39;Rotate&#39;, &#39;log&#39;, &#39;files.&#39;]

# Dictionary
{&#39;datetime&#39;: &#39;Oct 17 00:00:04&#39;, &#39;host&#39;: &#39;ebpf-chaos&#39;, &#39;service&#39;: &#39;systemd[1]:&#39;, &#39;message&#39;: &#39; ebpf-chaos systemd[1]: Finished Rotate log files.&#39;}
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">python3</span><span class="sYBdl"> log_reader.py
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sAwPA"># Array
</span></span><span class="line" line="4"><span class="sgsFI">[</span><span class="sYBdl">&#39;Oct&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;17&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;00:00:04&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;ebpf-chaos&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;systemd[1]:&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;Finished&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;Rotate&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;files.&#39;</span><span class="sgsFI">]
</span></span><span class="line" line="5"><span emptyLinePlaceholder>
</span></span><span class="line" line="6"><span class="sAwPA"># Dictionary
</span></span><span class="line" line="7"><span class="sgsFI">{</span><span class="s7eDp">&#39;datetime&#39;</span><span class="sYu0t">:</span><span class="sYBdl"> &#39;Oct 17 00:00:04&#39;,</span><span class="sYBdl"> &#39;host&#39;:</span><span class="sYBdl"> &#39;ebpf-chaos&#39;,</span><span class="sYBdl"> &#39;service&#39;:</span><span class="sYBdl"> &#39;systemd[1]:&#39;,</span><span class="sYBdl"> &#39;message&#39;:</span><span class="sYBdl"> &#39; ebpf-chaos systemd[1]: Finished Rotate log files.&#39;}
</span></span></code></pre><p>Uma sugestão funcional pode ficar assim:</p><pre className="language-python shiki shiki-themes github-light" code="# Initialize results dictionary with empty values for datetime, host, service, message
# Loop over log line split
# Join the first three list items as date string
# Item 4: host
# Item 5: service
# Join the remaining items into a string, separated with whitespaces
# Print the results after the loop

results = {&#39;datetime&#39;: &#39;&#39;, &#39;host&#39;: &#39;&#39;, &#39;service&#39;: &#39;&#39;, &#39;message&#39;: &#39;&#39;}

for item in log_line_split:

    if results[&#39;datetime&#39;] == &#39;&#39;:
        results[&#39;datetime&#39;] = &#39; &#39;.join(log_line_split[0:3])

    elif results[&#39;host&#39;] == &#39;&#39;:
        results[&#39;host&#39;] = log_line_split[3]

    elif results[&#39;service&#39;] == &#39;&#39;:
        results[&#39;service&#39;] = log_line_split[4]

    else:
        results[&#39;message&#39;] += &#39; &#39; + item

print(results)
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Initialize results dictionary with empty values for datetime, host, service, message
</span></span><span class="line" line="2"><span class="sAwPA"># Loop over log line split
</span></span><span class="line" line="3"><span class="sAwPA"># Join the first three list items as date string
</span></span><span class="line" line="4"><span class="sAwPA"># Item 4: host
</span></span><span class="line" line="5"><span class="sAwPA"># Item 5: service
</span></span><span class="line" line="6"><span class="sAwPA"># Join the remaining items into a string, separated with whitespaces
</span></span><span class="line" line="7"><span class="sAwPA"># Print the results after the loop
</span></span><span class="line" line="8"><span emptyLinePlaceholder>
</span></span><span class="line" line="9"><span class="sgsFI">results </span><span class="sD7c4">=</span><span class="sgsFI"> {</span><span class="sYBdl">&#39;datetime&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;host&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;service&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;message&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;&#39;</span><span class="sgsFI">}
</span></span><span class="line" line="10"><span emptyLinePlaceholder>
</span></span><span class="line" line="11"><span class="sD7c4">for</span><span class="sgsFI"> item </span><span class="sD7c4">in</span><span class="sgsFI"> log_line_split:
</span></span><span class="line" line="12"><span emptyLinePlaceholder>
</span></span><span class="line" line="13"><span class="sD7c4">    if</span><span class="sgsFI"> results[</span><span class="sYBdl">&#39;datetime&#39;</span><span class="sgsFI">] </span><span class="sD7c4">==</span><span class="sYBdl"> &#39;&#39;</span><span class="sgsFI">:
</span></span><span class="line" line="14"><span class="sgsFI">        results[</span><span class="sYBdl">&#39;datetime&#39;</span><span class="sgsFI">] </span><span class="sD7c4">=</span><span class="sYBdl"> &#39; &#39;</span><span class="sgsFI">.join(log_line_split[</span><span class="sYu0t">0</span><span class="sgsFI">:</span><span class="sYu0t">3</span><span class="sgsFI">])
</span></span><span class="line" line="15"><span emptyLinePlaceholder>
</span></span><span class="line" line="16"><span class="sD7c4">    elif</span><span class="sgsFI"> results[</span><span class="sYBdl">&#39;host&#39;</span><span class="sgsFI">] </span><span class="sD7c4">==</span><span class="sYBdl"> &#39;&#39;</span><span class="sgsFI">:
</span></span><span class="line" line="17"><span class="sgsFI">        results[</span><span class="sYBdl">&#39;host&#39;</span><span class="sgsFI">] </span><span class="sD7c4">=</span><span class="sgsFI"> log_line_split[</span><span class="sYu0t">3</span><span class="sgsFI">]
</span></span><span class="line" line="18"><span emptyLinePlaceholder>
</span></span><span class="line" line="19"><span class="sD7c4">    elif</span><span class="sgsFI"> results[</span><span class="sYBdl">&#39;service&#39;</span><span class="sgsFI">] </span><span class="sD7c4">==</span><span class="sYBdl"> &#39;&#39;</span><span class="sgsFI">:
</span></span><span class="line" line="20"><span class="sgsFI">        results[</span><span class="sYBdl">&#39;service&#39;</span><span class="sgsFI">] </span><span class="sD7c4">=</span><span class="sgsFI"> log_line_split[</span><span class="sYu0t">4</span><span class="sgsFI">]
</span></span><span class="line" line="21"><span emptyLinePlaceholder>
</span></span><span class="line" line="22"><span class="sD7c4">    else</span><span class="sgsFI">:
</span></span><span class="line" line="23"><span class="sgsFI">        results[</span><span class="sYBdl">&#39;message&#39;</span><span class="sgsFI">] </span><span class="sD7c4">+=</span><span class="sYBdl"> &#39; &#39;</span><span class="sD7c4"> +</span><span class="sgsFI"> item
</span></span><span class="line" line="24"><span emptyLinePlaceholder>
</span></span><span class="line" line="25"><span class="sYu0t">print</span><span class="sgsFI">(results)
</span></span></code></pre><p>O algoritmo sugerido percorre todos os itens da linha de log e aplica a mesma operação para os três primeiros. <code>log_line_split[0:3]</code> extrai uma fatia com três itens em uma nova lista. Chamar <code>join()</code> em um caractere separador e passar o array como argumento junta os itens em uma string. O algoritmo continua verificando se os valores de host (item 4) e serviço (item 5) ainda não foram preenchidos, e termina anexando os itens restantes da lista à string da mensagem. Para ser sincero, eu teria usado um algoritmo um pouco diferente, mas é uma boa curva de aprendizado conhecer outras formas de implementar a mesma coisa. Pratique com instruções e estruturas de dados diferentes, e continue imprimindo os conjuntos de dados.</p><p><strong>Dica:</strong> se você precisar encerrar um script antes da hora, use <code>sys.exit()</code>. O restante do código não vai ser executado.</p><pre className="language-python shiki shiki-themes github-light" code="import sys
sys.exit(1)
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sD7c4">import</span><span class="sgsFI"> sys
</span></span><span class="line" line="2"><span class="sgsFI">sys.exit(</span><span class="sYu0t">1</span><span class="sgsFI">)
</span></span></code></pre><p>Imagine fazer essas operações para diferentes formatos e tipos de mensagem de log — a complexidade e o risco de erro crescem rápido. Por isso, talvez exista outra abordagem.</p><h3 id="faça-o-parsing-de-arquivos-de-log-usando-expressões-regulares">Faça o parsing de arquivos de log usando expressões regulares</h3><p>Existem diferentes RFCs para o formato syslog: a <a href="https://datatracker.ietf.org/doc/html/rfc3164" rel="">RFC 3164</a> está obsoleta, mas ainda aparece na prática como configuração padrão (seguindo o padrão visto acima), enquanto a <a href="https://datatracker.ietf.org/doc/html/rfc5424" rel="">RFC 5424</a> é mais moderna e inclui informações de fuso horário na data e hora. Fazer o parsing desse formato pode ser complicado, então vamos pedir orientação ao Code Suggestions.</p><p>Em alguns casos, as sugestões incluem expressões regulares. Elas podem não funcionar de primeira, o que torna o código mais difícil de depurar, exigindo tentativa e erro. Um bom recurso independente para testar e entender expressões regulares é o <a href="https://regex101.com/" rel="">regex101.com</a>.</p><p><strong>Dica:</strong> você pode evitar se aprofundar em expressões regulares usando o trecho de código a seguir como um atalho rápido. O próximo passo é instruir o Code Suggestions a usar esses padrões de log e nos ajudar a extrair todas as colunas relevantes.</p><pre className="language-python shiki shiki-themes github-light" code="# Define the syslog log format regex in a dictionary
# Add entries for RFC3164, RFC5424
regex_log_pattern = {
    &#39;rfc3164&#39;: &#39;([A-Z][a-z][a-z]\s{1,2}\d{1,2}\s\d{2}[:]\d{2}[:]\d{2})\s([\w][\w\d\.@-]*)\s(.*)$&#39;,
    &#39;rfc5424&#39;: &#39;(?:(\d{4}[-]\d{2}[-]\d{2}[T]\d{2}[:]\d{2}[:]\d{2}(?:\.\d{1,6})?(?:[+-]\d{2}[:]\d{2}|Z)?)|-)\s(?:([\w][\w\d\.@-]*)|-)\s(.*)$;&#39;
}
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Define the syslog log format regex in a dictionary
</span></span><span class="line" line="2"><span class="sAwPA"># Add entries for RFC3164, RFC5424
</span></span><span class="line" line="3"><span class="sgsFI">regex_log_pattern </span><span class="sD7c4">=</span><span class="sgsFI"> {
</span></span><span class="line" line="4"><span class="sYBdl">    &#39;rfc3164&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;([A-Z][a-z][a-z]\s{1,2}\d{1,2}\s\d{2}[:]\d{2}[:]\d{2})\s([\w][\w\d\.@-]*)\s(.*)$&#39;</span><span class="sgsFI">,
</span></span><span class="line" line="5"><span class="sYBdl">    &#39;rfc5424&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;(?:(\d</span><span class="sYu0t">{4}</span><span class="sYBdl">[-]\d</span><span class="sYu0t">{2}</span><span class="sYBdl">[-]\d</span><span class="sYu0t">{2}</span><span class="sYBdl">[T]\d</span><span class="sYu0t">{2}</span><span class="sYBdl">[:]\d</span><span class="sYu0t">{2}</span><span class="sYBdl">[:]\d</span><span class="sYu0t">{2}</span><span class="sYBdl">(?:\.\d{1,6})?(?:[+-]\d{2}[:]\d{2}|Z)?)|-)\s(?:([\w][\w\d\.@-]*)|-)\s(.*)$;&#39;
</span></span><span class="line" line="6"><span class="sgsFI">}
</span></span></code></pre><p>Já sabemos o que a função deve fazer e quais são os parâmetros de entrada — o nome do arquivo e um padrão de log para dar match. As linhas de log devem ser divididas por essa expressão regular, retornando um dicionário de chave-valor para cada linha. A função deve retornar uma lista de dicionários.</p><pre className="language-python shiki shiki-themes github-light" code="# Create a function that parses a log file
# Input parameter: file path
# Match log line against regex_log_pattern
# Return the results as dictionary list: log line, pattern, extracted columns
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Create a function that parses a log file
</span></span><span class="line" line="2"><span class="sAwPA"># Input parameter: file path
</span></span><span class="line" line="3"><span class="sAwPA"># Match log line against regex_log_pattern
</span></span><span class="line" line="4"><span class="sAwPA"># Return the results as dictionary list: log line, pattern, extracted columns
</span></span></code></pre><p><img alt="Code suggestion baseado em uma instrução de comentário multilinha para gerar uma função que faz parsing de um arquivo de log com base em padrões regex" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398602/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_log_format_regex_function_instructions_01.png" title="Code suggestion baseado em uma instrução de comentário multilinha para gerar uma função que faz parsing de um arquivo de log com base em padrões regex" /></p><p>Lembra da indentação para abrir um novo escopo? A mesma regra vale para funções em Python. O identificador <code>def</code> exige um nome de função e uma lista de parâmetros, seguidos por dois-pontos de abertura. As próximas linhas de código precisam da indentação. O VS Code ajuda com o live-linting de indentação incorreta, antes que a execução do script falhe — ou os pipelines de CI/CD.</p><p>Continue com o Code Suggestions — ele já deve saber que você quer fazer o parsing de todos os arquivos de log, usando a função recém-criada.</p><p><img alt="Code suggestion para fazer parsing de todos os arquivos de log e imprimir o conjunto de resultados" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398603/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_log_format_regex_function_instructions_02.png" title="Code suggestion para fazer parsing de todos os arquivos de log e imprimir o conjunto de resultados" /></p><p>Um exemplo completo e funcional pode ficar assim:</p><pre className="language-text" code="import os

# Specify the path and file suffix in variables
path = &#39;log-data/&#39;
file_suffix = &#39;.log&#39;

# Read all file paths in the directory into a list
log_files = []
for root, directories, files in os.walk(path):
    for file in files:
        if file.endswith(file_suffix):
            log_files.append(os.path.join(root, file))

# Define the syslog log format regex in a dictionary
# Add entries for RFC3164, RFC5424
regex_log_pattern = {
    &#39;rfc3164&#39;: &#39;([A-Z][a-z][a-z]\s{1,2}\d{1,2}\s\d{2}[:]\d{2}[:]\d{2})\s([\w][\w\d\.@-]*)\s(.*)$&#39;,
    &#39;rfc5424&#39;: &#39;(?:(\d{4}[-]\d{2}[-]\d{2}[T]\d{2}[:]\d{2}[:]\d{2}(?:\.\d{1,6})?(?:[+-]\d{2}[:]\d{2}|Z)?)|-)\s(?:([\w][\w\d\.@-]*)|-)\s(.*)$;&#39;
}

# Create a function that parses a log file
# Input parameter: file path
# Match log line against regex_log_pattern
# Return the results as dictionary list: log line, pattern name, extracted columns
import re

def parse_log_file(file_path):
    # Read the log file
    with open(file_path, &#39;r&#39;) as f:
        log_lines = f.readlines()

    # Create a list to store the results
    results = []

    # Iterate over the log lines
    for log_line in log_lines:
        # Match the log line against the regex pattern
        for pattern_name, pattern in regex_log_pattern.items():
            match = re.match(pattern, log_line)

            # If the log line matches the pattern, add the results to the list
            if match:
                extracted_columns = match.groups()
                results.append({
                    &#39;log_line&#39;: log_line,
                    &#39;pattern_name&#39;: pattern_name,
                    &#39;extracted_columns&#39;: extracted_columns,
                    &#39;source_file&#39;: file_path
                })

    # Return the results
    return results

# Parse all files and print results
for log_file in log_files:
    results = parse_log_file(log_file)
    print(results)

" language="text" meta=""><code>import os

# Specify the path and file suffix in variables
path = &#39;log-data/&#39;
file_suffix = &#39;.log&#39;

# Read all file paths in the directory into a list
log_files = []
for root, directories, files in os.walk(path):
    for file in files:
        if file.endswith(file_suffix):
            log_files.append(os.path.join(root, file))

# Define the syslog log format regex in a dictionary
# Add entries for RFC3164, RFC5424
regex_log_pattern = {
    &#39;rfc3164&#39;: &#39;([A-Z][a-z][a-z]\s{1,2}\d{1,2}\s\d{2}[:]\d{2}[:]\d{2})\s([\w][\w\d\.@-]*)\s(.*)$&#39;,
    &#39;rfc5424&#39;: &#39;(?:(\d{4}[-]\d{2}[-]\d{2}[T]\d{2}[:]\d{2}[:]\d{2}(?:\.\d{1,6})?(?:[+-]\d{2}[:]\d{2}|Z)?)|-)\s(?:([\w][\w\d\.@-]*)|-)\s(.*)$;&#39;
}

# Create a function that parses a log file
# Input parameter: file path
# Match log line against regex_log_pattern
# Return the results as dictionary list: log line, pattern name, extracted columns
import re

def parse_log_file(file_path):
    # Read the log file
    with open(file_path, &#39;r&#39;) as f:
        log_lines = f.readlines()

    # Create a list to store the results
    results = []

    # Iterate over the log lines
    for log_line in log_lines:
        # Match the log line against the regex pattern
        for pattern_name, pattern in regex_log_pattern.items():
            match = re.match(pattern, log_line)

            # If the log line matches the pattern, add the results to the list
            if match:
                extracted_columns = match.groups()
                results.append({
                    &#39;log_line&#39;: log_line,
                    &#39;pattern_name&#39;: pattern_name,
                    &#39;extracted_columns&#39;: extracted_columns,
                    &#39;source_file&#39;: file_path
                })

    # Return the results
    return results

# Parse all files and print results
for log_file in log_files:
    results = parse_log_file(log_file)
    print(results)

</code></pre><p>Vamos entender o que a função <code>parse_log_file()</code> faz:</p><ol><li>Abre o arquivo a partir do parâmetro <code>file_path</code>.</li><li>Lê todas as linhas em uma nova variável, <code>log_lines</code>.</li><li>Cria uma lista de resultados para armazenar todos os itens.</li><li>Itera sobre as linhas de log.</li><li>Confere o match contra todos os padrões regex configurados em <code>regex_log_pattern</code>.</li><li>Se encontra um match, extrai os valores das colunas correspondentes.</li><li>Cria um item de resultado, incluindo os valores das chaves <code>log_line</code>, <code>pattern_name</code>, <code>extracted_colums</code> e <code>source_file</code>.</li><li>Adiciona o item de resultado à lista de resultados.</li><li>Retorna a lista de resultados.</li></ol><p>Existem diferentes variações possíveis para isso, especialmente na estrutura de dados retornada. Neste caso específico, as linhas de log já vêm como lista. Adicionar um objeto de dicionário em vez de uma linha de log bruta permite que quem chama a função extraia a informação desejada no próximo passo. Depois de implementar um exemplo funcional, você também pode refatorar o código mais tarde.</p><h3 id="formato-de-log-avançado-authlog">Formato de log avançado: auth.log</h3><p>Fazer o parsing do syslog em uma distribuição Linux pode não revelar os dados necessários para a análise. Em uma máquina virtual que expõe a porta 22 (SSH) para a internet, o log de autenticação é muito mais interessante — cheio de bots e agentes maliciosos testando combinações de senha padrão, muitas vezes com ataques de força bruta.</p><p>O trecho a seguir, extraído do <code>/var/log/auth.log</code> de um dos meus servidores privados, mostra o formato do log de autenticação e as tentativas aleatórias de bots usando diferentes nomes de usuário, entre outras coisas.</p><pre className="language-text" code="Oct 15 00:00:19 ebpf-chaos sshd[3967944]: Failed password for invalid user ubuntu from 93.254.246.194 port 48840 ssh2
Oct 15 00:00:20 ebpf-chaos sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2
Oct 15 00:00:21 ebpf-chaos sshd[3967944]: Received disconnect from 93.254.246.194 port 48840:11: Bye Bye [preauth]
Oct 15 00:00:21 ebpf-chaos sshd[3967944]: Disconnected from invalid user ubuntu 93.254.246.194 port 48840 [preauth]
Oct 15 00:00:24 ebpf-chaos sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: Received disconnect from 180.101.88.227 port 44397:11:  [preauth]
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: Disconnected from authenticating user root 180.101.88.227 port 44397 [preauth]
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: PAM 2 more authentication failures; logname= uid=0 euid=0 tty=ssh ruser= rhost=180.101.88.227 user=root
Oct 15 00:00:25 ebpf-chaos sshd[3967998]: Invalid user teamspeak from 185.218.20.10 port 33436
" language="text" meta=""><code>Oct 15 00:00:19 ebpf-chaos sshd[3967944]: Failed password for invalid user ubuntu from 93.254.246.194 port 48840 ssh2
Oct 15 00:00:20 ebpf-chaos sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2
Oct 15 00:00:21 ebpf-chaos sshd[3967944]: Received disconnect from 93.254.246.194 port 48840:11: Bye Bye [preauth]
Oct 15 00:00:21 ebpf-chaos sshd[3967944]: Disconnected from invalid user ubuntu 93.254.246.194 port 48840 [preauth]
Oct 15 00:00:24 ebpf-chaos sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: Received disconnect from 180.101.88.227 port 44397:11:  [preauth]
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: Disconnected from authenticating user root 180.101.88.227 port 44397 [preauth]
Oct 15 00:00:25 ebpf-chaos sshd[3967916]: PAM 2 more authentication failures; logname= uid=0 euid=0 tty=ssh ruser= rhost=180.101.88.227 user=root
Oct 15 00:00:25 ebpf-chaos sshd[3967998]: Invalid user teamspeak from 185.218.20.10 port 33436
</code></pre><p><strong>Dica de prevenção de intrusão:</strong> configure um firewall e use o <a href="https://en.wikipedia.org/wiki/Fail2ban" rel="">fail2ban</a> para bloquear tentativas de login inválidas.</p><p>O próximo exercício é estender a lógica para entender as partes de texto livre da mensagem de log — por exemplo, <code>Failed password for invalid user ubuntu from 93.254.246.194 port 48840 ssh2</code>. A tarefa é armazenar esses dados em um dicionário opcional, com pares de chave-valor.</p><p>Crie uma nova função que recebe como entrada os resultados já processados das linhas de log e faz o parsing especificamente do último item da lista, em cada linha.</p><ol><li>Conte o número de mensagens <code>Failed password</code> e <code>Invalid user</code>.</li><li>Retorne os resultados com a contagem, o arquivo de log e o padrão usado.</li></ol><p><img alt="Code suggestions para um parser de mensagens de log que conta as falhas do auth.log" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398605/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_parse_log_message_auth_log.png" title="Code suggestions para um parser de mensagens de log que conta as falhas do auth.log" /></p><p>Uma sugestão funcional pode ser este código:</p><pre className="language-python shiki shiki-themes github-light" code="# Create a function that parses a log file message from the last extracted_columns entry
# Input: Parsed log lines results list
# Loop over all log lines in the list, and extract the last list item as message
# Count failure strings in the message: Failed password, Invalid user
# Return the results if failure count greater 0: log_file, count, failure string
def parse_log_file_message(results):
    failure_results = []

    # Iterate over the log lines
    for result in results:
        # Extract the message from the last list item
        message = result[&#39;extracted_columns&#39;][-1]

        # Count the number of failure strings in the message
        failure_count = message.count(&#39;Failed password&#39;) + message.count(&#39;Invalid user&#39;)

        # If the failure count is greater than 0, add the results to the list
        if failure_count &gt; 0:
            failure_results.append({
                &#39;log_file&#39;: result[&#39;source_file&#39;],
                &#39;count&#39;: failure_count,
                &#39;failure_string&#39;: message
            })

    # Return the results
    return failure_results

# Parse all files and print results
for log_file in log_files:
    results = parse_log_file(log_file)
    failure_results = parse_log_file_message(results)
    print(failure_results)

" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Create a function that parses a log file message from the last extracted_columns entry
</span></span><span class="line" line="2"><span class="sAwPA"># Input: Parsed log lines results list
</span></span><span class="line" line="3"><span class="sAwPA"># Loop over all log lines in the list, and extract the last list item as message
</span></span><span class="line" line="4"><span class="sAwPA"># Count failure strings in the message: Failed password, Invalid user
</span></span><span class="line" line="5"><span class="sAwPA"># Return the results if failure count greater 0: log_file, count, failure string
</span></span><span class="line" line="6"><span class="sD7c4">def</span><span class="s7eDp"> parse_log_file_message</span><span class="sgsFI">(results):
</span></span><span class="line" line="7"><span class="sgsFI">    failure_results </span><span class="sD7c4">=</span><span class="sgsFI"> []
</span></span><span class="line" line="8"><span emptyLinePlaceholder>
</span></span><span class="line" line="9"><span class="sAwPA">    # Iterate over the log lines
</span></span><span class="line" line="10"><span class="sD7c4">    for</span><span class="sgsFI"> result </span><span class="sD7c4">in</span><span class="sgsFI"> results:
</span></span><span class="line" line="11"><span class="sAwPA">        # Extract the message from the last list item
</span></span><span class="line" line="12"><span class="sgsFI">        message </span><span class="sD7c4">=</span><span class="sgsFI"> result[</span><span class="sYBdl">&#39;extracted_columns&#39;</span><span class="sgsFI">][</span><span class="sD7c4">-</span><span class="sYu0t">1</span><span class="sgsFI">]
</span></span><span class="line" line="13"><span emptyLinePlaceholder>
</span></span><span class="line" line="14"><span class="sAwPA">        # Count the number of failure strings in the message
</span></span><span class="line" line="15"><span class="sgsFI">        failure_count </span><span class="sD7c4">=</span><span class="sgsFI"> message.count(</span><span class="sYBdl">&#39;Failed password&#39;</span><span class="sgsFI">) </span><span class="sD7c4">+</span><span class="sgsFI"> message.count(</span><span class="sYBdl">&#39;Invalid user&#39;</span><span class="sgsFI">)
</span></span><span class="line" line="16"><span emptyLinePlaceholder>
</span></span><span class="line" line="17"><span class="sAwPA">        # If the failure count is greater than 0, add the results to the list
</span></span><span class="line" line="18"><span class="sD7c4">        if</span><span class="sgsFI"> failure_count </span><span class="sD7c4">&gt;</span><span class="sYu0t"> 0</span><span class="sgsFI">:
</span></span><span class="line" line="19"><span class="sgsFI">            failure_results.append({
</span></span><span class="line" line="20"><span class="sYBdl">                &#39;log_file&#39;</span><span class="sgsFI">: result[</span><span class="sYBdl">&#39;source_file&#39;</span><span class="sgsFI">],
</span></span><span class="line" line="21"><span class="sYBdl">                &#39;count&#39;</span><span class="sgsFI">: failure_count,
</span></span><span class="line" line="22"><span class="sYBdl">                &#39;failure_string&#39;</span><span class="sgsFI">: message
</span></span><span class="line" line="23"><span class="sgsFI">            })
</span></span><span class="line" line="24"><span emptyLinePlaceholder>
</span></span><span class="line" line="25"><span class="sAwPA">    # Return the results
</span></span><span class="line" line="26"><span class="sD7c4">    return</span><span class="sgsFI"> failure_results
</span></span><span class="line" line="27"><span emptyLinePlaceholder>
</span></span><span class="line" line="28"><span class="sAwPA"># Parse all files and print results
</span></span><span class="line" line="29"><span class="sD7c4">for</span><span class="sgsFI"> log_file </span><span class="sD7c4">in</span><span class="sgsFI"> log_files:
</span></span><span class="line" line="30"><span class="sgsFI">    results </span><span class="sD7c4">=</span><span class="sgsFI"> parse_log_file(log_file)
</span></span><span class="line" line="31"><span class="sgsFI">    failure_results </span><span class="sD7c4">=</span><span class="sgsFI"> parse_log_file_message(results)
</span></span><span class="line" line="32"><span class="sYu0t">    print</span><span class="sgsFI">(failure_results)
</span></span></code></pre><p>O algoritmo segue as implementações anteriores: primeiro, cria um array de resultados para armazenar os dados que derem match. Depois, itera sobre as <code>log_lines</code> já processadas na lista. Cada linha de log contém a chave <code>extracted_columns</code>, que guarda a string de mensagem livre no final. O próximo passo é chamar a função <code>count()</code> do objeto string, para contar quantas vezes uma determinada sequência de caracteres aparece em uma string. Os números retornados são somados na variável <code>failure_count</code>. Se o valor for maior que zero, o resultado é adicionado à lista de resultados, incluindo os pares chave-valor <code>log_file</code>, <code>count</code> e <code>failure_string</code>. Depois de retornar os resultados da mensagem de log já processada, o loop percorre todos os arquivos de log, faz o parsing de cada um e imprime os resultados novamente.</p><p>Execute o script para inspecionar os matches detectados. Vale notar que a estrutura de dados ainda pode ser otimizada em passos futuros de aprendizado.</p><pre className="language-shell shiki shiki-themes github-light" code="python3 log_reader.py

[{&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3967944]: Failed password for invalid user ubuntu from 93.254.246.194 port 48840 ssh2&#39;}, {&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2&#39;}, {&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2&#39;}, {&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3967998]: Invalid user teamspeak from 185.218.20.10 port 33436&#39;}, {&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3967998]: Failed password for invalid user teamspeak from 185.218.20.10 port 33436 ssh2&#39;}, {&#39;log_file&#39;: &#39;log-data/var/log/auth.log&#39;, &#39;count&#39;: 1, &#39;failure_string&#39;: &#39;sshd[3968077]: Invalid user mcserver from 218.211.33.146 port 50950&#39;}]
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">python3</span><span class="sYBdl"> log_reader.py
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="sgsFI">[{</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3967944]: Failed password for invalid user ubuntu from 93.254.246.194 port 48840 ssh2&#39;</span><span class="sgsFI">}, {</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2&#39;</span><span class="sgsFI">}, {</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3967916]: Failed password for root from 180.101.88.227 port 44397 ssh2&#39;</span><span class="sgsFI">}, {</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3967998]: Invalid user teamspeak from 185.218.20.10 port 33436&#39;</span><span class="sgsFI">}, {</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3967998]: Failed password for invalid user teamspeak from 185.218.20.10 port 33436 ssh2&#39;</span><span class="sgsFI">}, {</span><span class="sYBdl">&#39;log_file&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;log-data/var/log/auth.log&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;count&#39;</span><span class="sgsFI">: 1, </span><span class="sYBdl">&#39;failure_string&#39;</span><span class="sgsFI">: </span><span class="sYBdl">&#39;sshd[3968077]: Invalid user mcserver from 218.211.33.146 port 50950&#39;</span><span class="sgsFI">}]
</span></span></code></pre><h3 id="fazendo-parsing-de-mais-tipos-logging-estruturado">Fazendo parsing de mais tipos: logging estruturado</h3><p>Desenvolvedores de aplicações podem usar o formato de logging estruturado para ajudar os parsers automatizados a extrair os pares chave-valor. O Prometheus fornece essa informação na seguinte estrutura, dentro do syslog:</p><pre className="language-text" code="Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.425Z caller=compact.go:519 level=info component=tsdb m
sg=&quot;write block&quot; mint=1697558404661 maxt=1697565600000 ulid=01HCZG4ZX51GTH8H7PVBYDF4N6 duration=148.675854ms
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.464Z caller=head.go:1213 level=info component=tsdb msg
=&quot;Head GC completed&quot; caller=truncateMemory duration=6.845245ms
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.467Z caller=checkpoint.go:100 level=info component=tsd
b msg=&quot;Creating checkpoint&quot; from_segment=2308 to_segment=2309 mint=1697565600000
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.517Z caller=head.go:1185 level=info component=tsdb msg
=&quot;WAL checkpoint complete&quot; first=2308 last=2309 duration=50.052621ms
" language="text" meta=""><code>Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.425Z caller=compact.go:519 level=info component=tsdb m
sg=&quot;write block&quot; mint=1697558404661 maxt=1697565600000 ulid=01HCZG4ZX51GTH8H7PVBYDF4N6 duration=148.675854ms
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.464Z caller=head.go:1213 level=info component=tsdb msg
=&quot;Head GC completed&quot; caller=truncateMemory duration=6.845245ms
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.467Z caller=checkpoint.go:100 level=info component=tsd
b msg=&quot;Creating checkpoint&quot; from_segment=2308 to_segment=2309 mint=1697565600000
Oct 17 19:00:10 ebpf-chaos prometheus[594]: ts=2023-10-17T19:00:10.517Z caller=head.go:1185 level=info component=tsdb msg
=&quot;WAL checkpoint complete&quot; first=2308 last=2309 duration=50.052621ms
</code></pre><p>Esse formato é mais fácil de processar por scripts porque a parte da mensagem pode ser dividida por espaços em branco e pelo caractere de atribuição <code>=</code>. Aliás, é preciso entender que strings que contêm espaços em branco sempre vêm entre aspas. A desvantagem é que nem todas as bibliotecas de todas as linguagens de programação oferecem bibliotecas de logging estruturado prontas para uso, o que dificulta a adoção desse formato pelos desenvolvedores.</p><p>Pratique seguindo o exemplo anterior para fazer o parsing do formato <code>auth.log</code> com informações adicionais. Diga ao Code Suggestions que você espera um formato de logging estruturado com pares chave-valor, e qual estrutura de dados de retorno seria ideal:</p><pre className="language-python shiki shiki-themes github-light" code="# Create a function that parses a log file message from the last extracted_columns entry
# Input: Parsed log lines results list
# Loop over all log lines in the list, and extract the last list item as message
# Parse structured logging key-value pairs into a dictionary
# Return results: log_file, dictionary
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Create a function that parses a log file message from the last extracted_columns entry
</span></span><span class="line" line="2"><span class="sAwPA"># Input: Parsed log lines results list
</span></span><span class="line" line="3"><span class="sAwPA"># Loop over all log lines in the list, and extract the last list item as message
</span></span><span class="line" line="4"><span class="sAwPA"># Parse structured logging key-value pairs into a dictionary
</span></span><span class="line" line="5"><span class="sAwPA"># Return results: log_file, dictionary
</span></span></code></pre><p><img alt="Code suggestions para fazer parsing do formato de logging estruturado na parte de mensagem do arquivo de log" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398606/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_propose_structured_logging_message_parser.png" title="Code suggestions para fazer parsing do formato de logging estruturado na parte de mensagem do arquivo de log" /></p><h3 id="imprimindo-e-formatando-os-resultados">Imprimindo e formatando os resultados</h3><p>Muitos dos exemplos usaram a instrução <code>print()</code> para exibir o conteúdo no terminal. Os objetos Python da biblioteca padrão são compatíveis com representação em texto, e para alguns tipos isso faz mais sentido (strings, números), enquanto para outros não é possível fornecer muitos detalhes (funções, etc.).</p><p>Você também pode fazer o pretty-print de praticamente qualquer estrutura de dados (listas, sets, dicionários) em Python. A biblioteca JSON consegue formatar estruturas de dados de forma legível, usando um recuo de espaços definido para desenhar a estrutura JSON no terminal. Repare que usamos a instrução <code>import</code> aqui para trazer bibliotecas para o escopo atual e acessar seus métodos — por exemplo, <code>json.dumps</code>.</p><pre className="language-python shiki shiki-themes github-light" code="import json
print(json.dumps(structured_results, indent=4))
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sD7c4">import</span><span class="sgsFI"> json
</span></span><span class="line" line="2"><span class="sYu0t">print</span><span class="sgsFI">(json.dumps(structured_results, </span><span class="sqxcx">indent</span><span class="sD7c4">=</span><span class="sYu0t">4</span><span class="sgsFI">))
</span></span></code></pre><p><img alt="Parsing de arquivos de log em objetos estruturados, exemplo de resultado após seguir os exercícios" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398608/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_terminal_parsing_logs_and_pretty_print_results.png" title="Parsing de arquivos de log em objetos estruturados, exemplo de resultado após seguir os exercícios" /></p><p>Pratique modificando o código-fonte existente e substitua os trechos de código onde fizer sentido. Outra opção é criar uma nova função que implemente o pretty printing.</p><pre className="language-python shiki shiki-themes github-light" code="# Create a pretty print function with indent 4
" language="python" meta="" style=""><code><span class="line" line="1"><span class="sAwPA"># Create a pretty print function with indent 4
</span></span></code></pre><p><img alt="Code suggestions para uma função de pretty-print" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398606/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/vs_code_code_suggestions_pretty_print.png" title="Code suggestions para uma função de pretty-print" /></p><p>Essa ideia funciona de forma parecida com a criação das suas próprias funções de logger... mas por aqui vamos parar de aprender por um momento e fazer uma pausa. Antes de encerrar o primeiro post desta série de aprendizado, vamos garantir que o CI/CD e as dependências estejam configurados corretamente para os próximos exercícios e a prática assíncrona.</p><h2 id="gerenciamento-de-dependências-e-verificação-contínua">Gerenciamento de dependências e verificação contínua</h2><h3 id="pip-e-pyenv-trazendo-estrutura-para-o-python">Pip e pyenv: trazendo estrutura para o Python</h3><p>As dependências podem ser gerenciadas no <a href="https://pip.pypa.io/en/stable/reference/requirements-file-format/" rel="">arquivo <code>requirements.txt</code></a>, incluindo dependências de versão opcionais. Usar o arquivo <code>requirements.txt</code> também tem a vantagem de ser a fonte única de verdade tanto para os ambientes de desenvolvimento local quanto para a execução de builds contínuos no GitLab CI/CD. Ambos podem usar o mesmo comando de instalação:</p><pre className="language-shell shiki shiki-themes github-light" code="pip install -r requirements.txt
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">pip</span><span class="sYBdl"> install</span><span class="sYu0t"> -r</span><span class="sYBdl"> requirements.txt
</span></span></code></pre><p>Algumas distribuições Linux não instalam o gerenciador de pacotes pip por padrão — no Ubuntu/Debian, por exemplo, é preciso instalar o pacote <code>python3-pip</code>.</p><p>Você pode gerenciar diferentes ambientes virtuais usando o <a href="https://docs.python.org/3/library/venv.html" rel="">venv</a>. Esse fluxo de trabalho é útil para instalar as dependências do Python dentro do ambiente virtual, em vez de instalá-las globalmente no path do sistema operacional, o que pode gerar problemas em atualizações futuras.</p><pre className="language-shell shiki shiki-themes github-light" code="pip install virtualenv
virtualenv venv
source venv/bin/activate
" language="shell" meta="" style=""><code><span class="line" line="1"><span class="s7eDp">pip</span><span class="sYBdl"> install</span><span class="sYBdl"> virtualenv
</span></span><span class="line" line="2"><span class="s7eDp">virtualenv</span><span class="sYBdl"> venv
</span></span><span class="line" line="3"><span class="sYu0t">source</span><span class="sYBdl"> venv/bin/activate
</span></span></code></pre><h3 id="automação-configure-o-pipeline-de-cicd-para-python">Automação: configure o pipeline de CI/CD para Python</h3><p>O <a href="https://docs.gitlab.com/ci/" rel="">pipeline de CI/CD</a> deve continuamente fazer lint, testar e compilar o código. Você pode reproduzir as mesmas etapas do desenvolvimento local e adicionar testes para mais ambientes e versões:</p><ol><li>Faça lint do código-fonte e verifique erros de formatação. O exemplo usa o <a href="https://pypi.org/project/pyflakes/" rel="">Pyflakes</a>, um linter maduro, e o <a href="https://docs.astral.sh/ruff/" rel="">Ruff</a>, um linter rápido escrito em Rust.</li><li>Faça cache das dependências instaladas pelo gerenciador de pacotes pip, seguindo a documentação de <a href="https://docs.gitlab.com/ci/caching/#cache-python-dependencies" rel="">cache do Python no GitLab CI/CD</a>. Isso economiza tempo e recursos nas execuções repetidas do pipeline de CI/CD.</li><li>Use builds em matriz paralela para testar diferentes versões do Python, com base nas imagens de container disponíveis no Docker Hub e suas tags.</li></ol><pre className="language-yaml shiki shiki-themes github-light" code="stages:
  - lint
  - test

default:
  image: python:latest
  cache:                      # Pip&#39;s cache doesn&#39;t store the python packages
    paths:                    # https://pip.pypa.io/en/stable/topics/caching/
      - .cache/pip
  before_script:
    - python -V               # Print out python version for debugging
    - pip install virtualenv
    - virtualenv venv
    - source venv/bin/activate

variables:  # Change pip&#39;s cache directory to be inside the project directory since we can only cache local items.
  PIP_CACHE_DIR: &quot;$CI_PROJECT_DIR/.cache/pip&quot;

# lint template
.lint-tmpl:
  script:
    - echo &quot;Linting Python version $VERSION&quot;
  parallel:
    matrix:
      - VERSION: [&#39;3.9&#39;, &#39;3.10&#39;, &#39;3.11&#39;, &#39;3.12&#39;]   # https://hub.docker.com/_/python

# Lint, using Pyflakes: https://pypi.org/project/pyflakes/
lint-pyflakes:
  extends: [.lint-tmpl]
  script:
    - pip install -r requirements.txt
    - find . -not -path &#39;./venv&#39; -type f -name &#39;*.py&#39; -exec sh -c &#39;pyflakes {}&#39; \;

# Lint, using Ruff (Rust): https://docs.astral.sh/ruff/
lint-ruff:
  extends: [.lint-tmpl]
  script:
    - pip install -r requirements.txt
    - ruff .

" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">stages</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="sYBdl">lint
</span></span><span class="line" line="3"><span class="sgsFI">  - </span><span class="sYBdl">test
</span></span><span class="line" line="4"><span emptyLinePlaceholder>
</span></span><span class="line" line="5"><span class="shJU0">default</span><span class="sgsFI">:
</span></span><span class="line" line="6"><span class="shJU0">  image</span><span class="sgsFI">: </span><span class="sYBdl">python:latest
</span></span><span class="line" line="7"><span class="shJU0">  cache</span><span class="sgsFI">:                      </span><span class="sAwPA"># Pip&#39;s cache doesn&#39;t store the python packages
</span></span><span class="line" line="8"><span class="shJU0">    paths</span><span class="sgsFI">:                    </span><span class="sAwPA"># https://pip.pypa.io/en/stable/topics/caching/
</span></span><span class="line" line="9"><span class="sgsFI">      - </span><span class="sYBdl">.cache/pip
</span></span><span class="line" line="10"><span class="shJU0">  before_script</span><span class="sgsFI">:
</span></span><span class="line" line="11"><span class="sgsFI">    - </span><span class="sYBdl">python -V</span><span class="sAwPA">               # Print out python version for debugging
</span></span><span class="line" line="12"><span class="sgsFI">    - </span><span class="sYBdl">pip install virtualenv
</span></span><span class="line" line="13"><span class="sgsFI">    - </span><span class="sYBdl">virtualenv venv
</span></span><span class="line" line="14"><span class="sgsFI">    - </span><span class="sYBdl">source venv/bin/activate
</span></span><span class="line" line="15"><span emptyLinePlaceholder>
</span></span><span class="line" line="16"><span class="shJU0">variables</span><span class="sgsFI">:  </span><span class="sAwPA"># Change pip&#39;s cache directory to be inside the project directory since we can only cache local items.
</span></span><span class="line" line="17"><span class="shJU0">  PIP_CACHE_DIR</span><span class="sgsFI">: </span><span class="sYBdl">&quot;$CI_PROJECT_DIR/.cache/pip&quot;
</span></span><span class="line" line="18"><span emptyLinePlaceholder>
</span></span><span class="line" line="19"><span class="sAwPA"># lint template
</span></span><span class="line" line="20"><span class="shJU0">.lint-tmpl</span><span class="sgsFI">:
</span></span><span class="line" line="21"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="22"><span class="sgsFI">    - </span><span class="sYBdl">echo &quot;Linting Python version $VERSION&quot;
</span></span><span class="line" line="23"><span class="shJU0">  parallel</span><span class="sgsFI">:
</span></span><span class="line" line="24"><span class="shJU0">    matrix</span><span class="sgsFI">:
</span></span><span class="line" line="25"><span class="sgsFI">      - </span><span class="shJU0">VERSION</span><span class="sgsFI">: [</span><span class="sYBdl">&#39;3.9&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;3.10&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;3.11&#39;</span><span class="sgsFI">, </span><span class="sYBdl">&#39;3.12&#39;</span><span class="sgsFI">]   </span><span class="sAwPA"># https://hub.docker.com/_/python
</span></span><span class="line" line="26"><span emptyLinePlaceholder>
</span></span><span class="line" line="27"><span class="sAwPA"># Lint, using Pyflakes: https://pypi.org/project/pyflakes/
</span></span><span class="line" line="28"><span class="shJU0">lint-pyflakes</span><span class="sgsFI">:
</span></span><span class="line" line="29"><span class="shJU0">  extends</span><span class="sgsFI">: [</span><span class="sYBdl">.lint-tmpl</span><span class="sgsFI">]
</span></span><span class="line" line="30"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="31"><span class="sgsFI">    - </span><span class="sYBdl">pip install -r requirements.txt
</span></span><span class="line" line="32"><span class="sgsFI">    - </span><span class="sYBdl">find . -not -path &#39;./venv&#39; -type f -name &#39;*.py&#39; -exec sh -c &#39;pyflakes {}&#39; \;
</span></span><span class="line" line="33"><span emptyLinePlaceholder>
</span></span><span class="line" line="34"><span class="sAwPA"># Lint, using Ruff (Rust): https://docs.astral.sh/ruff/
</span></span><span class="line" line="35"><span class="shJU0">lint-ruff</span><span class="sgsFI">:
</span></span><span class="line" line="36"><span class="shJU0">  extends</span><span class="sgsFI">: [</span><span class="sYBdl">.lint-tmpl</span><span class="sgsFI">]
</span></span><span class="line" line="37"><span class="shJU0">  script</span><span class="sgsFI">:
</span></span><span class="line" line="38"><span class="sgsFI">    - </span><span class="sYBdl">pip install -r requirements.txt
</span></span><span class="line" line="39"><span class="sgsFI">    - </span><span class="sYBdl">ruff .
</span></span></code></pre><p><img alt="Visualização do job de lint do Python no GitLab CI/CD, parte dos builds em matriz" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398599/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/gitlab_cicd_python_lint_job_log_view.png" title="Visualização do job de lint do Python no GitLab CI/CD, parte dos builds em matriz" /></p><h2 id="próximos-passos">Próximos passos</h2><p>Curiosidade: o GitLab Duo Code Suggestions também ajudou a escrever este post no VS Code, já que conhecia o contexto. Na captura de tela, eu só queria adicionar uma dica sobre o <a href="https://regex101.com/" rel="">regex101</a>, e o GitLab Duo já sabia o que eu ia escrever.</p><p><img alt="Escrevendo o post do blog do GitLab no VS Code com o apoio do GitLab Duo Code Suggestions" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782398600/blog/Content%20Images/learn-python-with-ai-code-suggestions-getting-started/gitlab_duo_code_suggestions_helping_write_the_learning_python_ai_blog_post.png" title="Escrevendo o post do blog do GitLab no VS Code com o apoio do GitLab Duo Code Suggestions" /></p><p>No próximo post, vamos explorar exemplos de aprendizado mais avançados, com filtragem prática de logs, operações em paralelo, como buscar logs em endpoints de API (por exemplo, logs de jobs de pipeline de CI/CD) e mais análise de dados e observabilidade. Até lá, seguem algumas recomendações para você praticar de forma assíncrona.</p><h3 id="exercícios-assíncronos-de-aprendizado">Exercícios assíncronos de aprendizado</h3><ul><li>Implemente a verificação que ainda falta para a variável <code>log_file_limit</code>.</li><li>Imprima um resumo dos resultados em Markdown, além do formato JSON.</li><li>Estenda o script para aceitar um filtro de busca como variável de ambiente. Imprima/conte apenas os resultados filtrados.</li><li>Estenda o script para aceitar um intervalo de datas. Isso pode exigir converter a coluna de data e hora em um objeto de tempo para comparar o intervalo.</li><li>Inspecione o log de um job de pipeline de CI/CD do GitLab e baixe o formato bruto. Estenda o parser de logs para reconhecer esse formato específico e imprimir um resumo.</li></ul><h3 id="compartilhe-seu-feedback">Compartilhe seu feedback</h3><p>Qual linguagem de programação você está aprendendo ou pensando em aprender? Abra um novo tópico no nosso fórum da <a href="/pt-br/community/">comunidade</a> ou no Discord e compartilhe sua experiência.</p><p>Se você usa o <a href="/pt-br/gitlab-duo-agent-platform/">GitLab Duo</a> Code Suggestions, compartilhe suas opiniões e feedback <a href="https://gitlab.com/gitlab-org/gitlab/-/issues/405152" rel="">neste issue de feedback</a>.</p><style>html pre.shiki code .s7eDp, html code.shiki .s7eDp{--shiki-default:#6F42C1}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}html pre.shiki code .sYu0t, html code.shiki .sYu0t{--shiki-default:#005CC5}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html pre.shiki code .surfw, html code.shiki .surfw{--shiki-default:#005CC5;--shiki-default-font-weight:bold}html pre.shiki code .sAwPA, html code.shiki .sAwPA{--shiki-default:#6A737D}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .sD7c4, html code.shiki .sD7c4{--shiki-default:#D73A49}html pre.shiki code .sqxcx, html code.shiki .sqxcx{--shiki-default:#E36209}html pre.shiki code .shJU0, html code.shiki .shJU0{--shiki-default:#22863A}</style>]]></content>
        <author>
            <name>Michael Friedrich</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/michael-friedrich/</uri>
        </author>
        <published>2023-11-09T00:00:00.000Z</published>
    </entry>
</feed>