Veröffentlicht am: 8. September 2026
16 Minuten Lesezeit
Eigene Modelle über Microsoft Foundry in GitLab Duo Self-Hosted einbinden
GitLab Duo Self-Hosted lässt sich mit GPT-, Claude-, Llama- und Mistral-Modellen aus Microsoft Foundry verbinden. Der Beitrag zeigt die Auswahl und die Einrichtung.
Bei vielen Organisationen lautet die eigentliche Frage zu KI-Coding-Tools nicht, ob sie nützen, sondern wohin der Code geht. Teams mit Vorgaben zu Datenhoheit, Datenstandort oder Regulierung müssen wissen, welches Netzwerk ihren Quellcode verarbeitet, bevor überhaupt eine Einführung infrage kommt. GitLab Duo Self-Hosted löst das. Wie das Konzept im Unternehmenskontext funktioniert, erklärt dieser Überblick zu GitLab Duo Self-Hosted und Datenschutz. Administratoren verbinden Funktionen von GitLab Duo mit Modellen auf selbst gewählter Infrastruktur und behalten dabei die Kontrolle über Hosting, Region, Netzwerkpfad und Zugangsdaten.
In diesem Tutorial verbinden wir GitLab Duo Self-Hosted mit Modellen, die in Microsoft Foundry gehostet werden. Foundry lässt sich am besten als universelle Serving-Plattform verstehen, nicht als reiner OpenAI-Endpunkt: Der Katalog reicht von OpenAI GPT über Anthropic Claude und Meta Llama bis zu Mistral, und die von GitLab unterstützten Modellfamilien überschneiden sich stark mit dem Foundry-Angebot.
Das ist relevant, weil sich in GitLab pro Funktion ein eigenes Modell zuweisen lässt. Möglich ist etwa eine Modellfamilie für agentische Aufgaben, ein codespezialisiertes Modell für Code Suggestions und ein kleineres Modell dort, wo das Anfragevolumen dominiert, bereitgestellt und abgerechnet über ein einziges Azure-Abonnement.
Die Einrichtungsschritte sind unabhängig von der Modellfamilie identisch. Verändert werden nur das bereitgestellte Modell, der referenzierte Deployment-Name und die in GitLab ausgewählte Model family.
Der Katalog von Microsoft entwickelt sich schnell weiter und umfasst laufend Modelle, die neuer sind als die von GitLab geführte Support-Matrix. Die Verfügbarkeit im Katalog allein begründet keine Unterstützung durch GitLab Duo, deshalb lohnt vor jeder Modellwahl ein Blick in beide Dokumentationen.
Warum GitLab Duo Self-Hosted?
GitLab Duo Self-Hosted verbindet GitLab Duo mit Modellen, die On-Premises oder über einen unterstützten Cloud-Anbieter bereitgestellt werden. Microsoft Foundry bietet sich an, wenn eine Organisation bereits in Azure arbeitet und Deployments, Zugriff, Netzwerk und Verbrauch dort zentral verwalten möchte.
Die wichtigsten Vorteile:
- Wahl der Bereitstellung. Azure-Region und Deployment-Typ lassen sich passend zu Verfügbarkeits- und Datenstandort-Anforderungen wählen.
- Mehrere Modellfamilien, eine Plattform. GPT-, Claude-, Llama- oder Mistral-Modelle lassen sich nebeneinander bereitstellen, statt mit jedem Anbieter einzeln einen Vertrag zu schließen.
- Konfiguration auf Funktionsebene. Modelle lassen sich einzelnen GitLab-Duo-Funktionen zuweisen, statt ein Modell global festzulegen, je nach Workload auch familienübergreifend gemischt. Wer Self-Hosted mit eigenen Modellen und der Agent Platform kombinieren möchte, findet weitere Hintergründe im Beitrag Agentic AI: Enterprise-Kontrolle mit Self-Hosted Duo Agent Platform und BYOM.
- Azure-Integration. Microsoft-Entra-Identität, rollenbasierte Zugriffskontrolle, Netzwerkisolierung und Azure Policy lassen sich auf Foundry-Ressourcen anwenden.
- Zentraler Betrieb. Modellnutzung und Kosten lassen sich zusammen mit den übrigen Azure-Diensten überwachen.
Architekturüberblick
Die Lösung GitLab Duo Self-Hosted besteht aus drei Kernkomponenten:
- Die Self-Managed-GitLab-Instanz, d.h. die vorhandene GitLab-Instanz, über die Nutzer(innen) mit den Funktionen von GitLab Duo arbeiten.
- Das AI Gateway, d.h. ein Dienst, der Anfragen zwischen GitLab und dem gewählten LLM-Backend weiterleitet.
- Die Modell-Endpunkte, d.h. ein oder mehrere über Microsoft Foundry bereitgestellte Modell-Deployments.
Ein einziges AI Gateway bedient alle konfigurierten Modelle. GitLab entscheidet anhand der anfragenden Funktion, welches Deployment aufgerufen wird:
flowchart LR
    subgraph self["Your infrastructure"]
        GL["Self-Managed<br/>GitLab"]
        GW["AI Gateway<br/>(port 5052)"]
    end

    subgraph azure["Your Azure tenant"]
        subgraph foundry["Microsoft Foundry"]
            M1["duo-chat<br/>Agentic Chat, Agent Platform"]
            M2["duo-code-gen<br/>Code generation"]
            M3["duo-code-completion<br/>Code completion"]
        end
    end

    GL -- HTTPS --> GW
    GW --> M1
    GW --> M2
    GW --> M3
Hinweis: Wer On-Premises oder mit einem anderen Cloud-Anbieter arbeitet, kann eine andere Serving-Plattform nutzen.
Was das Netzwerk verlässt
Genau diese Bereitstellungsform macht GitLab Duo für Teams mit Vorgaben zur Datenhoheit praktikabel, deshalb ist ein genauer Blick darauf sinnvoll, wohin Daten fließen.
Laut GitLab-Dokumentation verlassen bei einer vollständig selbst gehosteten Konfiguration die Inferenzdaten (Code-Eingaben, Modell-Prompts und Modellantworten) das eigene Netzwerk nicht. Anfragen laufen von der GitLab-Instanz über das AI Gateway zum Foundry-Deployment, vollständig innerhalb selbst kontrollierter Infrastruktur. GitLab erfasst auch nicht, welches Modell oder welcher Modellanbieter genutzt wird.
Was bei einer Online-Lizenz das Netzwerk verlässt, sind Abrechnungsmetadaten: eine Instanz-ID, eine de-identifizierte Nutzer-ID, eine Aufrufzahl und ein Zeitstempel. Bei einer Offline-Lizenz besteht überhaupt keine Verbindung zu den Abrechnungskomponenten von GitLab.
Zwei Einschränkungen gelten dabei:
- Gilt nur für Funktionen mit eigenen Modellen. Wird eine Funktion auf ein von GitLab verwaltetes Modell geroutet, gehen deren Anfragen stattdessen an das von GitLab gehostete AI Gateway. Das Deployment ist dann hybrid, nicht vollständig selbst gehostet.
- Datenstandort hängt vom Deployment-Typ ab. Ruhende Daten bleiben in der gewählten Azure-Geografie, doch wo die Inferenz tatsächlich läuft, hängt davon ab, ob ein globales, ein Data-Zone- oder ein regionales Deployment gewählt wird. Bei rechtlichen Standortanforderungen ist genau diese Einstellung entscheidend.
Wo sich GitLab-Unterstützung und der Foundry-Katalog überschneiden
Die Modellwahl muss zwei unabhängige Bedingungen erfüllen: GitLab muss das Modell unterstützen, und Foundry muss es anbieten. Das eine folgt nicht aus dem anderen.
GitLab bewertet jedes unterstützte Modell anhand von vier Funktionsbereichen: Code Completion, Code Generation, GitLab Duo Agentic Chat und GitLab Duo Agent Platform. Folgende Familien finden sich sowohl in GitLabs Support-Tabelle als auch im Foundry-Katalog:
| Familie | Wie Foundry sie anbietet | Was zu beachten ist |
|---|---|---|
| GPT | Direkt von Azure verkauft | Größte Überschneidung mit GitLabs Tabelle, einfachster Weg. Umfasst universelle, code-optimierte und kleinere, latenzarme Varianten |
| Claude | Von Partnern, über den Azure Marketplace | Starke Bewertungen für agentische Aufgaben, zusätzliche Marketplace-Voraussetzungen und engere Regionsabdeckung |
| Llama | Von Azure und von Partnern verkauft | Bewertungen schwanken stark je nach Modellgröße und Funktion |
| Mistral | Von Partnern | Enthält Codestral, ein codespezialisiertes Modell |
Konkrete Versionsnummern ändern sich auf beiden Seiten schnell, deshalb nennt dieser Beitrag bewusst kein "bestes" Modell. Die Auswahl folgt stattdessen diesen Regeln:
- Einfachster Weg. Dafür genügt ein aktuelles universelles GPT-Modell, das in allen vier Bereichen mit voller Funktionalität bewertet ist.
- Bewertungen gelten pro Funktion, nicht pro Familie. Ein Modell mit exzellenter Bewertung für GitLab Duo Agentic Chat kann für Code Completion nur als eingeschränkt gelten. Jede geplante Funktion braucht einen eigenen Blick, statt eine Familie pauschal als stark anzunehmen.
- Neuer heißt nicht automatisch unterstützt. Foundry veröffentlicht Modelle, bevor sie in GitLabs Matrix erscheinen, und führt zudem Familien wie Grok, DeepSeek und Phi, die auf GitLabs Support-Liste fehlen. Solche Modelle eignen sich erst, sobald GitLab sie aufnimmt, oder lassen sich über GitLabs Beta für kompatible Modelle einbinden, die jedes über einen OpenAI-kompatiblen Endpunkt bereitgestellte Modell akzeptiert.
- Ältere Modelle aus der GPT-4-Ära stehen zwar weiter in GitLabs Tabelle, sind für ein neues Deployment aber kein guter Ausgangspunkt.
Vor jeder Festlegung empfiehlt sich ein Blick auf die aktuellen Bewertungen auf GitLabs Seite zu den unterstützten Modellen. Jedes in diesem Beitrag genannte Modell dient als Beispiel, nicht als Empfehlung.
Voraussetzungen
Vor dem Start wird Folgendes benötigt:
- Eine Self-Managed-Instanz von GitLab Premium oder Ultimate. GitLab Duo Self-Hosted ist seit GitLab 17.9 allgemein verfügbar, einzelne Funktionen haben jedoch eigene Mindestversionen, und GitLab Duo Agent Platform Self-Hosted setzt eine deutlich neuere Version voraus. Die Tabelle zu Funktionsversionen zeigt die Anforderungen für die geplanten Funktionen, für aktuelle Modellunterstützung empfiehlt sich ohnehin eine neuere Version.
- Das passende GitLab-Duo-Add-on für das jeweilige Deployment.
- Administratorzugriff auf GitLab.
- Ein Azure-Abonnement mit Zugriff auf Microsoft Foundry.
- Kontingent für jedes geplante Modell, in einer unterstützten Azure-Region und einem unterstützten Deployment-Typ. Die Regionsverfügbarkeit für von Azure verkaufte Modelle oder für Partnermodelle lässt sich vorab prüfen.
- Für Partnermodelle wie Claude oder Mistral: ein für Marketplace-Käufe berechtigtes Azure-Abonnement mit den nötigen Marketplace-Berechtigungen. Studenten-, kostenlose Test- und reine Guthaben-Abonnements werden nicht unterstützt.
- Ein lokal installiertes AI Gateway gemäß der GitLab-Installationsdokumentation.
Hinweis: Neu bei GitLab? Eine kostenlose Testversion von GitLab Ultimate steht zur Verfügung.
Umsetzungsschritte
1. Ein oder mehrere Modelle in Microsoft Foundry bereitstellen
Im Foundry-Portal das gewünschte Projekt auswählen und die ausgewählten Modelle aus dem Katalog bereitstellen. Die Modellverfügbarkeit variiert nach Region, Cloud und Deployment-Typ. Manche Abonnements benötigen zudem eine genehmigte Kontingenterhöhung.
Vor der Bereitstellung sollte geprüft werden, ob das Modell in der vorgesehenen Region und dem vorgesehenen Deployment-Typ verfügbar ist. Microsoft veröffentlicht das in Region availability for Foundry Models sold by Azure, mit eigenen Reitern für Standard, Provisioned und Batch. Die Abdeckung ist uneinheitlich: Ein Modell kann als Global Standard breit verfügbar sein und gleichzeitig als Regional Provisioned Managed nur in wenigen Regionen angeboten werden.
Partnermodelle sind stärker eingeschränkt als Azure-OpenAI-Modelle. Claude etwa ist auf wenige Regionen konzentriert, und die Bereitstellung setzt die Zustimmung zu den Marketplace-Bedingungen voraus. Vor der Festlegung auf eine Familie sollten Region und Abonnement-Berechtigung geprüft werden.
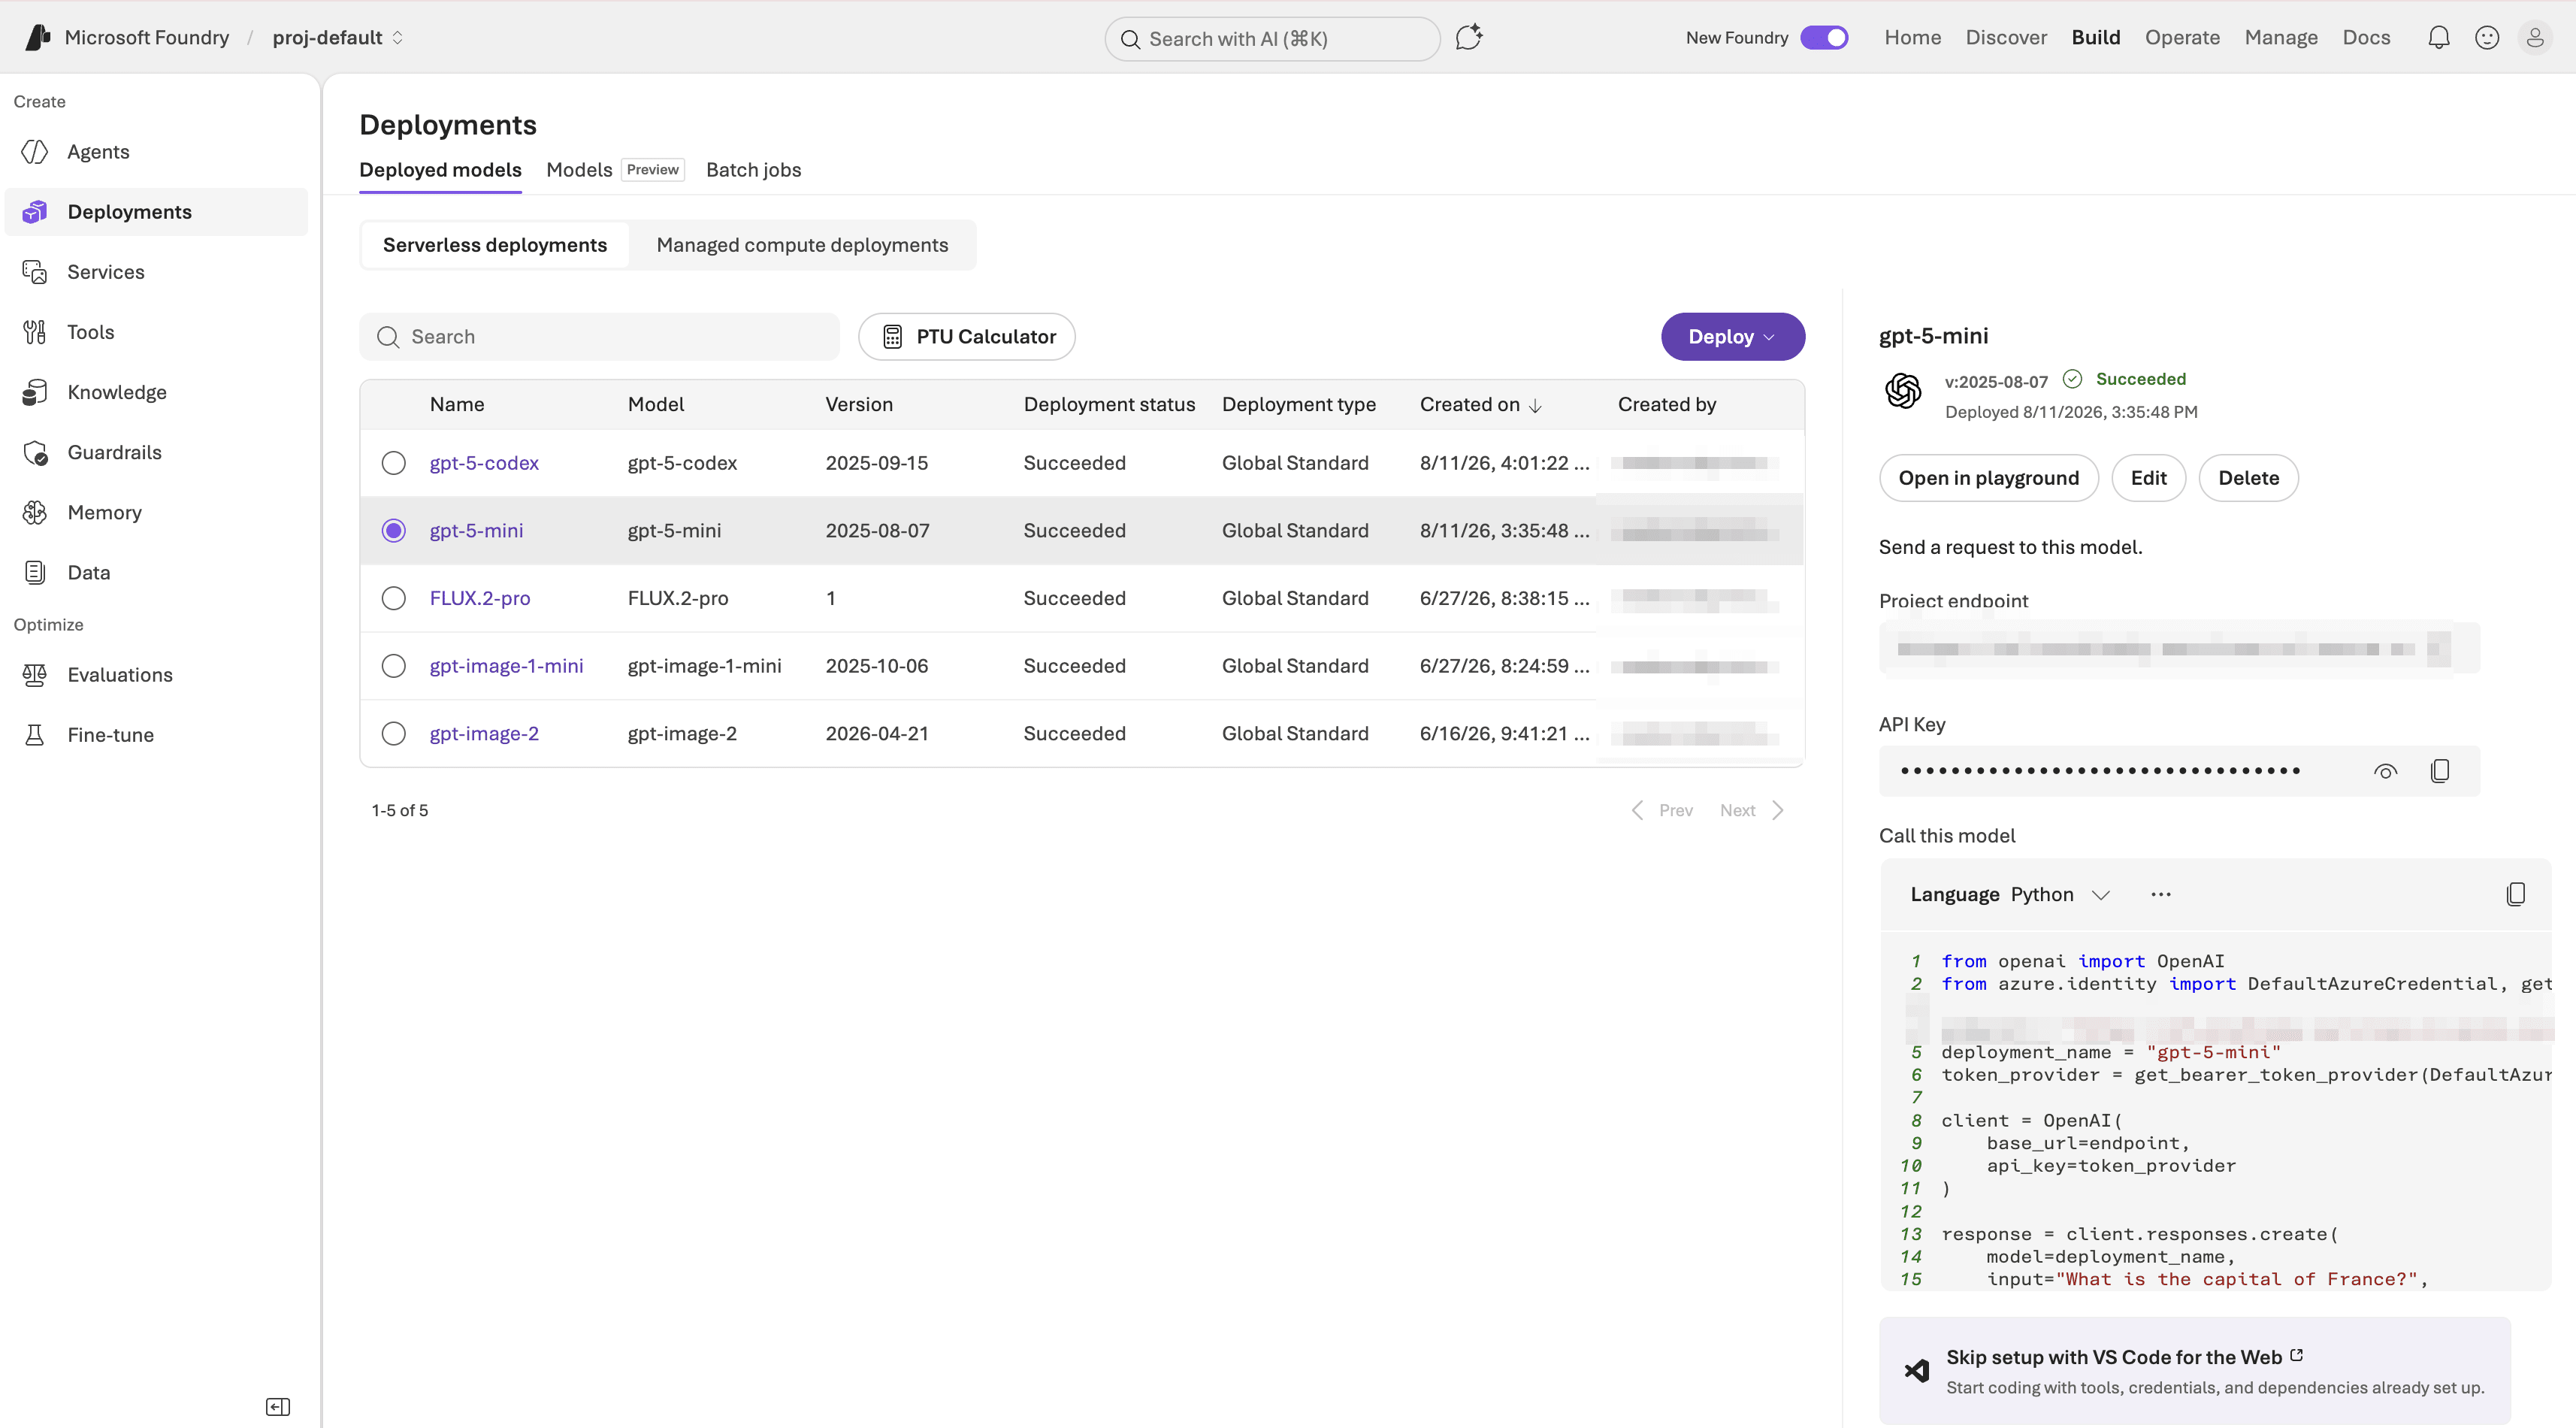 Microsoft Foundry Modelle
Jedes Deployment braucht einen später nachvollziehbaren Namen. GitLab verweist auf den Deployment-Namen, nicht auf den Katalognamen des Modells, deshalb lässt sich ein vager Name später kaum noch prüfen.
Eine Benennung nach Rolle statt nach Modellversion, etwa duo-chat oder duo-code-completion, bringt einen praktischen Vorteil: Bei einem Upgrade auf ein neueres Modell genügt es, das Deployment darauf zeigen zu lassen, ohne die Modellkennung in GitLab zu ändern. Eine Benennung nach Version, etwa duo-gpt-5-2, ist expliziter, erfordert aber bei jedem Modellwechsel eine erneute Konfiguration in GitLab.
Am Anfang genügt ein einzelnes Modell. Die Erweiterung folgt, sobald es durchgängig funktioniert.
Nach der Bereitstellung sind folgende Werte je Deployment festzuhalten:
- Die Endpunkt-URL
- Der Deployment-Name
- Ein API-Schlüssel mit Zugriff auf das Deployment
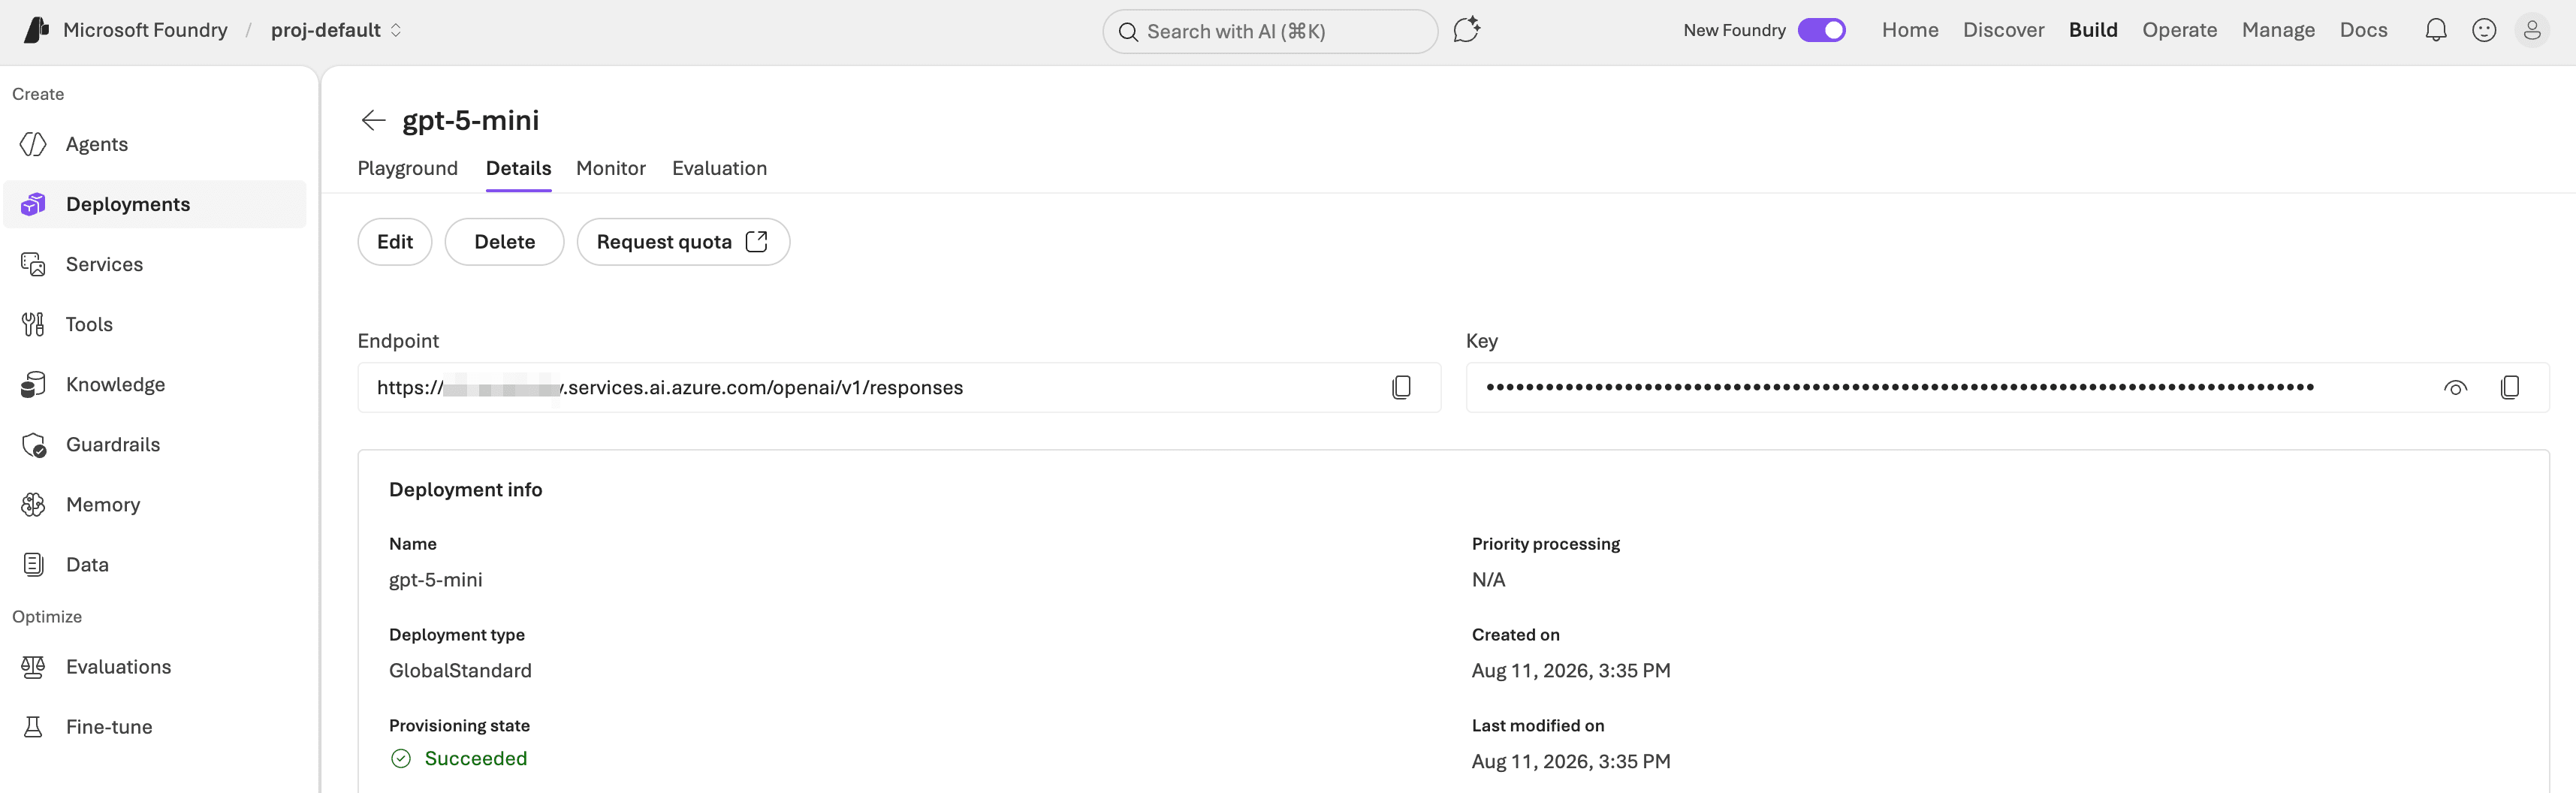 Microsoft Foundry: Modell gpt-5-mini
API-Schlüssel gehören in einen von der Organisation freigegebenen Secret-Management-Prozess, nicht in ein Repository.
2. Das AI Gateway installieren
Das AI Gateway leitet Anfragen zwischen GitLab und dem ausgewählten Modell-Endpunkt weiter. Die Installation erfolgt mit Docker oder dem Helm-Chart gemäß der aktuellen AI-Gateway-Installationsanleitung.
Ein alter Image-Tag oder ein API-Versionsbeispiel aus einem anderen Tutorial sollte nicht einfach übernommen werden. AI Gateway und GitLab-Version müssen zueinander passen. Das aktuelle Image und die nötigen Einstellungen liefert GitLabs Installationsanleitung. Foundry-Endpunkt und API-Schlüssel werden erst beim Hinzufügen jedes Modells in Schritt 4 eingetragen. Im Beispiel-Docker-Befehl sind sie nicht nötig.
Ein Gateway bedient alle konfigurierten Modelle. Ein separates Gateway je Deployment oder Modellfamilie ist nicht nötig.
3. GitLab für den Zugriff auf das AI Gateway konfigurieren
Sobald das AI Gateway läuft, wird die GitLab-Instanz dafür konfiguriert:
- In der linken Seitenleiste unten Admin auswählen.
- GitLab Duo auswählen.
- Im Bereich GitLab Duo Change configuration auswählen.
- Unter Local AI Gateway URL die URL und den Port des AI Gateways eintragen (z. B.
https://ai-gateway.example.com:5052). - Save changes auswählen.
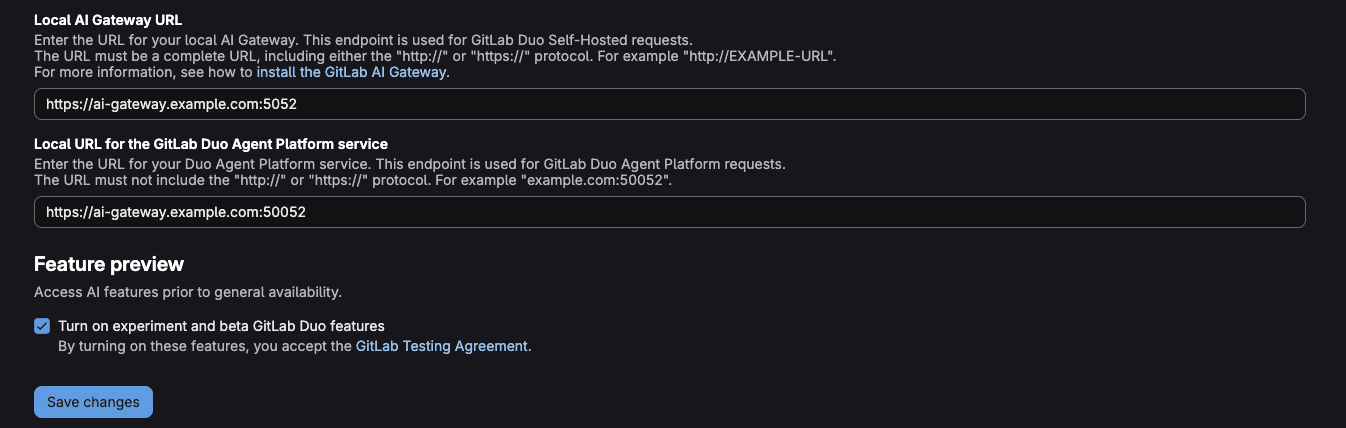 GitLab Duo: AI-Gateway-Konfiguration
Für Produktions-Deployments empfehlen sich TLS und ein eingeschränkter Netzwerkzugriff auf das Gateway. Nutzt das Gateway eine private IP-Adresse oder einen internen Hostnamen, gehört der jeweilige Wert auf GitLabs Allowlist für ausgehende Anfragen.
4. Jedes Deployment in GitLab hinzufügen
Dieser Ablauf wiederholt sich für jedes Foundry-Deployment, das GitLab nutzen soll:
- In der oberen rechten Ecke Admin auswählen.
- In der linken Seitenleiste GitLab Duo auswählen.
- Configure models for GitLab Duo auswählen.
- Add self-hosted model auswählen.
- Die Felder ausfüllen:
- Deployment name: einen eindeutig erkennbaren Namen eintragen, etwa
Agentic Chat on Microsoft Foundry. - Model family: die zum Modell passende Familie auswählen, etwa GPT oder Claude.
- Endpoint: die Endpunkt-URL aus dem Foundry-Deployment eintragen.
- API key: den API-Schlüssel für das Deployment eintragen.
- Model identifier:
azure/DEPLOYMENT-NAMEeintragen, mit dem exakten Deployment-Namen aus Foundry. Beispiel:azure/duo-chat.
- Deployment name: einen eindeutig erkennbaren Namen eintragen, etwa
- Add self-hosted model auswählen.
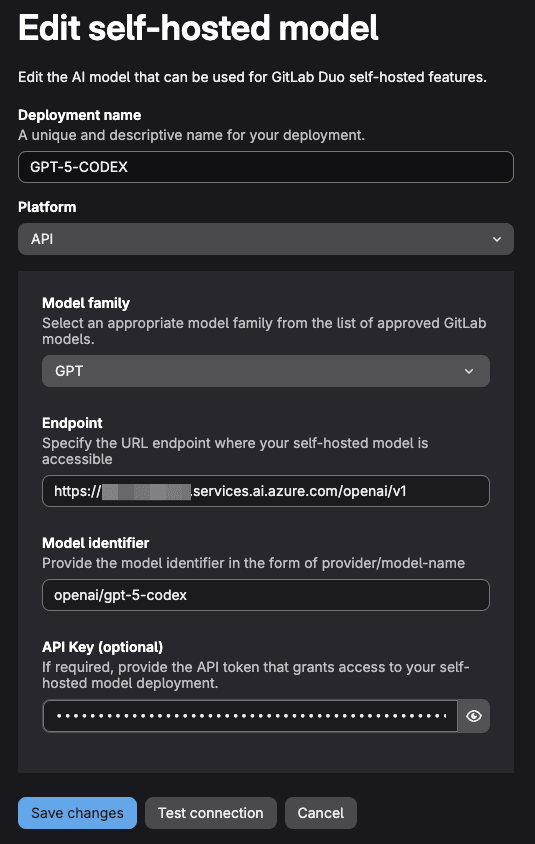 GitLab Duo: Konfiguration eines Self-Hosted-Modells
Das Präfix beschreibt, wie ein Modell bereitgestellt wird, nicht wer es entwickelt hat. Foundry kann auch Nicht-OpenAI-Modelle über den Azure-OpenAI-Endpunkt bereitstellen. Dann gilt weiterhin azure/. Wird ein Partnermodell über einen anderen Foundry-Endpunkt erreicht, sollte das richtige Präfix in GitLabs Konfigurationsdokumentation geprüft werden, statt es anzunehmen. Ein falsches Präfix erzeugt den weiter unten beschriebenen Fehler "Model not found".
5. Modelle den Funktionen von GitLab Duo zuweisen
- Unter Admin > GitLab Duo Configure models for GitLab Duo auswählen.
- Den Reiter AI-native features auswählen.
- Für jede auf Foundry zu routende Funktion ein Deployment aus der Dropdown-Liste auswählen.
Hier zahlt sich die Breite des Katalogs aus, denn Funktionen müssen sich weder ein Modell noch eine Familie teilen. Eine sinnvolle Aufteilung:
- Code Completion. Ein kleineres, schnelleres Modell aus der gewählten Familie, dort, wo Anfragevolumen hoch und Latenz am spürbarsten ist.
- Code Generation. Ein codespezialisiertes Modell, etwa eine Codex- oder Codestral-Variante.
- GitLab Duo Agentic Chat. Ein breit einsetzbares, universelles Modell. Ohne eigene Zuweisung übernimmt eine einzelne Chat-Unterfunktion das für General Chat im Admin-Bereich konfigurierte Modell.
- GitLab Duo Agent Platform. Jedes Modell mit voller Funktionalität für Agent Platform in GitLabs Matrix. Kleinere Modelle schneiden hier oft schlechter ab als bei Completion und Chat.
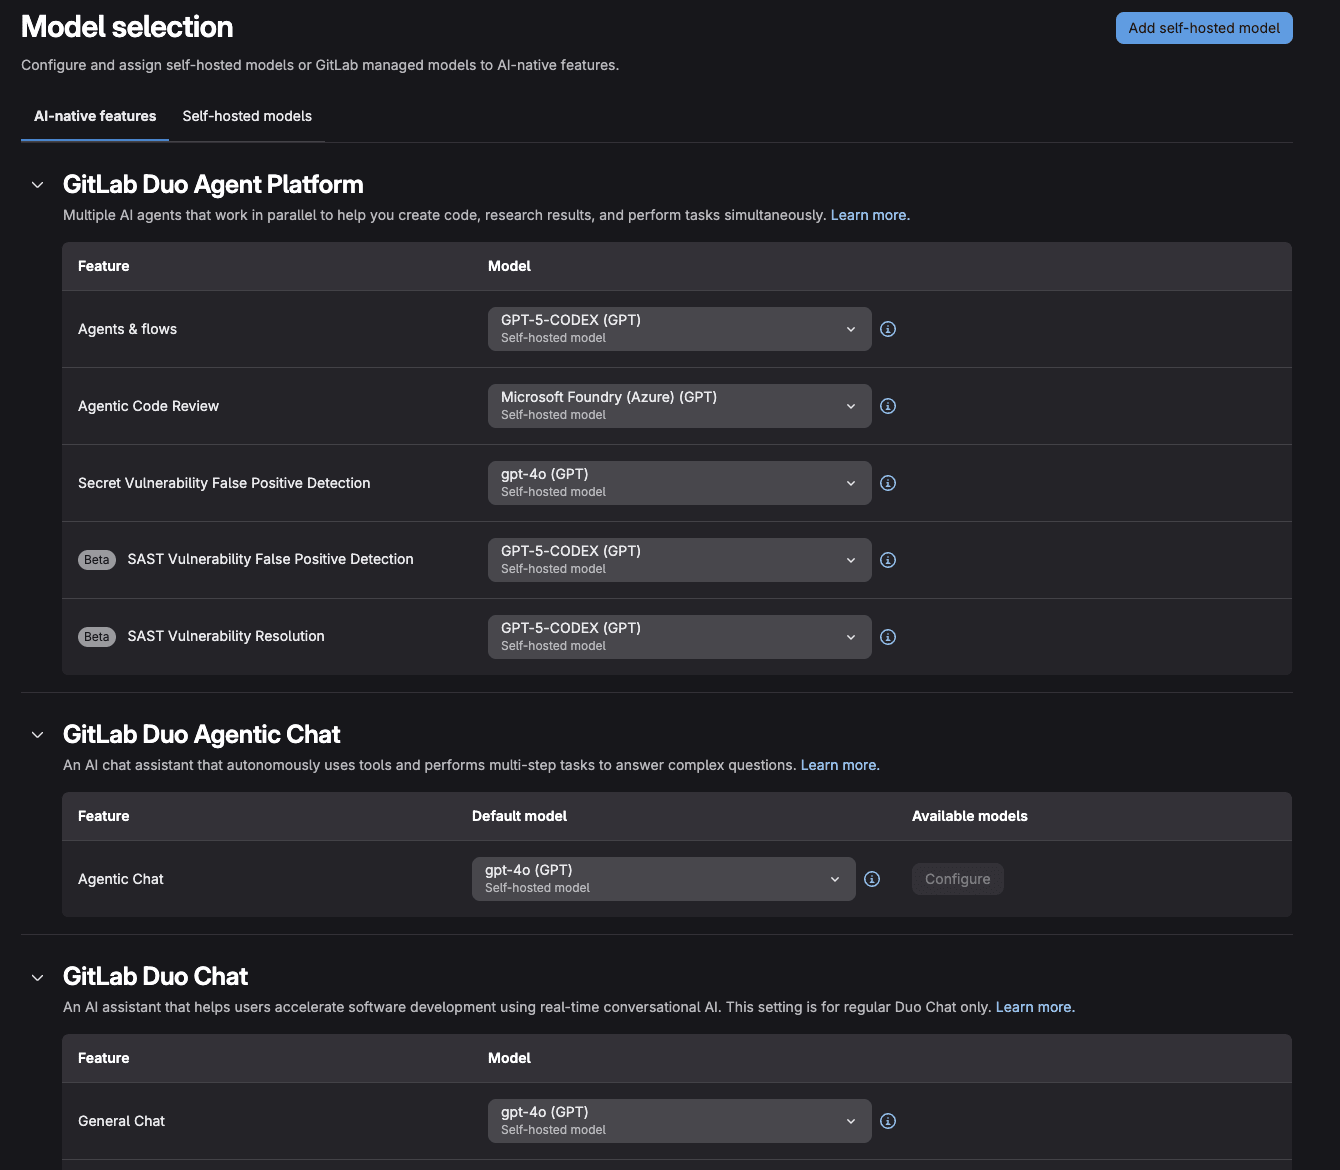 GitLab Duo: Modellauswahl
Diese Aufteilung ist eine erste Annahme, keine feinjustierte Konfiguration. Am Anfang steht ein einziges Modell für alle geplanten Funktionen, als sauberer Referenzwert für Qualität, Latenz und Kosten. Ein zweites Modell folgt erst dort, wo eigene Messungen es rechtfertigen.
Die Einrichtung überprüfen
Ob die Umsetzung von GitLab Duo Self-Hosted mit Microsoft Foundry korrekt funktioniert, zeigen folgende Prüfschritte:
1. Health-Check ausführen
Nachdem sichergestellt ist, dass das Modell selbst läuft, führt der Bereich GitLab Duo im Admin-Bereich über Run health check die eigentliche Prüfung durch. Geprüft wird Folgendes:
- Die AI-Gateway-URL ist korrekt konfiguriert.
- Die Instanz erreicht das AI Gateway.
- Das erforderliche GitLab-Duo-Add-on ist aktiv.
- Ein Modell ist Code Suggestions zugewiesen, denn dieses Modell testet die Verbindung.
Meldet der Health-Check Probleme, hilft der Leitfaden zur Fehlerbehebung bei den gängigen Fehlern.
2. Ein FastAPI-Grundgerüst mit Code Generation erstellen
Code Generation eignet sich als erster Test, weil dabei der gesamte Pfad durchlaufen wird und das Ergebnis eindeutig ausfällt. Zudem wird mehr Kontext gesendet als bei Code Completion. Ein falsch konfigurierter Endpunkt oder ein zu kleines Kontingent fällt dadurch sofort auf.
Code Suggestions kennt zwei unterschiedliche Verhaltensweisen. Für die Interpretation des Ergebnisses ist wichtig, welche davon gerade ausgelöst wird:
- Code Completion setzt beim Tippen ein und vervollständigt die aktuelle Zeile. Niedrige Latenz, meist unter einer Sekunde.
- Code Generation setzt nach Enter hinter einem Kommentar ein, der die gewünschte Funktion beschreibt. Möglich sind ganze Funktionen oder Klassen, die Antwortzeit kann über fünf Sekunden liegen.
So entsteht ein FastAPI-Grundgerüst:
- Ein Projekt in der IDE öffnen und eine leere Datei anlegen, etwa
main.py. Code Generation liefert bei weniger als fünf Zeilen präzisere Ergebnisse. Eine leere Datei ist damit der ideale Ausgangspunkt. - Einen Kommentar schreiben, der das Framework nennt und das gewünschte Ergebnis beschreibt:
# Create a FastAPI service with a health check endpoint and CRUD endpoints for # a "tasks" resource backed by an in-memory list. Use Pydantic models for # request and response bodies, and return appropriate HTTP status codes. - Enter nach dem Kommentar drücken. Der Zeilenumbruch signalisiert, dass die Anweisung vollständig ist.
- Auf den Vorschlag warten, dann mit Tab annehmen oder mit Esc verwerfen.
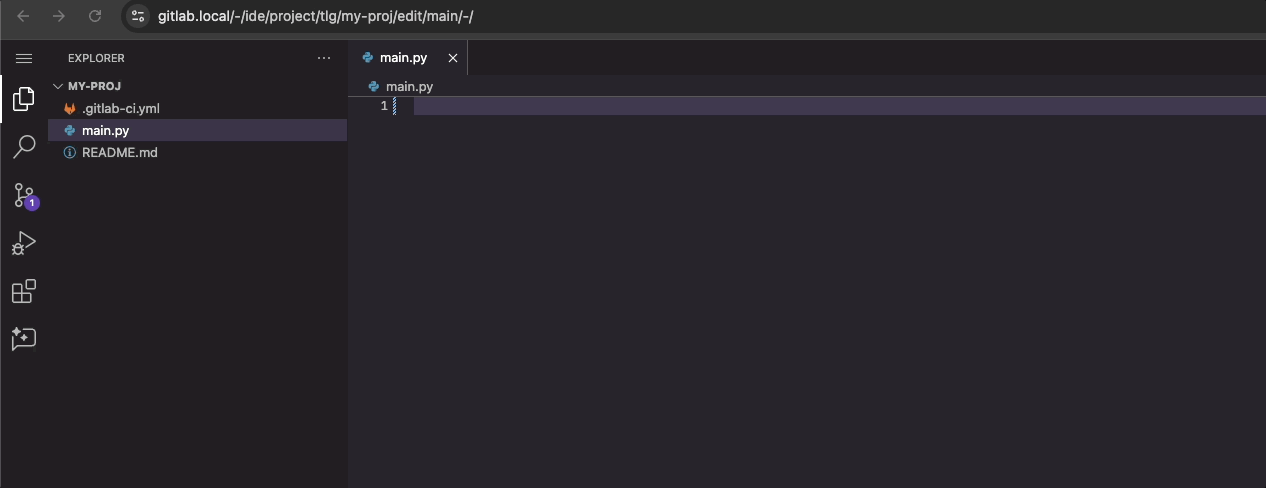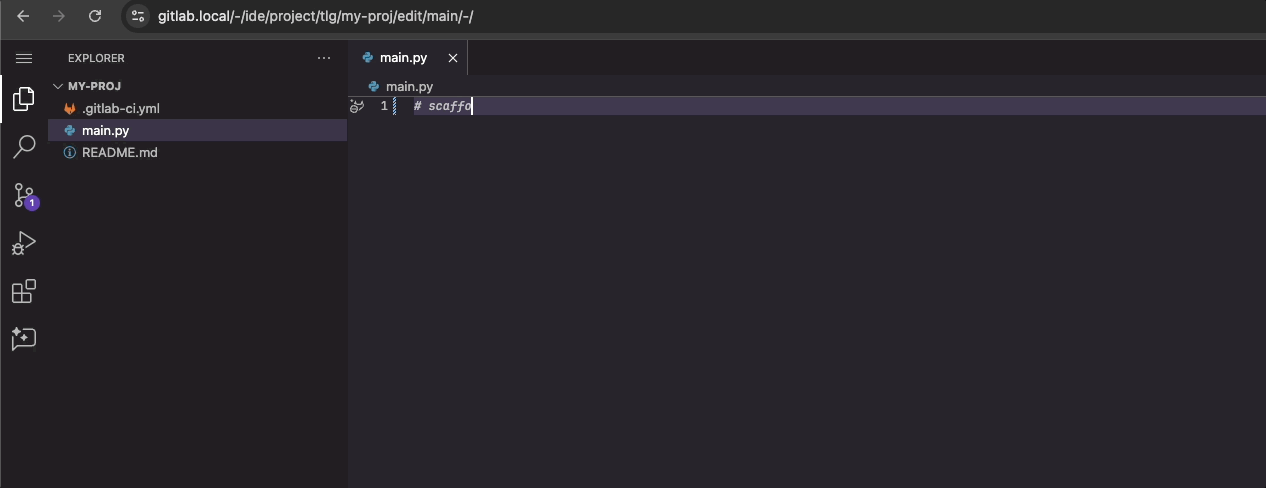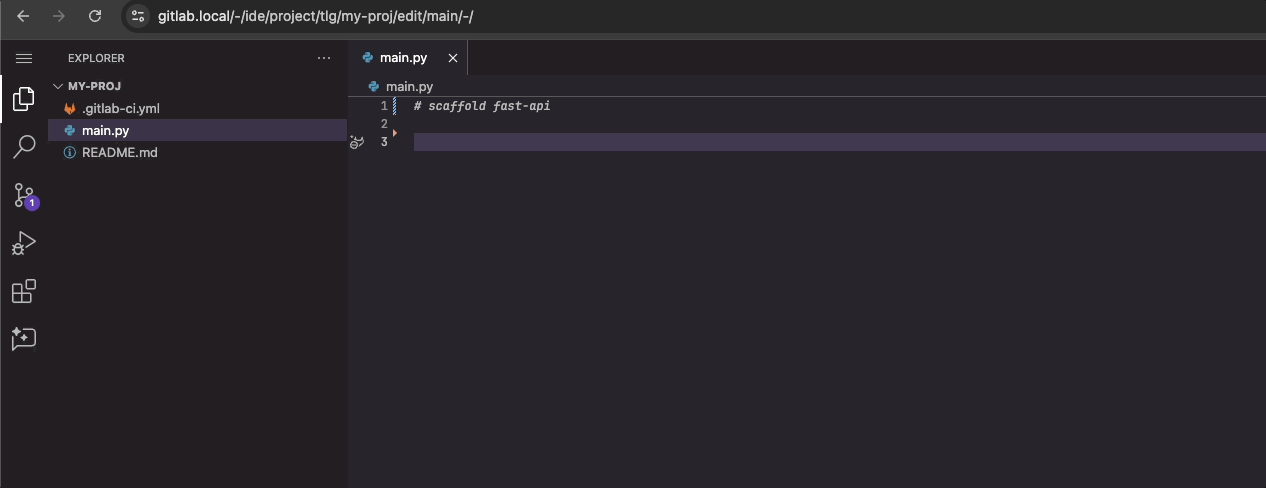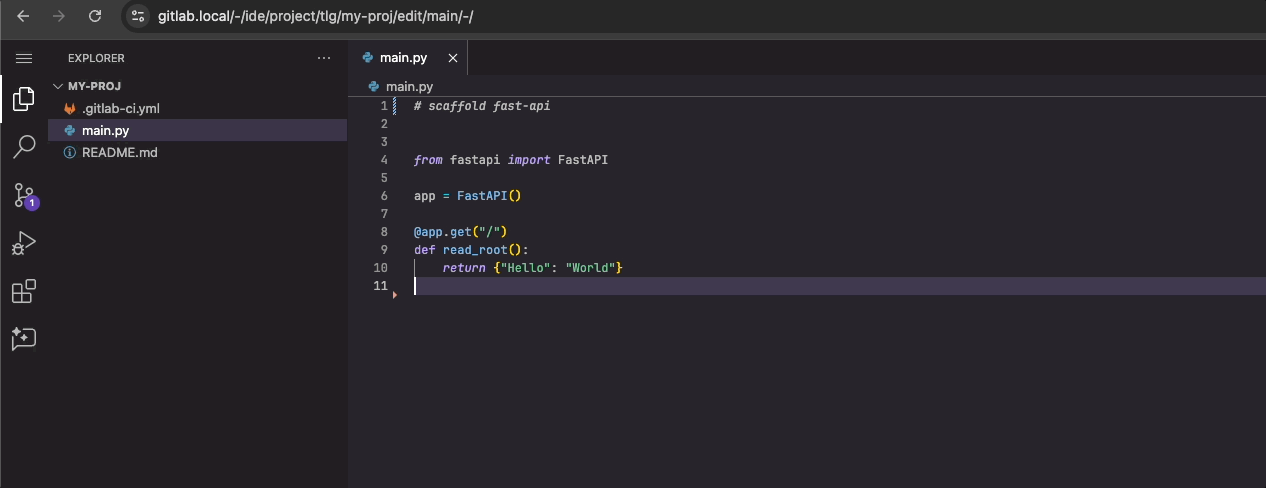 Code Generation: FastAPI-Grundgerüst erstellen
Entscheidend ist die explizite Nennung des Frameworks. GitLabs Empfehlung für Code Generation lautet: das Ergebnis benennen, konkret und knapp bleiben sowie die gewünschte Bibliothek oder das gewünschte Framework nennen. Ein vager Kommentar wie # web service liefert dem Modell deutlich weniger Anhaltspunkte.
Zwei Dinge sind zu erwarten. Die Ausgabe von Code Generation ist auf rund 2.048 Token begrenzt. Das Ergebnis ist also ein solides Grundgerüst, keine fertige Anwendung. Weil diese Modelle nicht deterministisch arbeiten, erzeugt derselbe Kommentar nicht zweimal identischen Code, was normal ist und keine Fehlkonfiguration anzeigt.
Sind unterschiedlichen Funktionen unterschiedliche Modelle zugewiesen, ist ein getrennter Test ratsam, damit ein Fehler auf ein bestimmtes Deployment zeigt. Ein erfolgreicher Test von Code Generation bestätigt zugleich, dass in Schritt 5 tatsächlich das zugewiesene Modell die Anfrage bedient.
3. AI-Gateway-Logs prüfen
Die AI-Gateway-Logs zeigen, ob Anfragen an die Microsoft-Foundry-Deployments weitergeleitet werden:
docker logs gitlab-ai-gateway --tail 100 -f
Die Logeinträge sollten erfolgreiche Anfragen an den konfigurierten Modell-Endpunkt zeigen. Prompt-Logging sollte nur aktiviert werden, wenn die Datenrichtlinie der Organisation das erlaubt.
Nächste Schritte
Diese Schritte folgen als Nächstes.
Modellauswahl aktuell halten
Das GitLab-Team testet die Leistung jedes Modells aktiv für jede Funktion und veröffentlicht eine Einstufung von Leistung und Eignung:
- Volle Funktionalität. Das Modell bewältigt die Funktion voraussichtlich ohne Qualitätsverlust.
- Teilweise Funktionalität. Die Funktion arbeitet, allerdings mit möglichen Einschränkungen oder Kompromissen.
- Eingeschränkte Funktionalität. Das Modell eignet sich nicht für die Funktion und kann zu deutlichem Qualitätsverlust oder Leistungsproblemen führen.
Kompatibilität lässt sich weder aus dem Modellnamen noch aus der Präsenz im Foundry-Katalog ableiten. Maßgeblich für die aktuellen Bewertungen bleibt GitLabs Seite zu Modellen und Hardwareanforderungen.
Strategien zur Kostenoptimierung:
- Start mit einem einzigen Modell, das in allen vier Bereichen mit voller Funktionalität bewertet ist, für alle geplanten Funktionen.
- Qualität, Latenz, Token-Verbrauch, Rate-Limit-Verhalten und Kosten mit repräsentativen Workloads messen.
- Funktionen mit hohem Volumen wie Code Completion auf ein kleineres Modell umstellen, sobald der Qualitäts-Kompromiss akzeptabel ist. Vor einer Wiederverwendung für Agent Platform empfiehlt sich zusätzlich ein Blick auf dessen dortige Bewertung.
- Ein codespezialisiertes Modell für Code Suggestions erwägen, wenn Generierungsqualität wichtiger ist als Kosten.
- GitLabs Support-Matrix und Microsofts Abkündigungsplan für Modelle regelmäßig prüfen.
- Verbrauch über Azure Cost Management überwachen und passende Budgets oder Warnungen konfigurieren.
Über Microsoft Foundry hinaus
Dieser Leitfaden konzentriert sich auf die Integration mit Microsoft Foundry, GitLab Duo Self-Hosted unterstützt allerdings mehrere Deployment-Optionen:
- On-Premises mit vLLM: ein unterstütztes oder OpenAI-API-kompatibles Modell auf selbst verwalteter Infrastruktur bereitstellen.
- Amazon Bedrock: ähnlich wie Microsoft Foundry, für Cloud-gehostete Modelle. Eine Schritt-für-Schritt-Anleitung dazu bietet der Beitrag GitLab Duo Self-Hosted mit AWS Bedrock.
- Weitere validierte Anbieter, darunter Anthropic, OpenAI und Gemini Enterprise Agent Platform.
Enterprise-Integration mit Azure
Für Organisationen, die bereits auf Azure setzen, bietet Microsoft Foundry eigene Vorteile:
- Einheitliche Abrechnung. Modellverbrauch zusammen mit den übrigen Azure-Diensten erfassen.
- Microsoft-Entra-Integration. Vorhandene Identitäts- und Rollenverwaltung auf Foundry-Ressourcen anwenden.
- Private Vernetzung. Private Endpunkte und den Netzwerkpfad zwischen GitLab und Azure passend zur eigenen Sicherheitsarchitektur bewerten.
- Regionale Bereitstellung. Region und Deployment-Typ nach Verfügbarkeit des gewählten Modells wählen, unter Berücksichtigung der weiter oben beschriebenen Unterscheidung beim Datenstandort.
Diese Fähigkeiten können ein Compliance-Programm unterstützen, machen aber kein GitLab-Duo-Deployment von sich aus konform. Architektur, Datenflüsse, Logging, Aufbewahrung, Verträge und Betriebskontrollen sollten insgesamt gegen die eigenen Anforderungen geprüft werden.
Zusammenfassung
GitLab Duo Self-Hosted mit Microsoft Foundry lässt Organisationen Funktionen von GitLab Duo aus Azure-gehosteten Modellen bedienen. Weil der Foundry-Katalog GPT, Claude, Llama und Mistral umfasst und GitLab Modelle aus jeder dieser Familien unterstützt, deckt ein einziges Azure-Abonnement die benötigten Familien ab. Am Anfang steht ein breit einsetzbares Modell, weitere Modelle für einzelne Funktionen folgen, sobald eigene Messungen das rechtfertigen.
Die in diesem Beitrag genannten Modellnamen sind Beispiele, keine Empfehlungen. Beide Kataloge ändern sich häufig. Maßgeblich bleiben zum Zeitpunkt der Bereitstellung die beiden Anbieter-Matrizen.
Im Kern bleibt die Modellwahl eine Kompatibilitätsentscheidung, kein Stöbern im Katalog: Support-Matrix von GitLab prüfen, Verfügbarkeit und Lifecycle-Status in Microsoft Foundry bestätigen, die Modelle bereitstellen und vor einem breiten Rollout mit eigenen Workloads validieren.
Erste Schritte
- Die Dokumentation zu GitLab Duo Self-Hosted bietet die vollständige Konfigurationsreferenz.
- Die GitLab Duo Agent Platform zeigt, was sich damit bauen lässt.
- Neu bei GitLab? Eine kostenlose Testversion von GitLab Ultimate steht zur Verfügung.
- Ein teamübergreifender Rollout in Planung? Der Kontakt zu GitLab klärt Lizenzierung und Architektur.
Weitere Inhalte
Alle Blogbeiträge anzeigen
Feedback erwünscht
Hat dir dieser Blogbeitrag gefallen? Hast du Fragen oder Feedback? Erstelle ein neues Diskussionsthema im GitLab-Community-Forum und lass andere an deinen Eindrücken teilhaben.
Feedback teilen