Date de publication : 24 août 2026
Temps de lecture : 13 min
L'IA confidentielle pour GitLab Self-Hosted
Proposez à vos équipes de développement des agents d'IA pour le code avec GitLab Duo sans que le code source ne quitte un périmètre protégé par chiffrement matériel, et sans GPU requis.
Vos équipes de développement veulent utiliser des agents d'IA pour le code. Cependant, votre code source est une propriété intellectuelle réglementée qui ne peut être transmise à un service d'IA tiers, comme indiqué par écrit par votre équipe de conformité. La solution de contournement habituelle, à savoir déployer votre propre cluster de GPU et exécuter les modèles vous-même, implique l'achat de matériel rare, le recrutement d'une équipe dédiée à son exploitation, et un retard structurel de plusieurs mois par rapport aux modèles de pointe. Résultat : vous ne faites rien, et vos équipes prennent du retard face à celles qui ont adopté l'IA il y a un an.
GitLab Duo Self-Hosted peut désormais utiliser Privatemode AI comme fournisseur de modèles. Privatemode exécute des modèles de pointe dans du matériel d'informatique confidentielle, de sorte que les prompts, le code source et les complétions restent chiffrés de bout en bout, y compris pendant l'inférence. Il vous suffit de pointer la passerelle d'IA de GitLab Duo vers le proxy Privatemode pour que vos équipes de développement accèdent aux mêmes fonctionnalités de GitLab Duo qu'avec n'importe quel modèle, avec une différence déterminante pour une organisation soumise à des réglementations : le code ne quitte jamais un périmètre chiffré, et aucun tiers ne peut le lire.
La productivité que la plupart des équipes réglementées n'atteignent pas
L'assistance d'IA pour le code a largement dépassé la simple autocomplétion. GitLab Duo Agent Platform exécute des tâches en plusieurs étapes : revue de merge requests, refactorisation sur plusieurs fichiers, génération et exécution de tests, orchestration de flows agentiques sous forme de jobs CI, et bien plus encore. Il s'agit d'un véritable changement dans la manière dont les équipes livrent des logiciels, et ses effets sont cumulatifs. Les équipes qui l'utilisent effectuent des revues plus rapidement et consacrent moins de temps aux tâches répétitives.
Le problème, c'est que chacune de ces fonctionnalités envoie vos prompts et votre code source à un fournisseur de modèles. Pour une équipe travaillant sur du code propriétaire, des logiciels soumis à une réglementation ou une propriété intellectuelle sensible, ce scénario est rédhibitoire.
Pourquoi les organisations réglementées optent pour des environnements auto-hébergés
Pour les organisations des secteurs réglementés, le code source est une propriété intellectuelle fondamentale, et la question de savoir où il est traité relève de considérations contractuelles, sectorielles et réglementaires, et non d'une simple question de commodité. Qu'il s'agisse des algorithmes de trading d'une banque, du micrologiciel d'un fabricant de dispositifs médicaux ou du logiciel de contrôle d'un sous-traitant du secteur de la défense : confier cette propriété intellectuelle à un service d'IA externe peut enfreindre les protections en matière de propriété intellectuelle, les accords de traitement des données et les règles sectorielles.
La pression vient de plusieurs fronts à la fois. La directive NIS 2 et le règlement Digital Operational Resilience Act (DORA) renforcent les exigences en matière de résilience opérationnelle et de risque lié aux tiers dans les infrastructures critiques et les services financiers. Le RGPD régit la manière dont les données à caractère personnel contenues dans le code et les logs sont traitées. Des réglementations sectorielles (supervision de la BaFin dans le secteur financier allemand, norme BSI C5 comme référentiel d'achat, règles relatives aux données de santé) viennent ajouter leurs propres contraintes. Par ailleurs, de nombreuses organisations européennes considèrent la souveraineté des données comme une exigence de premier ordre, indépendamment de toute réglementation spécifique.
Les secteurs les plus concernés sont les services financiers, la santé, l'industrie pharmaceutique, la défense, le secteur public et les infrastructures essentielles. GitLab Self-Hosted existe précisément pour que ce code ne quitte jamais un périmètre de confiance. L'intégration de l'IA dans un workflow ne devrait pas remettre en cause cette garantie.
Pourquoi l'IA est difficile à intégrer dans les environnements auto-hébergés
Une équipe évoluant dans un environnement auto-hébergé qui souhaite bénéficier d'une assistance d'IA pour le code dispose de trois options conventionnelles, chacune assortie de coûts que l'acheteur soumis à une réglementation ne peut pas facilement assumer.
| IA SaaS publique | IA en VPC / cloud privé | Exécution de votre propre pile LLM | |
|---|---|---|---|
| Le code source quitte votre périmètre | Oui | Oui (vers l'opérateur) | Non |
| Type de garantie | Contractuelle (conditions d'utilisation) | Contractuelle (opérateur + cloud) | Auto-appliquée |
| Accès au texte en clair | Fournisseur | Opérateur et fournisseur cloud | Vous seul |
| Charge d'infrastructure | Aucune | Faible | Élevée : GPU, opérations sur les modèles, mises à jour |
| Suivi des modèles de pointe | Oui | Généralement | Rarement, vous prenez du retard |
Le tableau comparatif montre que les options d'IA SaaS publique et VPC exposent le code et reposent sur des garanties contractuelles, tandis que l'exécution de votre propre pile préserve la confidentialité du code mais implique une lourde charge en termes de GPU et d'opérations sur les modèles.
En résumé : le SaaS public est écarté d'office, car le code quitte l'organisation. Un service isolé en VPC ou en cloud privé réduit l'exposition, mais transmet tout de même le texte en clair à l'opérateur et au fournisseur cloud sous-jacent. Par ailleurs, un contrat est une promesse, non une garantie cryptographique. Exécuter ses propres modèles préserve la confidentialité du code, mais implique des coûts d'acquisition et de personnel élevés, et ces modèles sont structurellement en retard par rapport aux meilleurs modèles du marché. Face à ce constat, la plupart des organisations réglementées adoptent l'IA de façon limitée, voire pas du tout.
La question devient alors de savoir comment offrir aux équipes de développement des agents d'IA modernes sans que le code source ne quitte le périmètre de sécurité, et sans avoir à gérer soi-même une pile LLM. La réponse exige un type de garantie différent de ce qu'un contrat peut offrir, à savoir une garantie assurée par le matériel.
L'informatique confidentielle : la réponse architecturale
L'informatique confidentielle maintient les données chiffrées en mémoire, pendant leur traitement, grâce à un environnement d'exécution de confiance (TEE) basé sur le matériel, une région isolée d'un CPU ou d'un GPU que même le système d'exploitation, l'hyperviseur et l'opérateur de la machine ne peuvent pas lire. Le matériel concerné est AMD SEV ou Intel TDX côté CPU, associé à NVIDIA Confidential Computing côté GPU. Les données sont chiffrées en transit et au repos avec AES-256, et ne sont déchiffrées qu'à l'intérieur de l'environnement d'exécution de confiance.
L'élément qui transforme cette promesse en garantie est l'attestation à distance. Avant d'envoyer des données, le client demande au TEE de prouver son identité : le matériel produit une preuve cryptographique signée de ce qui s'exécute exactement dans l'enclave. Le client vérifie cette preuve par rapport à des valeurs de référence connues, puis établit le canal chiffré et envoie sa requête.
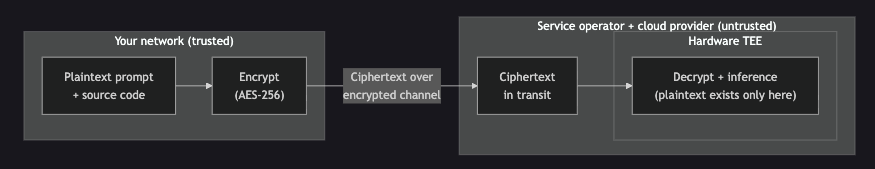
Le schéma du flux de données montre les prompts chiffrés côté client, transmis sous forme de texte chiffré, et déchiffrés uniquement à l'intérieur d'un TEE matériel que ni l'opérateur du service ni le fournisseur cloud ne peuvent lire.
La propriété de sécurité qui en découle est l'essentiel : ni l'opérateur du service d'IA ni le fournisseur cloud sous-jacent ne peuvent consulter vos prompts, vos complétions ou votre contexte. Non pas parce qu'ils se sont engagés à ne pas le faire, mais parce que le matériel ne le leur permet pas.
Privatemode AI
Privatemode AI a été développé par Edgeless Systems, une entreprise allemande spécialisée dans les logiciels d'informatique confidentielle. Selon NVIDIA, Privatemode est le « framework d'IA de première génération qui maintient en permanence le chiffrement des prompts ».
Pour les équipes de développement, les mécanismes sont invisibles. Privatemode expose une API compatible avec OpenAI, et un proxy côté client gère l'attestation et le chiffrement de manière transparente, de sorte que les outils et SDK qui utilisent l'API standard /v1 fonctionnent sans modification. Le modèle phare actuel pour le développement est Kimi K2.6 avec un contexte de 256 000 tokens. D'autres modèles comme Kimi K3 et GLM seront prochainement disponibles.
Il ne s'agit pas d'une expérience de laboratoire. Privatemode est déjà en production dans des organisations confrontées aux contraintes décrites ci-dessus. Capgemini l'utilise pour ses clients dans des secteurs réglementés, notamment pour le développement confidentiel. L'Agence fédérale allemande pour l'emploi l'utilise dans le secteur public. Des banques, des assureurs et des organismes de défense y ont recours lorsque le code source et les données ne peuvent pas quitter un périmètre de confiance. Sa cryptographie est résistante à l'ère post-quantique, ce qui protège également contre les attaques de type « harvest now, decrypt later » (collecter maintenant, déchiffrer plus tard). Un adversaire qui capturerait les textes chiffrés actuels dans l'espoir de les déchiffrer avec le matériel de demain n'obtiendrait rien d'exploitable.
Fonctionnement de l'intégration
GitLab Duo Self-Hosted vous permet d'utiliser les fonctionnalités d'IA de GitLab Duo depuis un modèle que vous contrôlez, plutôt que depuis une passerelle gérée par GitLab. Privatemode peut justement jouer le rôle de ce modèle.
Le processus est simple. GitLab Duo communique avec une passerelle d'IA auto-hébergée, qui transfère l'inférence vers n'importe quel point de terminaison compatible avec OpenAI. Le proxy Privatemode est ce point de terminaison : il expose une API standard /v1 et gère le chiffrement ainsi que l'attestation vis-à-vis du service Privatemode. Lorsqu'une requête arrive, le proxy la chiffre avant qu'elle ne quitte votre réseau, vérifie le TEE distant par attestation, puis la transfère. Le déchiffrement s'effectue exclusivement dans l'environnement d'informatique confidentielle. Au sein de GitLab Duo (Code Suggestions, Chat, Code Review et les flows agentiques), l'expérience des équipes de développement reste inchangée.
sequenceDiagram
    autonumber
    actor Dev as Développeur /<br>GitLab Duo Agent Platform
    participant GW as Passerelle d'IA<br>auto-hébergée GitLab
    participant Proxy as Proxy<br>Privatemode
    participant TEE as TEE distant<br>(CPU + GPU)

    Dev->>GW: Requête d'inférence (Code<br>Suggestions, Chat,<br>Code Review, flows)
    GW->>Proxy: Transfert de la requête<br>vers un point de terminaison OpenAI<br>compatible

    rect rgb(255, 244, 214)
        Note over Proxy,TEE: Attestation avant tout envoi de code
        Proxy->>TEE: Demande de preuve d'attestation
        TEE-->>Proxy: Preuve signée du code de l'enclave
        Proxy->>Proxy: Vérification de preuve face à des valeurs connues
        Proxy->>TEE: Établissement d'un canal chiffré (AES-256, résistant à l'ère post-quantique)
    end

    Proxy->>TEE: Transfert de la requête chiffrée
    Note over TEE: Déchiffrement + inférence<br>(seulement dans l'enclave)
    TEE-->>Proxy: Réponse chiffrée
    Proxy-->>GW: Réponse chiffrée
    GW-->>Dev: Complétion (expérience du développeur<br>inchangée)
Dans le diagramme de séquence, une requête GitLab Duo transite par la passerelle d'IA auto-hébergée pour atteindre le proxy Privatemode, qui atteste l'enclave distante et établit un canal chiffré avant de transmettre la requête pour inférence à l'intérieur de l'environnement d'exécution de confiance.
Vous gérez vous-même la passerelle d'IA et le proxy, et la configuration est indépendante du mode de déploiement (paquet Linux, Docker ou Kubernetes). Les étapes sont documentées et spécifiques à chaque version ; plutôt que de les reproduire ici, consultez le guide d'intégration GitLab Duo de Privatemode.
Les compromis
Aucune architecture n'est gratuite, et un lecteur averti mérite que les coûts soient exposés clairement.
Vous gérez la passerelle et le proxy. Il s'agit d'un véritable travail d'infrastructure : déployer la passerelle d'IA sur un nom d'hôte approprié, faire correspondre la version de son image à votre release GitLab à chaque mise à jour, configurer les clés et certificats JWT, et maintenir le proxy accessible. Il s'agit d'une opération d'infrastructure courante, et non l'achat de GPU ni l'exploitation de modèles. Cette distinction est fondamentale. L'alternative qui préserve la confidentialité du code, à savoir l'exécution de votre propre pile LLM, implique l'achat de GPU rares et le recrutement d'une équipe pour exécuter et mettre à jour les modèles, avec un retard structurel sur les modèles de pointe. Privatemode est un SaaS hébergé qui prend en charge les opérations sur les modèles à votre place ; la seule charge qui vous incombe est la gestion d'un proxy et d'une passerelle.
Les modèles génériques compatibles avec OpenAI sont encore en cours de maturation dans GitLab Duo Self-Hosted. À l'heure actuelle, ces modèles sont disponibles en mode bêta, de sorte que la prise en charge de problèmes spécifiques aux modèles n'est pas encore garantie. La roadmap prévoit de consolider ce point, mais si vous avez besoin d'une configuration entièrement prise en charge dès maintenant, tenez compte de ce calendrier dans votre déploiement.
L'attestation et le chiffrement entraînent une certaine surcharge. L'aller-retour supplémentaire et les opérations cryptographiques rallongent le temps de traitement de chaque requête. Lors de nos tests, cela n'a pas posé de problème pratique, mais le guide d'intégration recommande d'augmenter le délai d'expiration de la passerelle d'IA pour les backends auto-hébergés plus lents. Il vaut donc la peine de mesurer ce délai par rapport à votre budget de latence.
Votre confiance repose sur un élément délimité. La garantie repose sur la fiabilité du TEE matériel et de la chaîne d'attestation. Il s'agit d'une hypothèse de confiance plus restreinte et plus vérifiable que celle qui part du principe que l'opérateur ne consultera pas vos données, et vous pouvez vérifier vous-même les preuves d'attestation. Cependant, cette hypothèse n'est pas infaillible. L'informatique confidentielle ne supprime pas la confiance requise, elle la limite au matériel sous-jacent.
Ce que cela signifie en pratique
- Pour les organisations réglementées : une solution permettant de mettre en œuvre des agents d'IA pour le code modernes, conforme aux politiques existantes en matière de propriété intellectuelle et de protection des données, car le code reste dans un périmètre chiffré par le matériel, sans achat de GPU ni mise en place d'opérations sur les modèles.
- Pour les équipes de développement : la même expérience GitLab Duo, des modèles identiques ou améliorés, sans nouvel outil à adopter. La sélection du modèle étant gérée au niveau de l'instance, le Chat et GitLab Duo Code Suggestions via l'extension GitLab Workflow héritent des mêmes paramètres de configuration confidentielle.
- Pour les équipes de conformité et de sécurité : l'architecture s'aligne sur la norme BSI C5:2026 concernant l'informatique confidentielle et l'attestation distante, et vous fournit des preuves techniques concrètes, à savoir des données chiffrées en cours d'utilisation et une exécution attestée, à présenter lors des discussions relatives à la directive NIS 2, au règlement DORA et au RGPD. L'architecture n'offre pas de conformité en elle-même, car la conformité est organisationnelle et continue. Elle élimine d'emblée le principal frein à l'adoption de l'IA : la crainte que le code ne quitte le périmètre.
Découvrez Privatemode
Privatemode en tant que fournisseur de modèles auto-hébergé pour GitLab Duo nécessite GitLab Self-Managed, GitLab Premium ou GitLab Ultimate, version 17.9 ou ultérieure, avec le module d'extension GitLab Duo Enterprise. Les flows agentiques nécessitent en outre GitLab Duo Agent Platform (en disponibilité générale à partir de la version 18.8). L'utilisation consomme des GitLab Credits selon les règles et multiplicateurs Bring Your Own Model décrits dans la documentation relative aux GitLab Credits.
En savoir plus
En savoir plus
Afficher tous les articles du blog
Donnez-nous votre avis
Cet article de blog vous a plu ? Vous avez des questions ou des retours ? Donnez votre avis en créant un nouveau sujet sur le forum de la communauté GitLab.
Faites-nous part de vos commentaires