Date de publication : 25 août 2026
Temps de lecture : 38 min
L'ère de l'abondance du code
La production de code devient de moins en moins coûteuse. Pas la confiance qu'on lui accorde. Découvrez pourquoi les entreprises ont besoin d'une couche durable de contexte, de vérification et de gouvernance autour des agents d'IA.

Je suis revenu de vacances au mois de janvier avec la conviction qu'un changement fondamental s'était produit.
Les grands modèles de langage avaient atteint un niveau de maturité suffisant pour produire du code utile de manière suffisamment fiable et à un coût suffisamment bas pour bouleverser l'économie du développement logiciel. Les ingénieurs du monde entier semblaient tester le même scénario : non seulement solliciter un assistant d'IA pour des suggestions, mais aussi confier à des agents de véritables tâches pour observer jusqu'où ils pouvaient les mener.
J'ai commencé à réfléchir à ce qui se passerait si cette tendance se confirmait. Qu'est-ce qui change lorsque la production de code n'est plus la principale contrainte dans la création de logiciels ?
J'ai consigné ces réflexions dans une note destinée au conseil d'administration en janvier. En mai, j'en ai publié une partie dans l'Acte 2 de GitLab : le coût et le temps de production logicielle étaient en train de s'effondrer, les machines créeraient de plus en plus de logiciels sous la direction de l'homme, et l'architecture sous-jacente au développement logiciel devrait évoluer en conséquence.
En juin, lors de GitLab Transcend, nous avons présenté les premiers éléments de cette architecture : un contrôle de version repensé pour la concurrence à l'échelle des machines, GitLab Orbit comme graphe de contexte couvrant l'ensemble du cycle de vie logiciel, ainsi qu'une gouvernance autour de l'identité des agents, des politiques, des approbations et des audits.
Puis, le 21 août, Anthropic a publié The AI-Native SDLC Playbook. Ce playbook commence par une affirmation simple :
« Le code n'est plus le goulot d'étranglement. »
Je suis d'accord.
Le playbook d'Anthropic décrit de manière concrète comment le cycle de vie du développement évolue lorsque les agents peuvent accélérer considérablement la mise en œuvre : la planification devient lisible par machine, les transferts s'automatisent, la vérification s'intègre dans la boucle, et le jugement humain se concentre aux points de contrôle.
Ce qui m'intéresse, c'est ce qui se passe à un niveau supérieur du workflow. Si le code n'est plus la contrainte principale, qu'est-ce qui devient rare ? Quelle architecture une entreprise doit-elle adopter lorsque des personnes, des agents et plusieurs modèles agissent simultanément sur l'ensemble du cycle de vie logiciel à la vitesse d'une machine ? Et où se situe désormais la valeur durable lorsque la génération de code elle-même se multiplie ?
Au cours des huit derniers mois, j'ai observé les équipes d'ingénierie de GitLab et d'autres organisations (notamment Stripe, Spotify et Amplitude), commencer à répondre à ces questions en production. Leurs expériences ont renforcé ma conviction initiale. Le changement important ne réside pas simplement dans le fait que l'IA peut produire du code plus rapidement.
En effet, lorsque la mise en œuvre devient nettement moins coûteuse, les aspects économiques et l'architecture qui entourent le développement logiciel évoluent en conséquence.
La contrainte ne réside plus dans la production du code, mais dans la confiance que l'on peut lui accorder. Cette confiance dépend de plus en plus de l'environnement qui entoure le modèle : contexte, vérification, gouvernance et preuves. À mesure que les organisations exploitent simultanément de nombreux modèles et agents, cette couche doit être durable et indépendante. Et à mesure que les agents intègrent davantage les workflows, l'expertise et les connaissances opérationnelles d'une organisation, ils doivent appartenir à cette organisation, et non au fournisseur du modèle ou du cloud sur lequel ils reposent.
La contrainte qui a façonné tout un secteur
Depuis 60 ans, l'ingénierie logicielle s'organise autour d'un principe fondamental :
Le code est précieux.
Le code est coûteux parce que transformer une intention métier en logiciel fiable exige des personnes rares et capables de gérer des abstractions complexes. Il est fragile parce que de petites erreurs peuvent avoir d'énormes conséquences. Et la complexité s'accumule plus vite qu'un individu ne peut l'assimiler. Une grande partie de notre façon de construire des logiciels découle de cette contrainte.
Nous préservons les systèmes legacy parce que les reconstruire est risqué. Nous relions les technologies entre elles plutôt que de les remplacer. La dette technique perdure pendant des années parce que son remboursement entre en concurrence avec les besoins des clients du trimestre en cours.
Nous optimisons massivement la productivité des équipes de développement, car ce sont elles qui produisent cette ressource rare. Les outils fragmentés, les environnements incohérents et les processus bancals sont tolérés si leur modification risque de ralentir les ingénieurs.
À cela s'ajoute tout un ensemble d'étapes : revues, approbations, portes de mise en production, contrôles de sécurité, processus de changement et tests de plus en plus sophistiqués. La plupart de ces étapes existent pour protéger une ressource dont la création est coûteuse et dont les erreurs sont onéreuses. Et la majeure partie de la valeur n'est jamais créée. Pour chaque idée qui parvient à figurer sur une roadmap, beaucoup d'autres ne survivent jamais aux contraintes économiques liées à la rareté des capacités d'ingénierie.
Nous dépensons une énergie considérable pour maîtriser le coût du changement, car celui-ci a toujours été onéreux.
Cette contrainte commence à s'estomper. Et lorsqu'une contrainte aussi fondamentale évolue, le reste du système finit par suivre le mouvement.
Chaque abstraction révèle la contrainte suivante
Cela s'est déjà produit par le passé.
Autrefois, les êtres humains programmaient les ordinateurs directement en instructions machine. L'assembleur a abstrait la machine. Les langages de haut niveau ont déplacé l'abstraction encore plus loin. Chaque couche a considérablement simplifié un problème tout en mettant en évidence celui qui se cachait derrière.
Personne ne regrette l'assembleur écrit à la main. Nous avons simplement un problème plus ambitieux à résoudre.
Les grands modèles de langage ne sont évidemment pas des compilateurs au sens technique du terme. Ce sont des systèmes probabilistes, et non des transformations déterministes dotées d'une sémantique définie. Mais d'un point de vue économique, l'analogie est utile : ils réduisent considérablement l'effort humain nécessaire pour passer de l'intention à la mise en œuvre.
La distinction qui importe est la suivante :
La production de code gagne en abondance. Ce n'est pas le cas des bons logiciels.
Les modèles peuvent générer une mise en œuvre bien plus rapide que les humains. Cela ne signifie pas pour autant que cette mise en œuvre est correcte, sécurisée, performante, conforme, facile à maintenir, ni même en adéquation avec l'intention de l'entreprise. C'est précisément là que se situe l'enjeu. Lorsque le code était rare, la difficulté résidait dans sa production. À mesure que le code devient abondant, la difficulté réside désormais dans la confiance que l'on peut lui accorder.
| Quand le code est précieux | Quand le code est abondant |
|---|---|
| Préserver les systèmes legacy car la refonte est coûteuse | Reconstruire lorsque cela revient moins cher que de continuer à pallier les lacunes |
| Optimiser massivement la production des équipes de développement | Optimiser les résultats métier et la rapidité d'apprentissage |
| Accumuler de la dette technique sur de longues périodes | Résorber la dette lorsque cela est économiquement justifié |
| Ne poursuivre que les idées les plus prometteuses | Tester bien plus d'idées à faible coût |
| Utiliser des processus pour limiter les erreurs coûteuses | Utiliser des contraintes et des vérifications pour gouverner les changements à grande échelle |
Le coût de la saisie masquait les problèmes les plus complexes. L'IA les met en évidence.
Le faible coût de l'itération modifie la stratégie
Une objection légitime consiste à dire que la saisie du code n'a jamais été la partie la plus difficile.
La partie la plus difficile, c'est de décider quoi construire. Les exigences sont floues. Les clients changent d'avis. Les équipes ne se comprennent pas toujours. Et les vrais problèmes n'apparaissent qu'une fois que le logiciel est confronté à la réalité.
Tout cela est vrai.
Mais cet argument suppose que le coût d'une erreur reste inchangé. Découvrir après six semaines qu'une exigence avait été mal comprise est coûteux. Cette dépense incite à vouloir faire les choses correctement dès le départ. Les cahiers des charges, les revues d'architecture et une planification minutieuse constituent des réponses rationnelles à des itérations coûteuses.
Rendez l'itération peu coûteuse, et la stratégie s'inverse.
Vous cessez d'essayer d'éliminer l'incertitude avant la mise en œuvre et commencez à chercher à apprendre plus vite.
Il existe une autre conséquence qui pourrait s'avérer encore plus importante. Les équipes d'ingénierie accumulent des quantités considérables de connaissances qui ne sont jamais intégrées au logiciel lui-même. Un ingénieur expérimenté sait quel service est fragile. Quelqu'un se souvient pourquoi un déploiement a échoué il y a trois ans. Un ingénieur en sécurité se souvient du type d'erreur qui a causé le dernier incident. Aujourd'hui, une grande partie de ce savoir repose essentiellement sur des individus. Lorsque la mise en œuvre devient peu coûteuse, une plus grande partie de ces connaissances peut devenir exécutable.
Une défaillance en production devient un test de régression. Un incident de sécurité devient une politique. Une exigence de performance devient une contrainte automatisée. Une obligation de conformité devient une validation continue.
L'apprentissage se transforme en code.
Pas la totalité au sens littéral, et les contraintes d'exécution n'éliminent pas le jugement. Les politiques peuvent être erronées. Les tests peuvent intégrer des hypothèses dépassées. Mais il est possible que les connaissances organisationnelles deviennent plus persistantes, plus vérifiables et plus révisables, au lieu de disparaître lorsque la personne qui les a acquises quitte l'entreprise. Il s'agit là d'un autre type de mémoire institutionnelle, et c'est l'une des raisons pour lesquelles l'abondance du code peut améliorer la qualité plutôt que simplement augmenter le volume.
Amplitude a récemment publié un exemple de ce qu'une refonte de cette ampleur peut produire. En six mois, l'entreprise a triplé le nombre de pull requests qu'elle a livrées, tandis que le nombre de bogues signalés chaque mois est passé de 715 à 319. Cela ne prouve pas que davantage de code généré par l'IA crée de meilleurs logiciels. Cela montre toutefois qu'un volume de modifications bien plus élevé n'implique pas nécessairement une baisse proportionnelle de la qualité.
Le coût par modification acceptée
Selon moi, l'unité économique la plus importante dans cette transition n'est pas le coût par ligne de code.
C'est le coût par modification acceptée.
Une modification logicielle utile comprend la génération, la configuration de l'environnement, le contexte, la vérification, la revue, la remédiation et la gouvernance. L'IA réduit considérablement le temps de génération, ce qui rend tout le reste proportionnellement plus important. Une organisation qui multiplie par dix la vitesse de génération mais ne touche pas à l'intégration continue, à la revue et à la validation ne deviendra pas dix fois plus rapide.
Elle ne fera que déplacer la file d'attente.
C'est exactement ce que prédit la Théorie des contraintes : supprimez un goulot d'étranglement, et le système en révèle un autre. Nous commençons maintenant à observer ce phénomène.
Quand les agents atteignent la production
Stripe a développé des agents de codage internes appelés minions. Plus d'un millier de pull requests fusionnées chaque semaine chez Stripe sont entièrement réalisées par des minions. Des humains les examinent, mais le code lui-même est généré par des agents.
Amplitude a documenté une refonte de six mois de son pipeline de développement. La durée du cycle des pull requests est passée de 5,2 heures à 44 minutes. L'intégration continue frontend est passée d'environ trente minutes à trois ou quatre.
Spotify utilise un agent de codage en arrière-plan appelé Honk et a recensé plus de 1 500 pull requests générées par l'IA et intégrées en production.
Il s'agit d'organisations d'ingénierie aux capacités exceptionnelles ; leurs parcours ne doivent donc pas être considérés comme la preuve que chaque entreprise pourrait fonctionner de la même manière. Néanmoins, elles sont allées suffisamment loin pour mettre en évidence les contraintes qui nous attendent, dont plusieurs reviennent régulièrement, et c'est là ce qui fait leur force.
L'environnement de développement d'Amplitude souffrait d'une configuration manuelle fastidieuse, d'une intégration continue lente et d'outils incohérents. Cette situation a perduré pendant des années parce que la production de code limitait la vitesse à laquelle les changements étaient intégrés au système. Les agents ont supprimé ce frein, et la validation ainsi que la revue sont devenues les points de blocage.
Amplitude a donc repensé ses fondations : configuration d'environnement plus rapide, intégration continue nettement plus rapide et moins de schémas incohérents qui perturbaient à la fois les humains et les agents. Ce travail n'a que très peu fait appel à l'IA. Il s'agissait d'un travail d'infrastructure devenu nécessaire du fait que l'IA avait modifié le débit du système.
De nombreuses organisations concentrent actuellement leurs efforts sur le choix du meilleur modèle de codage.
En pratique, un pipeline d'intégration continue de trente minutes neutralise tous les modèles que vous lui soumettez.
Les agents n'éliminent pas les contraintes d'ingénierie existantes. Ils les mettent simplement en évidence plus rapidement.
Trois modes, pas une seule courbe de maturité
La plupart des descriptions de l'adoption de l'IA laissent entendre un parcours unique, allant du développement traditionnel au développement entièrement autonome. Je ne pense pas que la transition s'opérera de cette manière dans les entreprises. Trois modes coexisteront pendant longtemps.
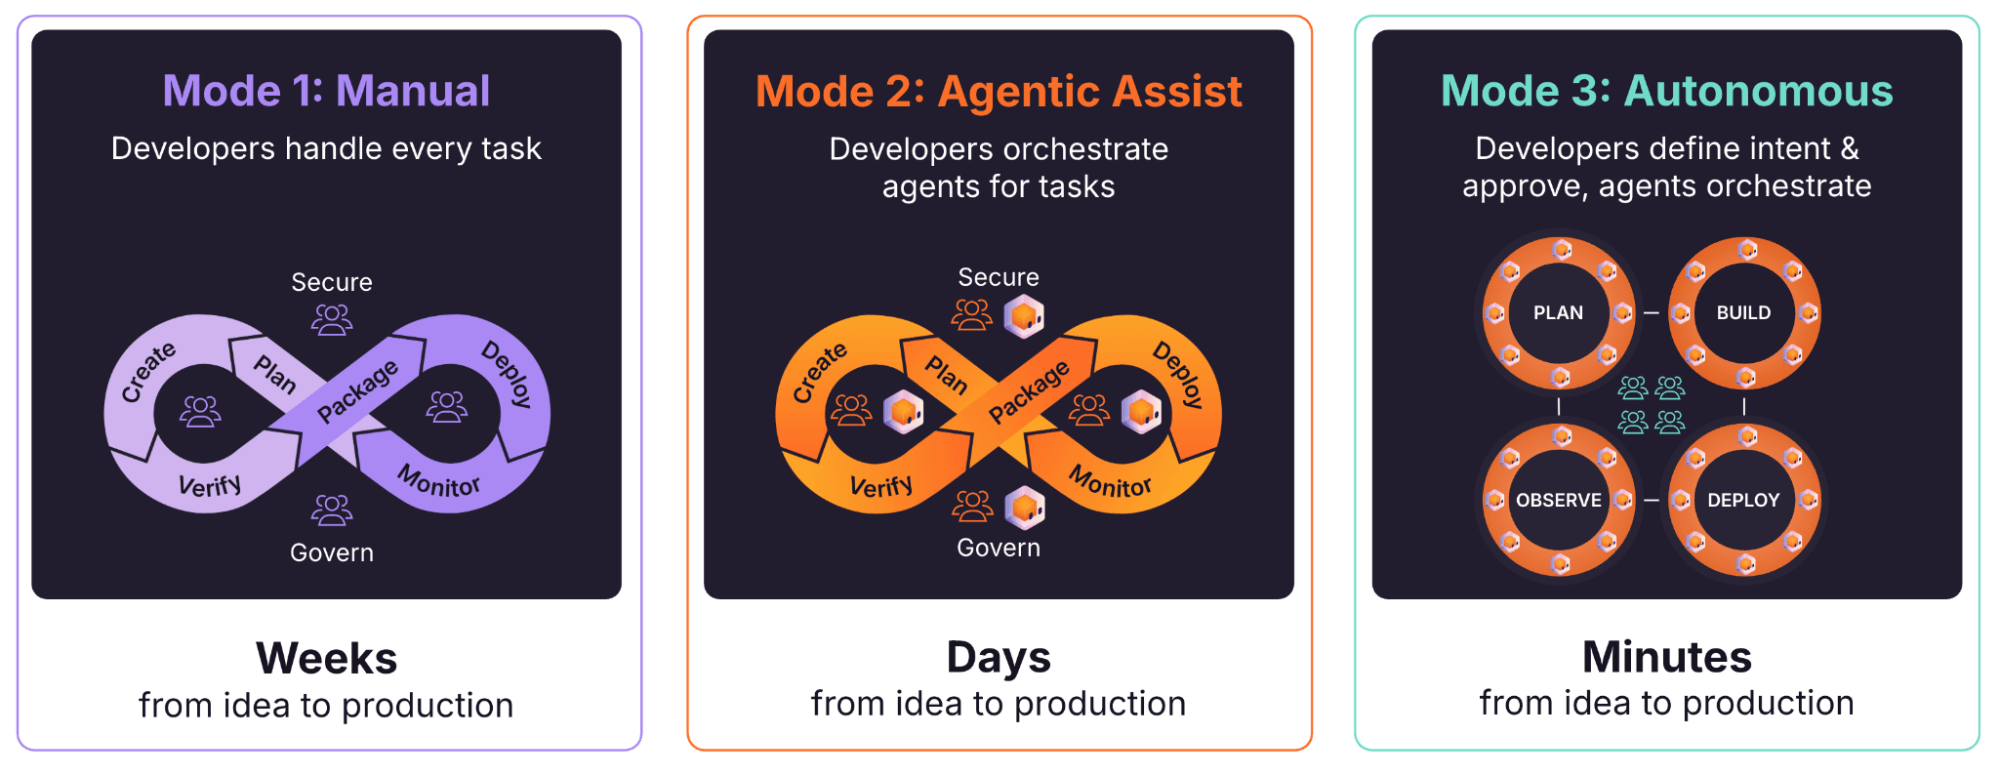
Mode 1 : systèmes legacy sous contrôle humain
Systèmes qui présentent des dépendances non documentées et dont les connaissances opérationnelles reposent encore sur les individus. Beaucoup resteront en grande partie sous contrôle humain jusqu'à leur mise hors service ou leur réécriture.
Mode 2 : développement accéléré par les agents
Les humains restent aux commandes tandis que les agents apportent leur aide pour la mise en œuvre, les tests, la migration, la revue, la documentation et l'analyse de sécurité. C'est là que se trouve aujourd'hui la majeure partie du développement en entreprise, et c'est là que, selon moi, se concentrera une grande partie de la valeur économique à court terme.
Il ne s'agit pas simplement d'une étape intermédiaire vers l'autonomie. L'un des avantages les plus précieux des agents pourrait bien être de rendre rentables des projets de modernisation qui étaient auparavant impossibles à justifier.
Mode 3 : développement autonome
Les agents gèrent la mise en œuvre tandis que les humains définissent les objectifs, les contraintes et assurent la supervision. La distinction essentielle ne se situe pas entre le développement de nouveaux systèmes et celui des systèmes existants. Elle réside dans le fait que l'exécution reste sous contrôle humain ou qu'elle peut fonctionner en toute sécurité en boucle fermée.
Une façon pratique de déterminer où se situe un système est de se poser les trois questions suivantes : un agent peut-il apporter un changement utile à partir du contexte disponible ? Ce changement peut-il être vérifié sans qu'une personne ait à lire chaque ligne ? S'il est erroné, le système le détecte-t-il ou une personne doit-elle intervenir ? Plus ces réponses dépendent d'une personne, plus la charge de travail reste proche du Mode 1, quelle que soit la capacité du modèle.
Tenter de faire passer de force chaque charge de travail au Mode 3 trop tôt risque d'être l'une des erreurs les plus coûteuses que les organisations puissent commettre au cours de cette transition.
Le pipeline gère la boucle interne
Une fois qu'Amplitude a réduit l'intégration continue frontend à moins de cinq minutes, le pipeline distant est devenu assez rapide pour que les ingénieurs puissent lancer de nombreuses tâches en parallèle et examiner les résultats à leur retour.
Stripe a atteint une architecture similaire par un autre chemin, en fournissant aux minions des environnements de développement isolés et prêts à l'emploi permettant à de nombreux jobs de s'exécuter simultanément sans interférer les uns avec les autres.
Aujourd'hui, la plupart des workflows d'agents de codage commencent encore sur un ordinateur portable. C'est un point de départ raisonnable, mais il est peu probable que ce soit là où l'architecture se terminera.
Dans un système agentique, le pipeline devient l'endroit naturel pour exécuter la boucle de développement interne :
générer → build → tester → valider → réviser → remédier → répéter
L'agent continue de travailler en fonction de ces signaux jusqu'à ce qu'il puisse produire un résultat qui n'est pas simplement du code plausible, mais un logiciel fonctionnel et vérifié qui satisfait les contraintes définies par l'organisation.
Des boucles internes plus rapides augmentent également le besoin de coordination. Un millier de modifications valides individuellement peuvent encore entraîner un système dans des directions contradictoires. À mesure que l'IA compresse les écarts entre les phases du cycle de développement logiciel, il est nécessaire d'assurer un alignement continu sur les objectifs plutôt que périodique.
Il existe des raisons architecturales qui expliquent pourquoi cette boucle doit être proche du dépôt et des systèmes qui l'entourent.
Le pipeline est déjà adjacent au code, au système de build, à l'infrastructure de tests, aux contrôles de sécurité, à la configuration de déploiement et à une grande partie de l'historique entourant une modification. Plus l'agent est proche de ces systèmes, moins il doit reconstruire du contexte via des appels distants répétés et des API fragmentées, et plus vite il peut recevoir des retours. Cet aspect est important, car le développement à la vitesse des machines peut transformer même de faibles latences et pertes de contexte en goulots d'étranglement au niveau du système.
Exécuter la boucle à cet endroit permet également de préserver les preuves autour du travail. L'identité qui a initié la modification, les politiques appliquées, les tests exécutés, les revues effectuées, la remédiation réalisée par l'agent et l'artefact livré peuvent tous rester connectés.
L'enjeu va bien au-delà de l'efficacité : c'est ce qui permet de garder la maîtrise d'une autonomie croissante.
Le pipeline passe d'une porte en fin de développement à un système qui exécute lui-même la boucle de développement.
Le développement agentique passe donc mieux à l'échelle là où l'exécution, le contexte et la gouvernance sont proches du travail. Plus un agent peut accéder rapidement au bon contexte, recevoir des retours déterministes et prouver ce qu'il a fait, plus il peut accomplir une part importante de la boucle en toute sécurité avant de transférer le travail à quelqu'un.
La question n'est plus simplement : « Le code a-t-il été compilé ? », mais : « Le changement était-il vraiment bon, et peut-on le prouver ? »
L'autonomie est contrôlée, et non accordée
À mesure que la capacité des modèles s'améliore, la gouvernance devient de plus en plus une contrainte déterminante sur l'autonomie.
Parmi les programmes d'entreprise que j'ai observés, ceux accusant un retard s'enlisent rarement parce que personne ne parvient à faire générer du code par un modèle.
Ils s'enlisent dans des questions plus fondamentales. Qu'est-ce que l'agent est autorisé à faire ? Comment prouver ses actions ? Qui est responsable lorsqu'il commet une erreur ?
L'architecture de Stripe illustre ce schéma. Les minions combinent des boucles d'agents en libre exploration avec des logiciels déterministes pour Git, le linting et les tests. Ils s'exécutent dans des environnements isolés, passent les vérifications locales avant le push, et exécutent sélectivement des tests issus d'une suite qui en compte plus de trois millions.
L'agent peut être créatif.
C'est le système qui décide où la créativité s'arrête.
Amplitude utilise un modèle de risque pour distinguer les tâches pouvant être fusionnées automatiquement de celles devant encore être relues par quelqu'un.
L'architecture de vérification de Spotify donne aux agents accès à la vérification sans exposer la mise en œuvre sous-jacente des vérificateurs, et exécute les contrôles requis avant qu'une pull request puisse être ouverte.
Aucune de ces organisations n'a résolu la question de la fiabilité avec un meilleur prompt. Elles ont combiné des modèles capables avec des portes déterministes, une isolation, des vérifications, des politiques et des preuves, et c'est ce qui permet à l'autonomie de s'étendre en toute sécurité.
Cela explique aussi pourquoi cette approche est plus difficile à adopter en dehors des entreprises technologiques possédant les meilleures ressources. La plupart des entreprises ne voudront pas inventer leur propre modèle d'autorisation d'agents, leur couche d'isolation, leur architecture de vérification et leur système de preuves. Elles s'attendront à en hériter une grande partie.
C'est de plus en plus ce que nous entendons chez GitLab lorsque nous parlons de rapidité contrôlée.
La rapidité sans contrôle finit par s'arrêter parce que l'organisation ne peut pas accepter le risque encouru. Le contrôle sans rapidité n'exploite pas la valeur de l'IA. Les deux doivent être conçus ensemble.
La responsabilité peut gagner en clarté
La disparition de la responsabilité dans la machine est l'une des préoccupations concernant le développement autonome. Cela peut se produire si le système est mal conçu. Mais le développement autonome peut aussi rendre la responsabilité plus explicite si l'identité, la politique, le contexte et les preuves sont préservés dans le cadre de l'exécution.
Les humains restent responsables de la définition des contraintes : la politique de sécurité, le seuil de performance, l'obligation de conformité, et ce que l'organisation a appris du dernier incident. Le plan de contrôle doit pouvoir prouver l'exécution face à ces contraintes.
La description par Amplitude de son approche SOC 2 est instructive. Son processus d'approbation automatisé repose sur des critères documentés, des décisions journalisées et un chemin de remplacement, plutôt que sur une personne qui doit approuver pour chaque modification qui remplit les conditions exigées. L'équipe passe de l'approbation de chaque action à la possession des critères selon lesquels les actions sont autorisées, ce qui peut être à la fois un travail plus conséquent et plus auditable.
La couche durable
Face à des agents dotés de capacités de plus en plus développées, il est possible que davantage du cycle de vie logiciel s'effondre dans le modèle et que tout ce qui l'entoure devienne une infrastructure standard. Je pense néanmoins que l'inverse est plus probable.
À mesure que les agents prennent en charge davantage de la boucle de mise en œuvre, la couche durable de l'entreprise gagne encore en importance. Le contexte, l'identité, la politique, la provenance, la vérification et la mémoire organisationnelle ne peuvent pas résider uniquement dans le modèle ou l'agent qui exécute le travail. Ils doivent subsister d'un modèle ou d'un agent à l'autre.
Et au fil du temps, je m'attends à ce que le cycle de vie du développement de produits utilise plusieurs modèles spécialisés.
Différentes tâches seront optimisées pour différents usages : qualité du raisonnement, latence, coût, sécurité, spécialisation de domaine ou lieu d'exécution du modèle. Certaines entreprises utiliseront des modèles de pointe. D'autres utiliseront des modèles plus petits ou des modèles à poids ouvert déployés plus près des données et de l'infrastructure du client. Le meilleur modèle pour la planification n'est peut-être pas le meilleur pour la revue de code, l'analyse de sécurité, les tests ou la remédiation.
C'est un schéma courant à mesure que les technologies mûrissent. Une capacité générale unique cède la place à une pile plus spécialisée optimisée pour différentes charges de travail.
Dans ce monde, le modèle n'est pas l'architecture durable. C'est un composant d'exécution.
Plus une entreprise utilise de modèles et d'agents, plus le contexte commun, les contrôles et l'historique qui les entourent deviennent précieux.
Les périmètres de ce que nous appelions traditionnellement le cycle de développement logiciel (SDLC) évoluent aussi.
Le SDLC a été construit autour d'individus faisant progresser le travail à travers une séquence d'étapes : planification, build, test, sécurisation, déploiement et exploitation. À mesure que l'IA compresse ces étapes en boucles agentiques continues, je m'attends à ce que la distinction entre développer un logiciel et développer le produit lui-même s'estompe.
Nous pouvons concevoir le modèle émergent comme un cycle de développement produit, ou PDLC : l'intention métier entre dans le système, les agents la transforment en logiciel, la vérification et la gouvernance déterminent ce qui peut avancer, les résultats de production alimentent la décision suivante, et la boucle recommence.
À une échelle suffisamment grande, cette boucle commence à ressembler moins à un processus de développement traditionnel et davantage à une usine logicielle : un système qui transforme en continu l'intention et les signaux métier en logiciel vérifié.
Mais une usine logicielle n'est pas simplement une collection d'agents autonomes. La couche durable qui la sous-tend préserve le contexte, l'identité, la politique, les preuves et la mémoire organisationnelle pendant que les modèles et les agents évoluent.
Contexte et provenance
The AI-Native SDLC Playbook d'Anthropic est utile parce qu'il rend la transition concrète. Il décrit l'intention, les spécifications et les plans devenant des artefacts lisibles par machine, les connaissances institutionnelles rendues accessibles à Claude, les hooks et les compétences appliquant des comportements, le MCP connectant les agents aux outils et l'historique des versions préservant les preuves du travail. Je pense que ce sont des schémas utiles, et de nombreuses organisations commenceront par là.
Chez GitLab, notre pari architectural est que le développement agentique nécessite une nouvelle architecture de plateforme, et pas seulement un meilleur modèle.
Cette architecture comprend quatre capacités essentielles : une plateforme d'agents, une exécution à l'échelle de la machine, un contexte durable et une gouvernance. J'y reviendrai ci-dessous.
Les entreprises utiliseront plus d'un modèle. Elles utiliseront des agents de plusieurs fournisseurs aux côtés d'agents qu'elles construisent elles-mêmes. Et de plus en plus, elles voudront construire des agents qui intègrent leurs propres workflows, expertise et politiques opérationnelles, en parallèle des excellents agents que les fournisseurs continueront à produire.
La plateforme doit donc prendre en charge les deux scénarios : les clients doivent non seulement pouvoir apporter les agents de leur choix, mais aussi construire, personnaliser et exploiter des agents qu'ils possèdent.
Ces agents agiront sur le code, la planification, la sécurité, l'intégration continue, le déploiement et les systèmes de production, souvent simultanément. Ils ne devraient pas avoir à être reconstruits parce qu'une organisation change son modèle ou son cloud préféré. Et le contexte, la politique, l'identité et l'historique de l'organisation ne devraient pas être dépendants du modèle, du fournisseur d'agents ou du fournisseur d'infrastructure en vogue à ce moment-là.
Le modèle doit être remplaçable. L'agent doit appartenir au client. La mémoire et les contrôles de l'organisation doivent perdurer.
C'est pourquoi je crois que la pression exercée sur l'architecture s'oriente vers une plateforme neutre vis-à-vis des modèles et des clouds, non vers un modèle, un fournisseur d'agents ou un cloud unique devenant le système de référence.
Il n'est pas nécessaire qu'un seul fournisseur possède chaque artefact impliqué dans la création de logiciels. L'identité peut être fédérée. Les événements peuvent circuler entre les systèmes. Le contexte peut être indexé. Les politiques peuvent être centralisées. Le MCP et d'autres interfaces ouvertes peuvent donner aux agents accès aux outils de l'entreprise. De nombreuses organisations construiront ainsi.
Avec ce schéma, il est plus difficile de préserver la chaîne de l'intention au résultat en passant par l'action pendant que des systèmes autonomes opèrent dans cet environnement.
Une exigence autorise une modification, qui s'exécute sous une identité et un régime de politique spécifiques. La vérification produit des preuves. Un déploiement livre la modification. La production produit un résultat. Ces relations forment un graphe causal.
Rien de nouveau ici. Ce qui change, c'est la fréquence à laquelle ces relations doivent rester intactes. À la vitesse du développement humain, reconstruire la provenance à travers plusieurs systèmes après coup est complexe, mais pas insurmontable.
À la vitesse des machines, la provenance fait partie du chemin d'exécution lui-même.
Lorsque les relations pertinentes résident nativement dans un système commun ou un plan de contrôle, un agent peut raisonner directement à travers elles. Lorsqu'elles résident dans plusieurs systèmes, un outil doit les reconstruire. C'est possible, mais ce scénario exige un travail autour de l'identité, de la synchronisation, de la cohérence des politiques, du mappage sémantique et des preuves. À un volume machine, la réconciliation elle-même peut devenir une contrainte systémique.
L'expérience de Spotify illustre le même problème à l'intérieur d'un code source. Au cours d'une migration, Honk a rencontré plusieurs frameworks de pipelines. Les frameworks plus standardisés étaient plus faciles à automatiser, tandis que les incohérences ont rendu bien plus ardue l'obtention d'un contexte fiable. À la vitesse humaine, un contexte incohérent crée de la friction. À la vitesse des machines, il détériore les résultats de façon répétée.
L'unité importante dans le développement autonome n'est plus l'artefact individuel. C'est la relation entre l'intention, le code, la politique, les preuves, le déploiement et le résultat.
C'est pourquoi je crois que la boucle interne du développement logiciel connaîtra une pression croissante pour mettre en place un plan de contrôle commun. Non pas parce qu'un seul fournisseur doit posséder tous les outils, mais parce qu'une autonomie digne de confiance exige que ces relations restent cohérentes pendant que les machines agissent à une échelle que les humains n'ont jamais atteinte. Les plateformes qui détiennent déjà nombre de ces relations possèdent un avantage structurel sur les systèmes qui doivent les reconstruire après coup.
Enregistrements plutôt que fichiers
Une pratique émergente dans le développement agentique consiste à capturer l'intention, les spécifications et les plans de mise en œuvre sous forme de fichiers Markdown ayant fait l'objet d'un commit dans un dépôt.
Cette intuition me semble bonne. Rendre l'intention explicite, versionnée et lisible par les humains et les agents crée une valeur immédiate.
Mais il existe une distinction importante entre un fichier et un enregistrement gouvernable. À l'échelle d'une entreprise, le système doit être capable de répondre à des questions qu'un fichier seul n'est pas en mesure de faire :
- Qui peut le modifier ?
- Dans quel état se trouve-t-il ?
- Qui l'a approuvé ?
- Quelle version de la politique a été appliquée ?
- Quel déploiement en a résulté ?
- Comment interroger dix mille de ces enregistrements ?
Les équipes peuvent recréer ces capacités via des conventions autour de Markdown, mais ce sont précisément les capacités que les systèmes de référence ont passé des années à développer.
La meilleure architecture pourrait présenter Markdown comme une interface pour les agents tout en maintenant un enregistrement structuré et gouverné en dessous.
L'interface peut rester simple, au contraire du système en dessous.
Les agents doivent appartenir à l'organisation
Les agents ont besoin d'un contexte sur la façon dont une organisation construit des logiciels : structure des dépôts, conventions de codage, commandes de build, pratiques de test, règles d'architecture et modes de défaillance connus.
Spotify appelle ce travail l'ingénierie de contexte et l'a jugé essentiel pour produire des pull requests fiables et fusionnables sur de véritables codes sources. Au fur et à mesure que ces connaissances s'accumulent, elles deviennent un actif organisationnel.
Ce scénario vaut également de plus en plus pour l'agent lui-même.
Un agent d'entreprise peut intégrer des années d'instructions accumulées, de workflows, d'accès aux outils, de critères d'évaluation et de politiques opérationnelles. Au fil du temps, ce savoir peut devenir une partie de la propriété intellectuelle la plus précieuse de l'organisation d'ingénierie.
Ces connaissances doivent appartenir à l'organisation, et non à un fournisseur de modèles, un fournisseur de cloud ou un environnement d'exécution propriétaire.
Il existe une autre raison pour laquelle la propriété importe : elle permet au système de s'enrichir avec le temps.
Chaque fois qu'un agent agit, l'organisation produit des preuves sur ce qui a fonctionné et ce qui n'a pas fonctionné. Quels changements ont été acceptés ? Lesquels ont été rejetés ? Où un humain est-il intervenu ? Qu'est-ce qui a échoué en production ? Quelles contraintes ont détecté le problème ?
Préservées dans le temps, ces preuves deviennent un ensemble d'évaluations internes ancré dans le code source et les résultats propres à l'organisation, pas un benchmark public. L'organisation peut l'utiliser pour évaluer les modèles, améliorer ses agents, affiner leurs instructions et workflows, et déterminer où une autonomie accrue est réellement justifiée.
Nous obtenons ainsi une boucle de rétroaction : l'agent exécute le travail, le système mesure le résultat, et ce que l'organisation apprend améliore la prochaine génération d'agents.
Cela prolonge l'idée que l'apprentissage se transforme en code. L'apprentissage peut devenir des tests et des politiques, mais aussi des évaluations, du contexte et des agents améliorés.
Ce n'est pas un argument contre un fournisseur particulier. Nous nous appuyons aujourd'hui sur les modèles d'Anthropic et prévoyons de continuer à le faire. Un client utilisant Claude Code doit pouvoir continuer à l'utiliser, avec le même contexte d'entreprise, la même identité et la même piste d'audit que tout agent que nous construisons nous-mêmes.
L'essentiel est que les clients doivent pouvoir choisir un modèle, le changer, utiliser différents modèles pour différentes tâches et exécuter leurs agents sur l'infrastructure que leur activité exige. Ils doivent également pouvoir apporter des agents d'autres fournisseurs et leur donner accès au même contexte et aux mêmes contrôles d'entreprise.
AGENTS.md est un exemple de format ouvert permettant de fournir des instructions de projet et du contexte aux agents de codage. GitLab le prend en charge, et nous continuerons à prendre en charge des formats ouverts tels que celui-ci, car les connaissances accumulées d'une organisation doivent rester portables si cette organisation change de modèles, d'agents ou de fournisseurs.
Le principe importe davantage que le nom du fichier.
Possédez l'agent. Possédez ses instructions. Possédez le contexte dont il apprend. Conservez les modèles et l'infrastructure qui se trouvent en dessous comme options.
Tout le monde peut livrer des logiciels
L'un des résultats les plus intéressants de l'expérience d'Amplitude ne concernait pas les ingénieurs. Après avoir amélioré sa configuration de développement, sa validation et sa revue, des designers, des chefs de produit et des spécialistes en marketing ont commencé à procéder à des modifications de code. Les non-ingénieurs sont passés de pratiquement zéro pull request à environ 5 %.
C'est une version précoce d'un changement qui, selon moi, devrait gagner en importance. À mesure que la mise en œuvre devient moins coûteuse, la frontière entre décider ce qu'il faut construire et démarrer la construction commence à s'effacer. Les chefs de produit peuvent transformer l'intention en logiciel fonctionnel. Les designers peuvent passer de prototypes à la mise en œuvre. Les ingénieurs peuvent opérer à un niveau d'abstraction supérieur sur l'ensemble du produit. Et les personnes extérieures aux organisations R&D traditionnelles peuvent de plus en plus construire des solutions directement à partir de l'expertise qu'elles possèdent déjà.
Je pense que Builder est un terme utile pour décrire ce rôle élargi. Un Builder peut être un ingénieur, un designer, un chef de produit, un expert en sécurité, un spécialiste en marketing ou un expert de domaine. Ils partagent tous la capacité d'exprimer une intention, de diriger des agents, d'évaluer le résultat et de transformer une idée en un élément fonctionnel.
C'est aussi une partie du glissement vers le PDLC décrit précédemment. À mesure que la distance entre l'intention produit, le design, la mise en œuvre et les retours se réduit, le développement logiciel devient moins une transmission spécialisée au sein de l'ingénierie et davantage une boucle continue de construction de produit.
Cela ne signifie pas que l'expertise disparaît ou que tout le monde devient ingénieur. Le contraire peut être vrai. À mesure que les agents absorbent davantage du travail de mise en œuvre, une expertise dans un domaine et le jugement deviennent plus précieux. La personne supervisant un système agentique n'est peut-être pas un responsable d'ingénierie gérant des agents de codage. Il peut s'agir d'un expert dans un domaine capable d'exprimer ce qui devrait se passer et de reconnaître si le résultat est correct.
Il en résulte un groupe bien plus large de personnes capables de créer des logiciels sans que le jugement d'ingénierie devienne pour autant abondant.
L'attention humaine rare se déplace vers le haut : vers l'intention, l'architecture, les contraintes, les compromis complexes, les exceptions et l'évaluation qui vise à déterminer si le système a produit le résultat que l'organisation voulait réellement.
Le travail de construction logicielle s'étend au-delà de l'ingénierie, au contraire du besoin de jugement.
L'intégration s'étend vers l'extérieur
Rien de tout cela n'indique pour autant que l'intégration cesse d'avoir de l'importance. Je m'attends à ce que son centre de gravité se déplace.
À l'intérieur de la boucle d'exécution haute fréquence, une intégration plus étroite devient plus précieuse car les agents dépendent de retours rapides, d'une identité cohérente, d'un contexte partagé et d'une politique applicable.
En dehors de cette boucle, l'intégration devient encore plus importante car l'intention qui guide le logiciel trouve de plus en plus son origine ailleurs dans l'entreprise.
L'assistance client traite les problèmes des clients. Le CRM gère les engagements. Les plateformes de données suivent l'utilisation et les résultats métier. L'observabilité décrit l'état de la production. Les systèmes de conformité définissent les obligations. Ces systèmes fournissent des signaux, une intention et des contraintes, et le plan de contrôle du développement les transforme en action gouvernée.
Au fil du temps, je m'attends à ce que la distance entre un signal métier et une réponse logicielle se réduise considérablement.
La plateforme de développement la plus importante dans ce monde pourrait donc être définie moins par le nombre d'outils de développement qu'elle remplace, et davantage par son efficacité à connecter l'exécution logicielle gouvernée aux systèmes qui décrivent les besoins de l'entreprise.
La nouvelle architecture de plateforme
Cet avenir nécessite une architecture de plateforme construite autour de quatre capacités :
Plateforme d'agents : la capacité à créer, personnaliser et opérer des agents que l'organisation possède, en utilisant les modèles et l'infrastructure de son choix, tout en prenant en charge les agents que les clients apportent d'ailleurs.
Exécution : Git de nouvelle génération, gestion des artefacts, CI/CD et capacité à construire, tester, déployer et opérer des logiciels à l'échelle humaine et machine.
Contexte : une image cohérente de l'exigence, du code, de l'historique, de la priorité métier et des contraintes entourant le travail.
Gouvernance : des périmètres applicables autour de la sécurité, de la conformité, de la qualité, de l'identité et des autorisations, ainsi que la visibilité dont les personnes ont besoin pour comprendre ce que les agents ont fait, pourquoi ces actions étaient autorisées, et où l'attention humaine est requise.
À mesure que l'autonomie augmente, la gouvernance devient moins une question d'approbation de chaque action et davantage une question d'aide aux personnes pour comprendre et piloter les exceptions. Les politiques et les tests automatisent les décisions que l'organisation a déjà prises ; les cas plus difficiles sont ceux que personne n'avait anticipés.
La contrainte ultime relative à l'autonomie n'est peut-être pas de savoir si l'agent peut agir, mais de savoir si une personne peut comprendre et piloter ce que font des centaines d'agents simultanément.
Ces quatre couches architecturales se renforcent mutuellement. Les agents agissent via la couche d'exécution. L'exécution crée des signaux qui enrichissent le contexte. Un meilleur contexte renforce les capacités des agents et la précision de la gouvernance. Une gouvernance plus solide permet à ces agents d'opérer avec une autonomie accrue.
Les entreprises auront besoin que ces capacités fonctionnent comme une plateforme cohérente, même lorsque de nombreux modèles, clouds, produits et agents différents interviennent en arrière-plan.
Implications en pratique
Ces principes architecturaux ne sont pas destinés à un avenir autonome lointain. Ils changent déjà ce que nous construisons.
Dans notre article dédié à l'Acte 2 de GitLab, nous avons décrit plusieurs paris architecturaux fondés sur l'hypothèse que le développement logiciel fonctionnerait de plus en plus à l'échelle des machines. Lors de l'événement GitLab Transcend en juin, nous avons présenté une démonstration des premiers éléments de cette architecture.
Les clients ont besoin d'un endroit pour construire et exécuter des agents qu'ils possèdent. GitLab Duo Agent Platform est notre plateforme pour créer, personnaliser et opérer ces agents autour des workflows et de l'expertise propres à une organisation. Les clients peuvent choisir les modèles qui les sous-tendent et les exécuter sur l'infrastructure que leur activité exige, tout en continuant à utiliser des agents externes à leurs côtés. L'objectif n'est pas de forcer chaque entreprise à utiliser un seul écosystème d'agents, mais de donner aux clients un endroit pour construire des agents qu'ils peuvent posséder et faire évoluer sans être dépendants d'un seul modèle ou cloud.
L'exécution doit fonctionner à l'échelle des machines. Les agents clonent, créent des branches, réessaient et déclenchent des pipelines à des volumes pour lesquels l'architecture de contrôle de version traditionnelle n'a jamais été conçue. Notre contrôle de version de nouvelle génération est en cours de reconstruction autour de cette réalité, avec notamment des modèles d'accès côté serveur permettant à un agent de récupérer ce qu'une tâche nécessite réellement plutôt que de déplacer plusieurs fois un dépôt entier. Lors de tests internes, ces changements ont produit une exécution des tâches jusqu'à 50 fois plus rapide tout en déplaçant considérablement moins de données.
Le contexte doit devenir une infrastructure. GitLab Orbit relie le code, les éléments de travail, les pipelines, les déploiements et les signaux de production dans un graphe de contexte couvrant l'ensemble du cycle de vie logiciel. Les agents peuvent interroger directement ces relations plutôt que de les reconstruire via des dizaines d'appels déconnectés. Fait important, ce contexte n'est pas réservé aux propres agents de GitLab. Les agents tiers peuvent utiliser la même mémoire organisationnelle.
La gouvernance doit entourer l'agent, et non résider dans son prompt. Governance for Agents est conçu pour appliquer des contrôles d'identité, de politique, d'approbation et d'audit aux actions des agents, afin que les organisations puissent accroître l'autonomie de ces derniers sans sacrifier les preuves ni la responsabilité.
Ce sont des projets d'ingénierie différents, mais ils reposent sur le même postulat :
Si la mise en œuvre devient abondante, la plateforme qui la sous-tend doit permettre aux entreprises de construire et d'apporter des agents, puis de leur donner à tous une couche commune d'exécution, de contexte et de contrôle à l'échelle des machines.
Les actions à entreprendre dans les 90 prochains jours
Mesurez le coût par modification acceptée. Suivez le temps écoulé entre la modification générée et celle acceptée, puis décomposez-la entre environnement, intégration continue, revue, remédiation et gouvernance. De nombreuses équipes constateront que la génération représente déjà une petite partie du total.
Mesurez la durée de votre intégration continue. Si un pipeline complet prend bien plus de cinq minutes, l'améliorer peut avoir plus d'impact que de changer de modèle.
Documentez les critères, pas seulement les approbations. Choisissez une classe de modifications à faible risque et définissez les éléments qui garantiraient un merge sûr sans intervention humaine. C'est le début d'une gouvernance exécutable.
Assurez la portabilité du contexte. Consignez les instructions de dépôt et les connaissances opérationnelles dans un format ouvert et versionné que les personnes et les agents peuvent utiliser.
Choisissez quels signaux métier doivent entrer directement dans la boucle de développement. Les systèmes d'assistance, d'observabilité et de conformité contiennent de plus en plus l'intention et les contraintes. Décidez quels signaux doivent devenir du travail logiciel gouverné sans qu'une personne ait à les retranscrire.
Perspectives
La génération de code se banalise de plus en plus. Cela ne signifie pas que le développement logiciel devient gratuit. Cela signifie que l'économie change.
L'unité utile n'est pas le coût par ligne de code.
C'est le coût par modification acceptée.
À mesure que la génération devient moins coûteuse, tout ce qui l'entoure devient proportionnellement plus important : environnement, contexte, vérification, gouvernance et preuves.
Cela change également l'endroit où se porte le jugement humain rare. Le jugement d'ingénierie ne devient pas abondant parce que la mise en œuvre l'est. L'attention humaine se déplace vers le haut : vers l'architecture, l'intention, les contraintes, les exceptions difficiles et l'évaluation du fait que le système a produit le résultat que l'organisation souhaitait.
Et cela change l'endroit où la valeur stratégique s'accumulera dans la pile de développement logiciel. Pendant 60 ans, la mise en œuvre était suffisamment rare pour que l'ingénierie logicielle tourne largement autour de la protection de la capacité des développeurs et de la limitation du coût du changement. L'IA modifie cette contrainte.
Quand la mise en œuvre devient abondante, la confiance devient rare.
La confiance exige davantage qu'un modèle produisant une réponse plausible. Elle exige des preuves que le logiciel a été produit en fonction des bonnes contraintes et s'est comporté comme l'organisation l'avait prévu. Les entreprises peuvent assembler ces capacités à partir de nombreux produits, et beaucoup le feront. Mais à mesure que l'activité des machines augmente, les plans de contrôle fragmentés créent un problème de réconciliation de plus en plus coûteux.
La pression exercée sur l'architecture ne pousse donc pas nécessairement vers un seul fournisseur qui possède tous les outils.
Elle pousse vers une plateforme neutre vis-à-vis des modèles et des clouds où les entreprises peuvent apporter les agents de leur choix, construire et personnaliser des agents qu'elles possèdent, et leur donner à tous une couche commune d'exécution, de contexte et de gouvernance.
C'est l'opportunité que nous voyons pour GitLab.
Le modèle peut changer. Le cloud peut changer. L'agent peut venir d'un fournisseur ou être construit par le client.
L'intelligence, le contexte et les contrôles de l'organisation doivent survivre à tous ces changements.
Stripe, Spotify et Amplitude ont montré ce que des organisations d'ingénierie exceptionnelles peuvent construire par elles-mêmes. Le playbook d'Anthropic montre désormais à quelle vitesse le modèle opérationnel autour du développement logiciel commence à changer. La plupart des entreprises ne disposeront pas d'une équipe plateforme pour recréer de zéro tous ces outils. Elles auront besoin d'en hériter une grande partie.
L'ingénierie logicielle a passé 60 ans à protéger une ressource rare. Elle passera la prochaine décennie à contrôler une ressource abondante.
C'est un problème plus intéressant à résoudre.
Sources
- GitLab, Acte 2, 11 mai 2026. about.gitlab.com/blog/gitlab-act-2
- GitLab, une plateforme conçue pour l'ère de l'ingénierie agentique, 10 juin 2026, avec vidéos de démonstration de GitLab Transcend. about.gitlab.com/fr-fr/blog/gitlab-transcend-announcements
- Anthropic, The AI-Native SDLC Playbook, 21 août 2026. claude.com/blog/the-ai-native-sdlc-playbook
- Amplitude EPD, Speedrunning Software: How We 3×'d PRs in 6 Months. amplitude.com/3x
- Stripe, Minions: Stripe's one-shot, end-to-end coding agents. Partie 1 et Partie 2
- Spotify Engineering, Background Coding Agents. Partie 1, Partie 2, Partie 3, Partie 4
AGENTS.md, un format ouvert pour guider les agents de codage- Goldratt, Theory of Constraints. tocinstitute.org
En savoir plus
Afficher tous les articles du blog
Donnez-nous votre avis
Cet article de blog vous a plu ? Vous avez des questions ou des retours ? Donnez votre avis en créant un nouveau sujet sur le forum de la communauté GitLab.
Faites-nous part de vos commentaires