Veröffentlicht am: 19. August 2026
12 Minuten Lesezeit
Die Kosten vollständiger History-Clones vermeiden
Wie die Git Clone Override Policy Klon-Optimierungen wie Shallow- und Partial-Clones über eine TOML-Datei im Repository automatisch durchsetzt.
Vieles spricht dafür, git clone für eine reine Client-Angelegenheit zu halten, doch die Einstellungen dieses Aufrufs wirken auf die Serverseite und auf alle Netze dazwischen. Bei einem vollständigen History-Clone muss der Server die gesamte Historie durchlaufen, daraus eine Pack-Datei bauen (genau das tut "counting objects") und sie über die Leitung schicken. Der Client packt alles wieder aus und checkt einen kompletten Arbeitsbaum aus. Jede Schicht zahlt für die Größe dieser Anfrage: Client-CPU, Netz, die Pack-Berechnung des Git-Servers und der Speicher. Fällt die Anfrage kleiner aus, wird der gesamte Stack günstiger, nicht nur der eigene Rechner.
Agentische KI verschärft das auf eine Weise, die gewöhnliche Entwicklungsabläufe nicht kennen. Ein Agent, der am Repository arbeitet, klont weit häufiger und weit unvorhersehbarer, als ein Mensch es je täte. Ist der vollständige History-Clone die Voreinstellung, fällt dieser Aufwand nun im Maßstab agentischer Nutzung an.
GitLab arbeitet intensiv daran, große Repositorys serverseitig schneller auszuliefern. Man kann aber auch ändern, wonach man fragt. Optionen wie Shallow Clones (--depth=1), Single-Branch-Clones und Partial Clones (--filter=blob:none) holen nur das, was ein Job tatsächlich braucht. Eine präzisere Anfrage senkt unmittelbar Spitzenlast, Störanfälligkeit, Wartezeit und Kosten. Und jede künftige Verbesserung im Backend setzt auf diesen schlankeren Anfragen auf.
In Git-Workflows systematisch optimieren habe ich gezeigt, wie Git Much Faster genau jene Einstellungen durchmisst, die Clone-Zeiten um bis zu 93 % und Speicherbedarf um bis zu 98 % senken: Kompression abschalten, den HTTP-Puffer vergrößern, Shallow und Partial Clone, dazu Sparse Checkout, das Binärdateien überspringt. Gute Zahlen. Die Sache hat nur einen Haken: Jede Stelle, die das Repository klont, muss sorgfältig um viele Zeilen Optimierungscode ergänzt werden. Auf dem Laptop, im CI-Job, in der Sandbox eines Agenten: Jede dieser Stellen ist eine eigene Gelegenheit, es zu vergessen.
Das ist keine Automatisierung. Das ist Hoffnung.
Dieser Artikel zeigt, wie sich die Git Clone Override Policy einsetzen lässt, um Klon-Optimierungen automatisch durchzusetzen und Kosten zu senken.
Wo diese Kosten am stärksten zu Buche schlagen
Agentische KI ist der neueste und am schnellsten wachsende Faktor, aber nicht der einzige, an dem vollständige History-Clones die Softwarebranche teuer zu stehen kommen:
- Monorepos: Viele Projekte in einem Repository bedeuten, dass jeder Clone weit mehr zieht, als ein einzelnes Team je braucht.
- Lange, verwinkelte Git-Historie: Über Jahre angesammelte Commits summieren sich zur Gesamtgröße, selbst wenn der aktuelle Baum überschaubar bleibt.
- Medien, Binärdateien und Embedded-Projekte: Firmware-Images, Vendor-SDKs und Design-Assets direkt in der Versionskontrolle blähen ein Repository auf, wie es Quellcode allein nie täte.
- CI/CD-Pipelines: Ein frischer Clone bei jedem Job, tausendfach am Tag, macht aus einer kleinen Ineffizienz pro Clone eine große wiederkehrende.
- Data Science und Machine-Learning-Datensätze: Große Datendateien unter Git-Verwaltung wiegen ebenso schwer wie jeder andere übergroße Blob.
- Entfernte Entwicklungsumgebungen: Cloud-gehostete oder kurzlebige Umgebungen wollen leichtgewichtig starten, replizieren aber weiterhin standardmäßig das ganze Repository.
- Agentische KI: viel mehr Klon-Anfragen, dabei weit unvorhersehbarer als jeder von Menschen getriebene Ablauf.
Die Optimierung unumgehbar machen
Die Lösung ist kein besseres README, das erklärt, welche Flags zu setzen sind. Sie besteht darin, die Entscheidung ganz aus den Händen Einzelner zu nehmen: die Policy als Code ins Repository selbst legen und ein kleines Programm sie durchsetzen lassen.
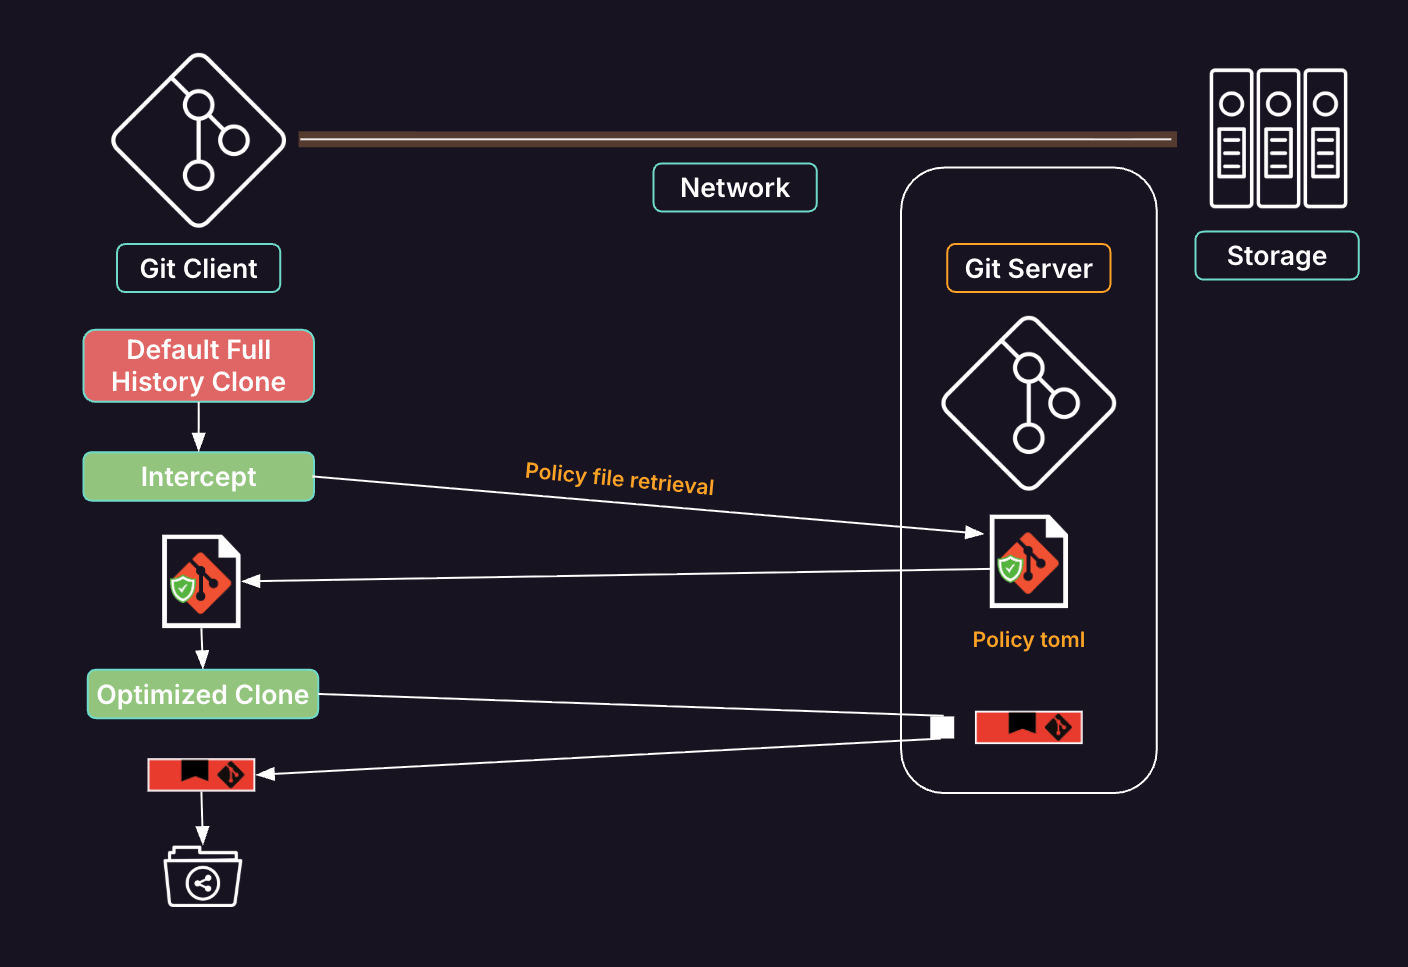
Genau das tut die Git Clone Override Policy. Eine Datei .afullhistorycloneoverridepolicy.toml ins Repository legen, und ein schlankes Go-Binary fängt ausschließlich ein nacktes git clone URL ab, also die schlichte, voreingestellte Anfrage über die volle Historie. Sobald selbst eine Option dazukommt (--depth 1, --filter, was auch immer), geht das Binary davon aus, dass ohnehin optimiert wird, und reicht den Befehl unverändert durch. Gar keine Policy-Datei im Repository? Dasselbe: sauber durchgereicht an einen gewöhnlichen Clone. Der einzige Fall, den es je anfasst, ist der, den alle für einen Fehler halten: die unqualifizierte Voreinstellung.
Greift es doch ein, läuft folgende Abfolge: Zuerst holt es die Policy-Datei, dann durchläuft es einen fest vorgegebenen 13-Schritt-Prozess. Der klont das Repository shallow und partial, richtet Sparse Checkout für das Überspringen von Binärdateien ein (Bilder, Archive, Medien, Schriften und mehr) und legt dieselbe abgestimmte Git-Konfiguration aus Git Much Faster an, alles bevor eine einzige Zeile Quellcode auf der Platte landet.
Wie maximale Optimierung aussieht
Ein Blick auf die Befehle, die eine maximale Optimierung eines Git-Clones verlangt.
1. Die Repository-Hülle selbst bauen statt git clone.
So lassen sich zahlreiche Git-Konfigurationseinstellungen setzen, die den Dateiumfang der ersten Klon-Anfrage festlegen.
      mkdir my-repo && cd my-repo
git init
git remote add origin https://example.com/group/my-repo.git
2. Die Git-Konfiguration auf große Übertragungen abstimmen, begrenzt auf dieses Repository.
      git config --local core.compression 0
git config --local http.postBuffer 1024M
git config --local http.lowSpeedLimit 1000
git config --local http.lowSpeedTime 300
git config --local pack.windowMemory 256m
git config --local pack.packSizeLimit 256m
git config --local pack.threads 4
3. Partial Clone einschalten, weil gleich mit --filter geholt wird.
      git config --local extensions.partialClone origin
git config --local remote.origin.promisor true
git config --local remote.origin.partialclonefilter blob:none
4. Die Fetch-Refspec auf die eine gewünschte Ref eingrenzen statt auf jeden Branch der Gegenstelle.
git config --local remote.origin.fetch "+refs/heads/main:refs/remotes/origin/main"
Ohne diese Anpassung steht remote.origin.fetch automatisch auf +refs/heads/*:refs/remotes/origin/*. Jeder Fetch und auch der erste Clone zieht dann die Ref-Zeiger sämtlicher Branches der Gegenstelle. Mit der Änderung beschränken sich Fetch-Operationen auf den Branch main, und Git verfolgt oder aktualisiert keine Refs anderer entfernter Branches mehr.
Es sind also weniger Refs auszuhandeln und zu aktualisieren, was den Aufwand pro Fetch senkt, besonders bei Repositorys mit Hunderten von Branches.
5. Shallow holen, Blob-Inhalte zurückstellen.
git fetch --depth=1 --filter=blob:none origin main
Diese Kombination aus Tiefe und Filter ergibt die kleinstmögliche Erstübertragung: die Baumstruktur eines einzigen Commits, keinerlei Blob-Daten, bis Dateien ausgecheckt werden. Der Vorteil zeigt sich vor allem bei Repositorys mit großen Dateien oder viel Historie.
6. Sparse Checkout einschalten und jeden Binärdateityp ausschließen, der für die Quellcodearbeit nicht gebraucht wird.
      git sparse-checkout init --cone
cat >> .git/info/sparse-checkout <<'EOF'
/*
!*.png
!*.PNG
!*.jpg
!*.JPG
!*.pdf
!*.PDF
!*.zip
!*.ZIP
!*.mp4
!*.MP4
!*.exe
!*.EXE
EOF
Die tatsächliche Policy schließt über 30 Endungen aus, quer über Bilder, Dokumente, Archive, Medien, kompilierte Binärdateien und Design-Dateien, jeweils in Groß- und Kleinschreibung. Oben steht nur ein Ausschnitt.
7. Die Ref auschecken.
git checkout main
Alle sieben Stufen in genau dieser Reihenfolge gegen www.gitlab.com ausgeführt, und man landet bei denselben 110 MB statt bei 9,5 GB. Stimmt die Reihenfolge nicht (Fetch vor dem Eingrenzen der Refspec, Sparse Checkout nach dem Checkout statt davor), ist die Optimierung bestenfalls verpufft und schlimmstenfalls genau das geholt, was vermieden werden sollte. Diese Genauigkeit bei jedem Clone zu wiederholen, durch jede Person und jede Pipeline, ist genau das Disziplinproblem vom Anfang dieses Beitrags. Die Git Clone Override Policy erfindet hier keine neue Technik. Sie stellt nur sicher, dass diese sieben Stufen jedes Mal in der richtigen Reihenfolge laufen, ohne dass sie jemand im Kopf haben muss.
Automatisierung als Ausweg
Git-Clients laufen in großer Zahl und weit verteilt. Ein präziser, zweckgebundener Satz von Klon-Optimierungen lässt sich deshalb nur mit Automatisierung verlässlich ausrollen, ob von Hand oder fest eingebaut in jeden CI-Job und jede Agenten-Sandbox.
Was, wenn sich dieser Ablauf über automatische Policies erzwingen ließe, statt darauf zu setzen, dass alle sieben Stufen jedem präsent sind? Genau dafür gibt es bereits eine funktionierende Umsetzung: eine TOML-Policy-Datei, die neben dem Code im Repository liegt, dazu einen Client, der jeden git clone-Aufruf abfängt, bevor er das Netz erreicht. Die Policy einmal hinterlegen, und jeder Clone bekommt die optimierte Abfolge automatisch statt auf Zuruf, ob von Menschen, CI-Jobs oder Agenten. Eine Policy-Datei erlaubt zudem die Feinabstimmung, die je nach Zweck nötig wird. Die Vorgabe oben zielt auf das Zählen von Codezeilen, dafür genügt eine verlässliche Kopie aller vorhandenen Textdateien. Dieselbe Software zu bauen kann mehr Dateien verlangen, weil Grafiken in die Oberfläche kompiliert werden, und manche Builds brauchen mehr Git-Historie, um Commit-Nachrichten für Release Notes zu finden.
Ein kleines, portables Go-Binary und eine Policy-Datei im Repository
Der Interceptor selbst ist ein einzelnes, in sich geschlossenes Go-Binary und kein Shell-Skript, das mit sed und Hoffnung zusammengehalten wird. Diese Entscheidung bringt einige Vorteile mit sich, die eine Erwähnung wert sind.
Es läuft unter Linux, macOS und Windows, jeweils für amd64 und arm64: eine Codebasis statt einer Bash- und einer PowerShell-Fassung, die auseinanderdriften. Getestet ist es in allen Shells, die einem begegnen dürften, von CMD und PowerShell über Git Bash bis WSL. Die einzige Laufzeitabhängigkeit ist ein echtes git-Binary im PATH.
Intern gliedert es sich in sechs kleine, einzeln testbare Teile (Policy-Parsing, den Interpreter der festen Abfolge, die Ausführung der Git-Befehle, Logging, Plattformerkennung und den Einstiegspunkt für alle vier Aufrufarten), statt alles in einer großen Funktion zu erledigen.
Diese Beispielkonfiguration vermittelt einen Eindruck davon, was sich derzeit einstellen lässt.
      schema_version = 2

[policyinfo]
description = "The most optimal latest-code-only clone for AI agents (that do not need git history) or counting lines of code."
OptimalForAIAgents = true

[git_config]
"core.compression"   = 0
"http.postBuffer"    = "1024M"
"http.lowSpeedLimit" = 1000
"http.lowSpeedTime"  = 300
"pack.windowMemory"  = "256m"
"pack.packSizeLimit" = "256m"
"pack.threads"       = 4

[fetch]
flags = ["--depth=1", "--filter=blob:none"]

[sparse_checkout]
enabled  = true
# conemode 'auto' is processed by the solution code to be either 'cone' or 'no-cone' when passed to git
conemode = "auto"
includes = ["/*"]
excludes = []
exclude_extensions = [
  "png", "jpg", "jpeg", "gif", "svg", "ico", "webp",
  "pdf", "doc", "docx", "xls", "xlsx", "ppt", "pptx",
  "zip", "tar", "gz", "jar",
  "mp4", "mp3", "mov",
  "exe", "dll", "so", "woff", "woff2",
  "ttf", "otf", "psd", "sketch", "fig", "dmg", "eps",
]
case_variants = "both"
Deklarative Konfiguration statt Code
Infrastructure as Code senkt Komplexität und erhöht Standardisierung und Sicherheit, indem es einen sonst wuchernden, stark variierenden Bestand an Teamcode auf eine deklarative Konfigurationsdatei und eine Engine eindampft, die sie verarbeitet. Dieses wirksame Muster wiederholt sich hier, mit allen seinen Vorteilen:
- Standardisierung unvertrauter Abläufe (ausgesprochen detaillierte Git-Befehle)
- Vermeidung von Komplexität
- leichte Übernahme durch vorhandenen Spezialcode zum Klonen (etwa VS-Code-"Clones", die das Git-Binary nicht nutzen)
- weniger Fehler und Sonderfälle, als wenn alle sich etwas Eigenes ausdenken
- einheitliche Umsetzung über Kontexte hinweg (CI-Clones, Entwicklungsumgebungen, KI-Sandboxes)
- bessere Prüfbarkeit
- Konfigurationsdateien lassen sich von anderer Automatisierung erzeugen und bearbeiten
- mehr Sicherheit, weil viele Wege für Code-Injection wegfallen
Der Interpreter kann ausschließlich auf Konfiguration reagieren: Git-Config-Schlüssel und -Werte, Flags für Fetch und Checkout, Include- und Exclude-Listen für Sparse Checkout sowie eine kleine Menge an Post-Clone-Hooks, die an einfache Bedingungen geknüpft sind. Beliebige Zusätze in der Konfiguration kennt die Engine nicht und ignoriert sie. Was eine Policy tun wird, lässt sich allein durch Lesen prüfen.
Drei Einsatzarten der Git Clone Override Policy
Vom geringsten bis zum größten Eingriff:
| Modus | Befehl | Adminrechte | Geeignet für |
|---|---|---|---|
| Zero-Footprint-CLI | ./git-clone-override-policy clone URL | Nein | CI-Jobs, Agenten, einzelne Rechner |
| Git-Alias | git cloneusingpolicy URL | Nein | Entwickelnde, die sich einzeln dafür entscheiden |
| OS-Alias | git clone URL (fängt Aufrufe des Git-Binaries ab) | Ja | flottenweite Durchsetzung ohne Zutun der Entwickelnden |
Der Zero-Footprint-Modus ist nur das kompilierte Binary: herunterladen, ausführen, fertig. Keine Installation, keine PATH-Änderung, nichts aufzuräumen, also genau das Richtige, wenn der ganze Rechner ohnehin wegwerfbar ist. Der Git-Alias-Modus richtet einen Befehl git cloneusingpolicy für einen einzelnen Account ein, ohne Adminrechte. Der OS-Alias-Modus geht am weitesten: Er setzt sich im PATH vor das echte git, sodass jeder git clone auf diesem Rechner die Policy kennt, ob die ausführende Person davon weiß oder nicht.
Drei Beispielergebnisse der Optimierung
Es sind dieselben Ergebnisse wie bei Git Much Faster, nur landen sie jetzt automatisch statt auf Zuruf:
| Repository | Vollständiger History-Clone | Per Policy optimierter Clone |
|---|---|---|
| www.gitlab.com | 9,5 GB | 110 MB |
| Linux-Kernel | 7,5 GB | 2 GB |
| Chromium | 60 GB | 5 GB |
Auch das Sicherheitsverhalten hält der Live-Demo stand: OS-Alias installieren, ein schlichtes git clone gegen ein Repository mit Policy laufen lassen, und man bekommt die 110-MB-Fassung. Kommt bei demselben Befehl --depth 1 dazu, ignoriert der Interceptor ihn vollständig und reicht durch, Punkt. Deinstallieren, und git clone verhält sich wieder wie zuvor, ohne Rückstände.
Zusammenspiel mit Git LFS
Git LFS und diese Policy lösen zwei Hälften desselben Problems: LFS ändert, wie Binärdateien abgelegt werden, und hält deren Historie aus der Pack-Datei heraus, während die Clone-Policy ändert, wonach ein Clone überhaupt fragt. Weil sie auf verschiedenen Ebenen ansetzen, ergänzen sie sich, statt zu konkurrieren. In einem LFS-Repository trimmen die geringe Tiefe, die eingegrenzte Refspec und die abgestimmte Übertragung weiterhin all das, was LFS unangetastet lässt. Und weil sparse-checkout diese Dateitypen namentlich ausschließt, entfällt auch der Smudge-Download der aktuellen Binärdateien. Damit stellt sich das bedarfsgesteuerte Verhalten der Git-Variablen GIT_LFS_SKIP_SMUDGE ein, ganz ohne Client-Konfiguration. Beides zusammen wirkt: LFS verkleinert die Historie, die Policy verkleinert die Anfrage, und ein unter LFS bereits schlanker Clone wird noch schlanker.
Wie es weitergeht
Dieses Tutorial schließt den Kreis zum Anfang: Das Problem ist nicht auf Agenten beschränkt, aber Agenten sind der Anwendungsfall, an dem "sagt den Leuten einfach die richtigen Einstellungen" am schnellsten zerbricht. Policy as Code verlangt von niemandem, ob Mensch oder Agent, überhaupt davon zu wissen.
Wer tiefer einsteigen möchte: Git Clone Override Policy Architecture Overview zeigt Problem, Lösung und Entwurf, Git Clone Override Policy Demo die drei Betriebsarten in Aktion.
Die Git Clone Override Policy lässt sich am eigenen großen Repository ausprobieren. Und wer die Messungen hinter den Voreinstellungen sucht: Sie stammen aus Git Much Faster.
Sechs Möglichkeiten, DevOps-Kosten einzusparen, verraten wir hier.
Weitere Inhalte
Alle Blogbeiträge anzeigen
Feedback erwünscht
Hat dir dieser Blogbeitrag gefallen? Hast du Fragen oder Feedback? Erstelle ein neues Diskussionsthema im GitLab-Community-Forum und lass andere an deinen Eindrücken teilhaben.
Feedback teilen