Date de publication : 7 septembre 2026
Temps de lecture : 15 min
Évitez les coûts associés au clonage complet par défaut de l'historique
Découvrez comment Git Clone Override Policy automatise les optimisations de clonages superficiels et partiels via un fichier TOML stocké dans le dépôt afin de réduire la charge et les coûts.
Il est tentant de considérer git clone comme une opération côté client, mais les paramètres de cette opération ont un impact sur le serveur et sur tous les réseaux intermédiaires. Lorsque vous effectuez un clonage complet par défaut de l'historique, le serveur doit parcourir l'intégralité de l'historique, générer un fichier d'empaquetage (c'est ce que fait réellement le message « counting objects »), puis le transmettre par le réseau. Le client décompresse ensuite l'ensemble et extrait un arbre de travail complet. Chaque couche (CPU client, réseau, puissance de calcul du serveur Git pour la création du fichier d'empaquetage et disque) subit les conséquences de la taille de cette requête. Il vous suffit de réduire la taille de la requête pour alléger immédiatement les coûts liés à la pile, et pas seulement ceux de votre ordinateur portable.
L'IA agentique accentue cette pression d'une manière que les workflows habituels des équipes de développement ne permettent pas. Un agent effectuant des opérations sur un dépôt peut effectuer des clonages bien plus fréquemment, et de façon bien moins prévisible, qu'un être humain. Si le comportement par défaut est un clonage complet de l'historique, vous payez désormais ce coût à l'échelle de l'agent.
GitLab travaille activement sur le backend pour accélérer le traitement des grands dépôts. Mais vous pouvez également modifier vos requêtes. Des options telles que les clonages superficiels (--depth=1), les clonages sur une seule branche et les clonages partiels (--filter=blob:none) vous permettent de ne récupérer que ce dont un job a réellement besoin. Une requête plus précise réduit immédiatement les pics de charge, l'instabilité, le temps d'attente et les coûts. Et chaque amélioration future du backend vient s'ajouter à ces requêtes allégées.
Dans un article dédié à l'optimisation des workflows Git, nous avons expliqué comment Git Much Faster évalue les paramètres qui permettent de réduire les temps de clonage jusqu'à 93 % et l'utilisation du disque jusqu'à 98 % : désactivation de la compression, augmentation de la taille du tampon HTTP, clonages superficiels et partiels, et extraction clairsemée (sparse checkout) qui ignore les binaires. Ces résultats sont impressionnants, mais il y a toutefois un bémol : chaque endroit qui clone le dépôt doit être méticuleusement mis à jour avec de nombreuses lignes de code d'optimisation. L'ordinateur portable d'un développeur, un job CI, un agent démarrant un environnement sandbox : autant d'occasions d'oublier cette mise à jour.
Ce n'est pas de l'automatisation : c'est un pari sur la bonne volonté de chacun.
Dans cet article, vous apprendrez comment mettre en œuvre Git Clone Override Policy pour appliquer automatiquement les optimisations de clonage du dépôt et minimiser les coûts.
Les domaines où le coût du clonage explose
L'IA agentique exerce une pression qui ne cesse d'augmenter. Cependant, il ne s'agit pas du seul domaine où le clonage par défaut de l'historique complet coûte cher à l'industrie du développement logiciel :
- Monorepos : le regroupement de nombreux projets dans un seul dépôt signifie que chaque clonage récupère bien plus de données que ce dont une équipe a réellement besoin.
- Historique Git complexe et de longue durée : des années de commits alourdissent la taille totale du dépôt, même lorsque l'arbre actuel est modeste.
- Fichiers multimédias, binaires et projets intégrés : les images de micrologiciel, les kits de développement logiciel (SDK) fournisseurs et les ressources graphiques stockées directement dans le système de contrôle de version font gonfler un dépôt d'une manière que le code source seul ne pourrait jamais faire.
- Pipelines CI/CD : un clonage complet à chaque job, exécuté des milliers de fois par jour, transforme une petite inefficacité par clonage en une inefficacité récurrente importante.
- Jeux de données pour la science des données et le machine learning : les fichiers de données volumineux suivis dans Git doivent faire face au même problème de taille que n'importe quel autre blob surdimensionné.
- Environnements de développement à distance : les environnements de développement hébergés dans le cloud ou éphémères nécessitent un démarrage rapide et léger, mais reproduisent par défaut l'intégralité du dépôt.
- IA agentique : les requêtes de clonage sont beaucoup plus nombreuses, mais bien moins prévisibles que les workflows pilotés par un humain.
Quand l'optimisation est impossible à ignorer
La solution n'est pas de rédiger un meilleur fichier README indiquant quelles options utiliser, mais la suppression du processus de décision : il s'agit d'intégrer la politique dans le dépôt lui-même, sous forme de code, et de laisser un petit programme l'appliquer.
C'est exactement ce que fait Git Clone Override Policy. Il vous suffit de déposer un fichier .afullhistorycloneoverridepolicy.toml dans un dépôt, et un binaire Go léger intercepte uniquement un git clone URL « nu », soit la requête simple, par défaut, avec l'historique complet. Dès que vous ajoutez vous-même une option (--depth 1, --filter, ou autre), le binaire considère que vous procédez déjà à une optimisation et transmet votre commande telle quelle, sans la modifier. Aucun fichier de politique dans le dépôt ? Même processus : vous passez directement à un clonage normal. Le seul cas où le binaire intervient est celui que tout le monde s'accorde à considérer comme une erreur : la requête par défaut non qualifiée.
Lorsqu'il intervient, le binaire récupère le fichier de politique, puis exécute un processus fixe en 13 étapes qui effectue un clonage superficiel et partiel du dépôt, configure l'extraction clairsemée pour ignorer les fichiers binaires (images, archives, fichiers multimédias, polices, etc.) et applique la même configuration Git optimisée que celle décrite dans Git Much Faster, avant qu'une seule ligne de code source n'apparaisse sur le disque.
Aperçu d'une optimisation maximale
Examinons les commandes nécessaires pour optimiser au maximum un clonage Git.
1. Construisez vous-même le shell du dépôt, au lieu d'utiliser git clone.
Vous pourrez ainsi définir un large éventail de paramètres de configuration Git qui déterminent la portée des fichiers lors de la première requête de clonage.
      mkdir my-repo && cd my-repo
git init
git remote add origin https://example.com/group/my-repo.git
2. Ajustez la configuration Git pour les transferts volumineux, limitée à ce dépôt.
      git config --local core.compression 0
git config --local http.postBuffer 1024M
git config --local http.lowSpeedLimit 1000
git config --local http.lowSpeedTime 300
git config --local pack.windowMemory 256m
git config --local pack.packSizeLimit 256m
git config --local pack.threads 4
3. Activez le clonage partiel, puisque vous vous apprêtez à effectuer une récupération avec --filter.
      git config --local extensions.partialClone origin
git config --local remote.origin.promisor true
git config --local remote.origin.partialclonefilter blob:none
4. Limitez la spécification de référence de récupération à la seule référence dont vous avez besoin, au lieu de toutes les branches du dépôt distant.
git config --local remote.origin.fetch "+refs/heads/main:refs/remotes/origin/main"
Sans cette mise à jour, remote.origin.fetch est automatiquement défini sur +refs/heads/*:refs/remotes/origin/*, ce qui signifie que chaque opération de récupération (ainsi que le clonage initial) récupère les pointeurs de référence de toutes les branches du dépôt distant. Cette modification nous permet de restreindre les opérations de récupération à la seule branche main, de sorte que Git ne suivra plus ni ne mettra à jour les références des autres branches du dépôt distant.
Il y a moins de références à traiter et à mettre à jour, ce qui réduit la surcharge par opération de récupération, en particulier sur les dépôts comportant des centaines de branches.
5. Effectuez une récupération superficielle, avec le contenu des blobs différé.
git fetch --depth=1 --filter=blob:none origin main
Cette combinaison de profondeur et de filtre vous permet d'obtenir le transfert initial le plus petit possible : la structure de l'arborescence correspondant à un seul commit, sans aucune donnée de blob jusqu'à l'extraction des fichiers. Ce scénario est particulièrement utile lorsque vous travaillez sur des dépôts contenant des fichiers volumineux ou un historique important.
6. Activez l'extraction clairsemée et excluez tous les types de fichiers binaires dont vous n'avez pas besoin pour votre travail.
      git sparse-checkout init --cone
cat >> .git/info/sparse-checkout <<'EOF'
/*
!*.png
!*.PNG
!*.jpg
!*.JPG
!*.pdf
!*.PDF
!*.zip
!*.ZIP
!*.mp4
!*.MP4
!*.exe
!*.EXE
EOF
La politique réelle exclut plus de 30 extensions couvrant les images, les documents, les archives, les fichiers multimédias, les binaires compilés et les fichiers de conception, dans les deux cas. Il ne s'agit ici que d'un échantillon représentatif.
7. Consultez la référence.
git checkout main
Si vous suivez ces sept étapes, dans cet ordre exact, sur www.gitlab.com, vous obtiendrez 110 Mo au lieu de 9,5 Go. Si vous ne suivez pas l'ordre indiqué (et effectuez la récupération avant de restreindre la spécification de référence, ainsi que l'extraction clairsemée après l'extraction des fichiers plutôt qu'avant), vous aurez au mieux gaspillé l'optimisation ; au pire, vous aurez récupéré exactement ce que vous cherchiez à éviter. Cette précision, qui doit être répétée correctement à chaque clonage, par chaque personne et chaque pipeline, est exactement le problème de discipline évoqué dans l'introduction de cet article. Git Clone Override Policy n'invente pas de nouvelle technique. Elle garantit simplement que ces sept étapes s'exécutent, dans l'ordre et à chaque fois, sans que personne n'ait besoin de s'en souvenir.
L'automatisation à la rescousse
L'utilisation du client Git est à la fois très répandue et distribuée. Propager un ensemble précis et spécifique de commandes d'optimisation de clonage pour qu'elles soient exécutées par des humains ou codées en dur dans chaque job CI et environnement sandbox d'agent nécessite une automatisation pour garantir sa fiabilité.
Et si nous pouvions appliquer ce workflow à l'aide de politiques automatisées, plutôt que de parier sur le fait que chaque développeur se souvienne des sept étapes ? Il s'avère qu'il existe déjà une solution minimale viable fonctionnelle répondant exactement à ce besoin : un fichier de politique TOML qui réside dans le dépôt aux côtés du code, ainsi qu'un client capable d'intercepter chaque appel git clone avant qu'il n'atteigne le réseau. Il vous suffit d'enregistrer la politique une seule fois, et chaque clonage (humain, job CI ou agent) obtient automatiquement la séquence optimisée, sans avoir à la demander. L'utilisation d'un fichier de paramètres de politique permet également d'effectuer les ajustements qui seront nécessaires selon les usages. La configuration par défaut ci-dessus est destinée à compter des lignes de code, nous avons donc simplement besoin d'une copie fiable de tous les fichiers texte existants. La construction du même logiciel pourrait nécessiter davantage de fichiers, car certains éléments graphiques sont intégrés dans l'interface utilisateur de l'application, ou certains builds pourraient nécessiter davantage d'informations sur l'historique Git pour localiser les messages de commit dans les notes de release.
Un petit binaire Go portable et un fichier de configuration de politique stocké dans le dépôt
L'intercepteur lui-même est un binaire Go autonome, et non un script shell maintenu à grand renfort de sed. Ce choix offre plusieurs avantages notables.
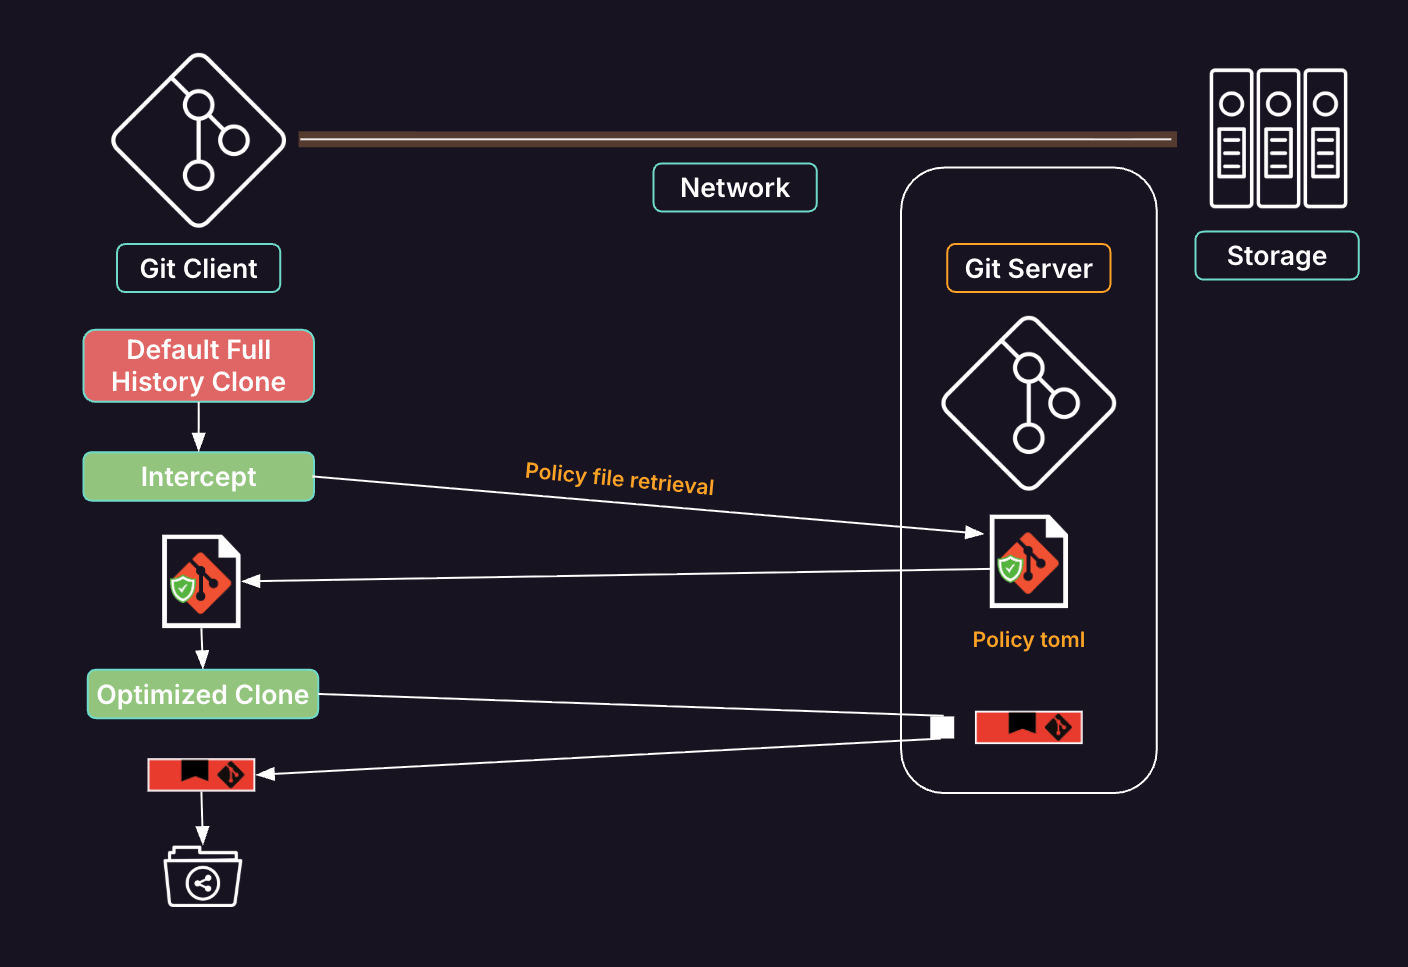
Il fonctionne sous Linux, macOS et Windows, aussi bien sur amd64 que sur arm64 : un seul code source au lieu d'une version bash et d'une version PowerShell séparées qui divergent. Il a été testé sur tous les shells que vous êtes susceptible de rencontrer, de CMD et PowerShell à Git Bash et WSL. La seule dépendance d'exécution est un véritable binaire git déjà présent dans le PATH.
En interne, il est organisé en six petits modules qui peuvent être testés de manière indépendante (analyse syntaxique de la politique, interpréteur à séquence fixe, exécution des commandes Git, journalisation, détection multiplateforme et point d'entrée gérant les quatre modes d'invocation), plutôt qu'une seule grande fonction effectuant tout cela à la fois.
Cet exemple de fichier de configuration donne un aperçu des paramètres qui peuvent actuellement être ajustés.
      schema_version = 2

[policyinfo]
description = "The most optimal latest-code-only clone for AI agents (that do not need git history) or counting lines of code."
OptimalForAIAgents = true

[git_config]
"core.compression"   = 0
"http.postBuffer"    = "1024M"
"http.lowSpeedLimit" = 1000
"http.lowSpeedTime"  = 300
"pack.windowMemory"  = "256m"
"pack.packSizeLimit" = "256m"
"pack.threads"       = 4

[fetch]
flags = ["--depth=1", "--filter=blob:none"]

[sparse_checkout]
enabled  = true
# conemode 'auto' is processed by the solution code to be either 'cone' or 'no-cone' when passed to git
conemode = "auto"
includes = ["/*"]
excludes = []
exclude_extensions = [
  "png", "jpg", "jpeg", "gif", "svg", "ico", "webp",
  "pdf", "doc", "docx", "xls", "xlsx", "ppt", "pptx",
  "zip", "tar", "gz", "jar",
  "mp4", "mp3", "mov",
  "exe", "dll", "so", "woff", "woff2",
  "ttf", "otf", "psd", "sketch", "fig", "dmg", "eps",
]
case_variants = "both"
La configuration déclarative plutôt que le code
L'Infrastructure as Code permet de réduire efficacement la complexité et d'améliorer la standardisation ainsi que la sécurité en condensant ce qui est habituellement un ensemble disparate de code en un fichier de configuration déclaratif et un moteur qui le traite. Ce modèle très efficace est reproduit ici pour tous ses avantages, notamment :
- La standardisation des processus peu répandus (commandes Git exceptionnellement détaillées)
- La réduction de la complexité
- L'adoption facile par le code de clonage spécialisé existant (par exemple, les « clonages » VS Code qui n'utilisent pas le binaire Git)
- La réduction des bogues et des cas limites (par rapport à ce que chacun élabore de son côté)
- La cohérence de l'implémentation selon les contextes (clonages CI, IDE des équipes de développement, environnements sandbox d'IA)
- L'amélioration de l'auditabilité
- La génération et la manipulation de fichiers de configuration par d'autres automatisations
- Le renforcement de la sécurité (en évitant de nombreux vecteurs d'injection de code)
L'interpréteur ne peut agir que sur la configuration : paires clé/valeur de configuration Git, indicateurs de récupération et d'extraction, listes d'inclusion/d'exclusion pour l'extraction clairsemée, et un petit ensemble de hooks post-clonage contrôlés par des prédicats simples. Tout ajout arbitraire à la configuration est inconnu du moteur et ignoré. Vous pouvez auditer exactement ce qu'une politique fera simplement en la lisant.
Trois façons d'utiliser Git Clone Override Policy, de la moins invasive à la plus invasive
| Mode | Commande | Droits admin requis | Idéal pour |
|---|---|---|---|
| CLI sans empreinte | ./git-clone-override-policy clone URL | Non | Jobs CI, agents, machines ponctuelles |
| Alias Git | git cloneusingpolicy URL | Non | Développeurs (adoption individuelle) |
| Alias OS | git clone URL (intercepte les appels au binaire Git) | Oui | Application à l'ensemble du parc sans que les équipes de développement s'en rendent compte |
Le mode sans empreinte se résume au binaire compilé : téléchargez-le et exécutez-le. Pas d'installation, pas de modification du PATH, rien à nettoyer, exactement ce qu'il faut quand la machine entière est jetable. Le mode alias Git installe une commande git cloneusingpolicy pour un seul utilisateur, sans droits d'administration nécessaires. Le mode alias OS va plus loin : il s'installe en amont du véritable git dans le PATH du système, de sorte que chaque git clone sur cette machine respecte la politique, que la personne qui l'exécute connaisse ou non son existence.
Trois exemples de résultats issus de l'optimisation de Git Clone Override Policy
Les résultats sont les mêmes que ceux présentés dans Git Much Faster. Ils s'appliquent désormais automatiquement, sans qu'il soit nécessaire d'en faire la demande :
| Dépôt | Clone de l'historique complet | Clone optimisé par la politique |
|---|---|---|
| www.gitlab.com | 9,5 Go | 110 Mo |
| Noyau Linux | 7,5 Go | 2 Go |
| Chromium | 60 Go | 5 Go |
Le comportement de sécurité fonctionne parfaitement lors d'une démonstration en direct : installez l'alias OS, exécutez git clone sur un dépôt soumis à la politique, et vous obtenez la version de 110 Mo. Ajoutez --depth 1 à cette même commande, et l'intercepteur l'ignore complètement : il laisse passer la commande, point final. Désinstallez l'alias, et git clone revient à un clonage standard, sans aucune trace.
Des bénéfices cumulés avec Git LFS
Git LFS et cette politique résolvent deux aspects distincts d'un même problème : Git LFS modifie la façon dont les binaires sont stockés, en conservant leur historique hors du fichier d'empaquetage, tandis que la politique de clonage modifie ce que chaque clonage demande. Comme ils opèrent sur des couches différentes, ils se complètent plutôt qu'ils ne s'excluent. Sur un dépôt Git LFS, la profondeur réduite de la politique, la spécification de référence sur une seule branche et l'optimisation des transferts réduisent encore tout ce que Git LFS laisse intact. Et comme sparse-checkout exclut ces types de fichiers par leur nom, il ignore également le téléchargement smudge des binaires actuels. Vous profitez ainsi du comportement à la demande de la variable de configuration Git standard GIT_LFS_SKIP_SMUDGE sans aucune configuration côté client. Les résultats sont cumulés : Git LFS réduit la taille de l'historique, la politique réduit la taille de la requête, et un clonage de taille réduite sous Git LFS s'allège encore davantage.
Perspectives
Cet article nous ramène au point de départ : le problème n'est pas propre aux agents, mais ce sont eux qui mettent le plus vite en échec l'idée qu'il suffirait de communiquer les bons paramètres. Avec la politique en tant que code, ni les équipes ni les agents n'ont besoin de savoir qu'elle existe.
Pour aller plus loin, découvrez l'architecture de Git Clone Override Policy pour comprendre comment le problème et la solution ont été conçus, ainsi qu'une démo pour voir les trois modes d'exécution en action.
Essayez Git Clone Override Policy sur votre propre dépôt volumineux. Et si vous souhaitez consulter les tests de performance à l'origine des paramètres par défaut, consultez Git Much Faster.
En savoir plus
Afficher tous les articles du blog
Donnez-nous votre avis
Cet article de blog vous a plu ? Vous avez des questions ou des retours ? Donnez votre avis en créant un nouveau sujet sur le forum de la communauté GitLab.
Faites-nous part de vos commentaires